Das können Sie danach
- Beobachtbare Abnahmekriterien schreiben und einfrieren, bevor der Build beginnt.
- Jedes Kriterium in eine Journey mit Vorbedingungen und beobachtbaren Schritten übersetzen.
- Die Testumgebung in einem eigenen Schritt vorbereiten und nachweisen, bevor der Tester loslegt.
- Die Journeys mit Playwright MCP ausführen und den Bericht anhand seiner Urteile lesen.
- Einen Loop aus Fix und erneutem Lauf aufsetzen, in dem niemand den eigenen Fix bestätigt.
Das Wichtigste
- Bei agentengesteuerten Abnahmetests durchläuft ein KI-Agent jede User Journey in der laufenden App und fällt pro eingefrorenem Abnahmekriterium ein Urteil.
- Frieren Sie die Kriterien ein, bevor es Code gibt, und geben Sie jedem Kriterium genau eine Journey, die es wörtlich zitiert.
- Der Agent, der testet, repariert nie: Ein Fehlschlag geht zurück in den Build, und nur ein vollständiger erneuter Lauf zählt als Beweis.
- BLOCKED ist ein Urteil, keine Lücke, die man versteckt; lesen Sie es vor FAIL.
- Diese Ebene ersetzt keine CI; sie findet die Fehler, die zwischen Ebenen liegen, die jede für sich bestanden haben.
Was Abnahmetests mit Playwright MCP hier leisten
Agentengesteuerte Abnahmetests sind ein Prüf-Loop, in dem ein KI-Agent jede User Journey in einem echten Browser durchläuft und anhand eingefrorener Abnahmekriterien meldet, ob sie bestanden ist oder nicht. API- und MCP-Journeys laufen genauso ab, als echte Aufrufe gegen die laufende App.
Ein Test, den der bauende Agent für sich selbst schreibt, beweist nichts. Wir wollen ein Urteil von einem Agenten, der nur die Kriterien liest und das Produkt bedient. Nachdem Claude Code ein Feature gebaut hat, geht ein zweiter Agent jede Journey mit Playwright MCP durch und hält jede entscheidende Beobachtung per Screenshot fest. ConvOps steuert die Schritte, die Gates und den Fix-Loop. Er ist einer der Loops, mit denen wir unser Unternehmen führen.
Alle Beispiele nutzen Quillbay, eine fiktive Buchungs-App für Töpferstudios, und ihre neue Warteliste für ausgebuchte Kurse.
| Das ist es nicht | Warum |
|---|---|
| User Acceptance Testing (UAT) | Dort geben Fachanwender frei; hier prüft ein Agent bereits freigegebene Kriterien |
| Das Testen eines KI-Agenten | Der Agent ist der Tester, nicht der Prüfling |
| Kriterien, die zu Testcode werden | Das endet in einer .spec.ts-Datei. Dies endet in einem Urteil pro Journey, mit Belegen |
| Teil | Was es ist |
|---|---|
| Auslöser | Die Build-Schritte eines Plans sind abgeschlossen. Kein Zeitplan |
| Eingaben | Eingefrorene Abnahmekriterien, der Journey-Plan, die laufende App in ihrer eigenen Branch-Umgebung |
| Ergebnisse | Ein Bericht mit einem Urteil pro Journey, Screenshots und einer Empfehlung: PROCEED oder FIX REQUIRED |
Warum wir ihn gebaut haben: grüne Ebenen, kaputte Journeys
Grüne Unit-Tests sagen Ihnen, dass die Teile funktionieren. Ob eine Person ihre Aufgabe auf dem Bildschirm zu Ende bringen kann, sagen sie nicht.
Vor diesem Loop bestand jede untere Ebene: Unit-Tests, Phasen-Reviews, die Regressionssuite in der Merge-Pipeline. Dann scheiterte der erste agentengesteuerte Lauf der Journeys gegen die echte App trotzdem an einem großen Teil davon. Die Fehler lagen zwischen den Ebenen: ein Link, den ein Service erzeugt und ein anderer liest, eine Weiterleitung, die einen Parameter verlor. Keine Ebene war für die Nahtstelle zuständig, also fing keine sie ab.
Daraus entstanden zwei Überzeugungen. Wer baut, kann nicht urteilen, deshalb schreibt und repariert der Tester nie Code. Und nur ein Lauf gegen die echte App beweist ein Kriterium.
Wenn die Features Ihrer Agenten jede Prüfung bestehen und auf dem Bildschirm trotzdem kaputtgehen, sehen Sie sich an, wie ConvOps einen Plan von eingefrorenen Kriterien bis zum verifizierten Build führt(wird in einem neuen Tab geöffnet).
So läuft es: sechs Schritte und vier Agenten
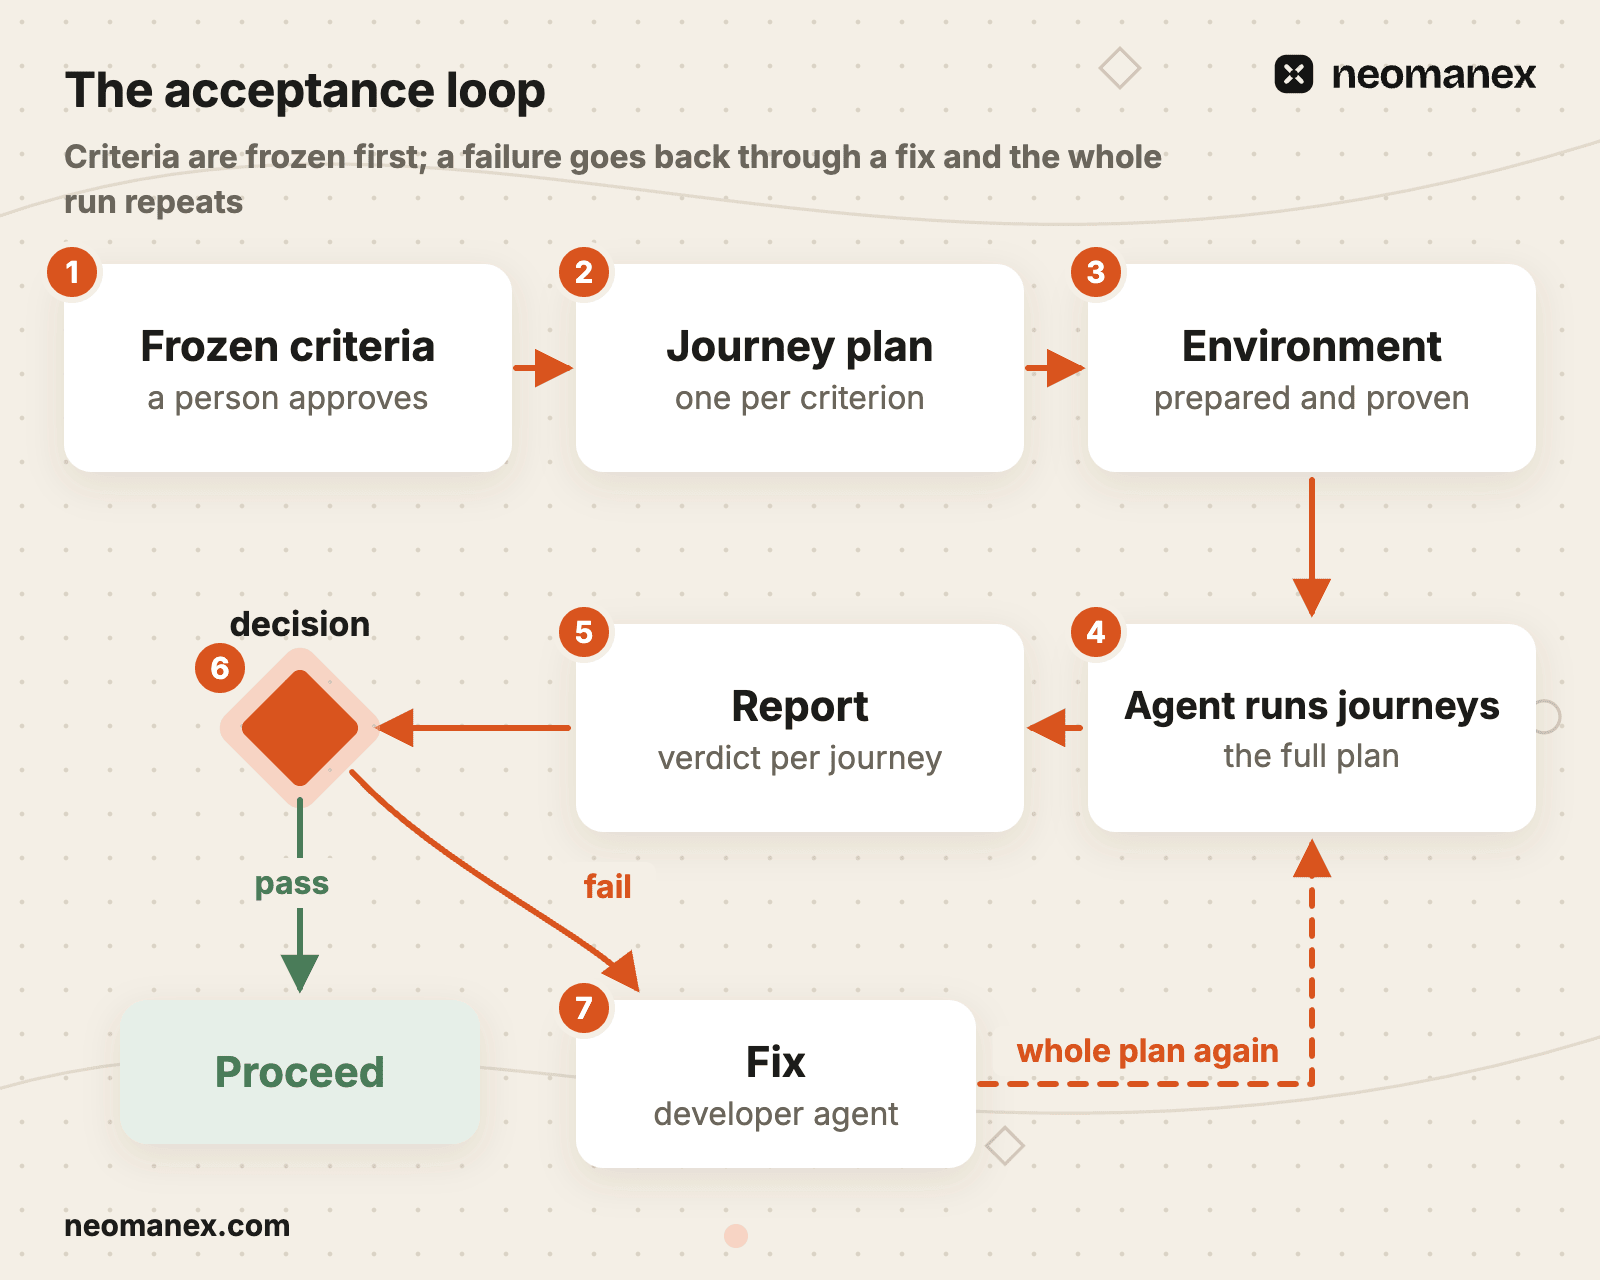
Die Reihenfolge der Schritte ist die Absicherung. Die Kriterien werden eingefroren, bevor Code existiert, die Umgebung ist nachweislich grün, bevor der Tester ankommt, und die Entscheidung trifft jemand, der den Fix nicht geschrieben hat.
| # | Schritt | Wer ihn ausführt | Gate |
|---|---|---|---|
| 1 | Kriterien schreiben | Mit dem Plan entworfen, von einer Person freigegeben | Die Freigabe friert die Liste ein |
| 2 | Journeys planen | Testplaner | Keins |
| 3 | Umgebung vorbereiten | Infrastruktur-Agent | Nur bei Grün, dann gibt eine Person frei |
| 4 | Journeys ausführen | Abnahmetester | Eine Person gibt den Bericht frei |
| 5 | Entscheiden | Entscheidungsschritt | Bestanden, oder nicht bestanden und weiter zum Fix |
| 6 | Fehlschläge beheben | Entwickler-Agent | Keins |
Claude Code baut das Feature zwischen Schritt 2 und 3.
Kriterien schreiben. Jedes Kriterium nennt einen Akteur, ein Verhalten und etwas, das man beobachten kann: einen Bildschirm, eine Meldung, eine Antwort. „Code ist vorhanden“ ist nie ein Kriterium, denn was man nicht beobachten kann, kann man nicht abnehmen. Die Freigabe friert die Liste ein: Spätere Schritte fügen keines hinzu, streichen keines und deuten keines um.
Journeys planen. Eine Journey pro Kriterium, das wörtlich zitiert und mit seiner ID genannt wird, sodass jedes Kriterium genau eine Stelle hat, an der es bewiesen wird.
Umgebung vorbereiten. Ein eigener Infrastruktur-Agent startet die Branch-Umgebung des Plans, stellt Daten und Credentials über den Mechanismus des Plans bereit und hält sie fest. Das Gate hängt am Grün, nicht am Aufwand. Der Tester bereitet nichts vor, also kann er nicht bestehen, indem er sich einen leichten Fall selbst baut.
Ausführen, entscheiden, beheben. Der Abnahmetester durchläuft die Journeys und repariert nie etwas. Ein Fehlschlag schickt den Bericht an den Entwickler-Agenten, der die Fixes auf demselben Branch committet, und der ganze Plan läuft erneut.
Der Loop hat keinen Timer: Er läuft nach dem Build jedes Plans und bei einem Task immer dann, wenn sich eine Journey geändert hat. Ein Lauf auf Task-Ebene leitet 3 bis 8 Journeys ab: den Happy Path plus den riskantesten Fehlerpfad je geändertem Verhalten. Überspringen ist nur erlaubt, wenn es keine Journey zu durchlaufen gibt (ein reines Refactoring, Tooling, Doku, Konfiguration oder reine Teständerungen), und der Grund wird genannt. Im Zweifel wird ausgeführt.
Microsofts Playwright Test Agents(wird in einem neuen Tab geöffnet) (Planner, Generator, Healer) erzeugen und reparieren Testcode. Unsere Agenten erzeugen aus eingefrorenen Anforderungen einen Plan und einen Bericht mit Urteilen. Die Gates funktionieren wie in So bauen wir ein selbstverbesserndes KI-System, und die Freigaben sind Human-in-the-Loop-Gates.

Ein Lauf Schritt für Schritt: die Quillbay-Warteliste
Der spannende Moment ist nicht das erste FAIL. Es ist der erneute Lauf nach dem Fix, denn der Entscheidungsschritt akzeptiert keinen anderen Beweis.
Auslöser. Die Build-Schritte von plan/waitlist sind abgeschlossen. Die Kriterien FR-1 bis FR-4 wurden eingefroren, bevor es Code gab.
Der Plan. Journey U2 nennt FR-2 und zitiert es: „Wird ein Platz frei, erhält die erste Person auf der Warteliste eine E-Mail, deren Link den Kurs öffnet, wobei der Platz 2 Stunden lang reserviert bleibt.“ Jede Vorbedingung sagt, wie man sie bestätigt: Der Kurs acc-wl-r7-class-wheel-basics ist mit 8 von 8 Plätzen ausgebucht (die Seite zeigt „Full“ ausgebucht und die Schaltfläche „Join waitlist“ auf die Warteliste), beide Teilnehmer können sich bei Quillbay anmelden, und ausgehende Mails landen im Capture-Postfach.

Vorbereiten. Der Infrastruktur-Agent weist nach, dass wl-waitlist.app.quillbay.example.com und die zugehörige API grün sind, und hält die Teilnehmer-Fixtures und den Schlüssel der Studioinhaberin zur Wiederverwendung fest.
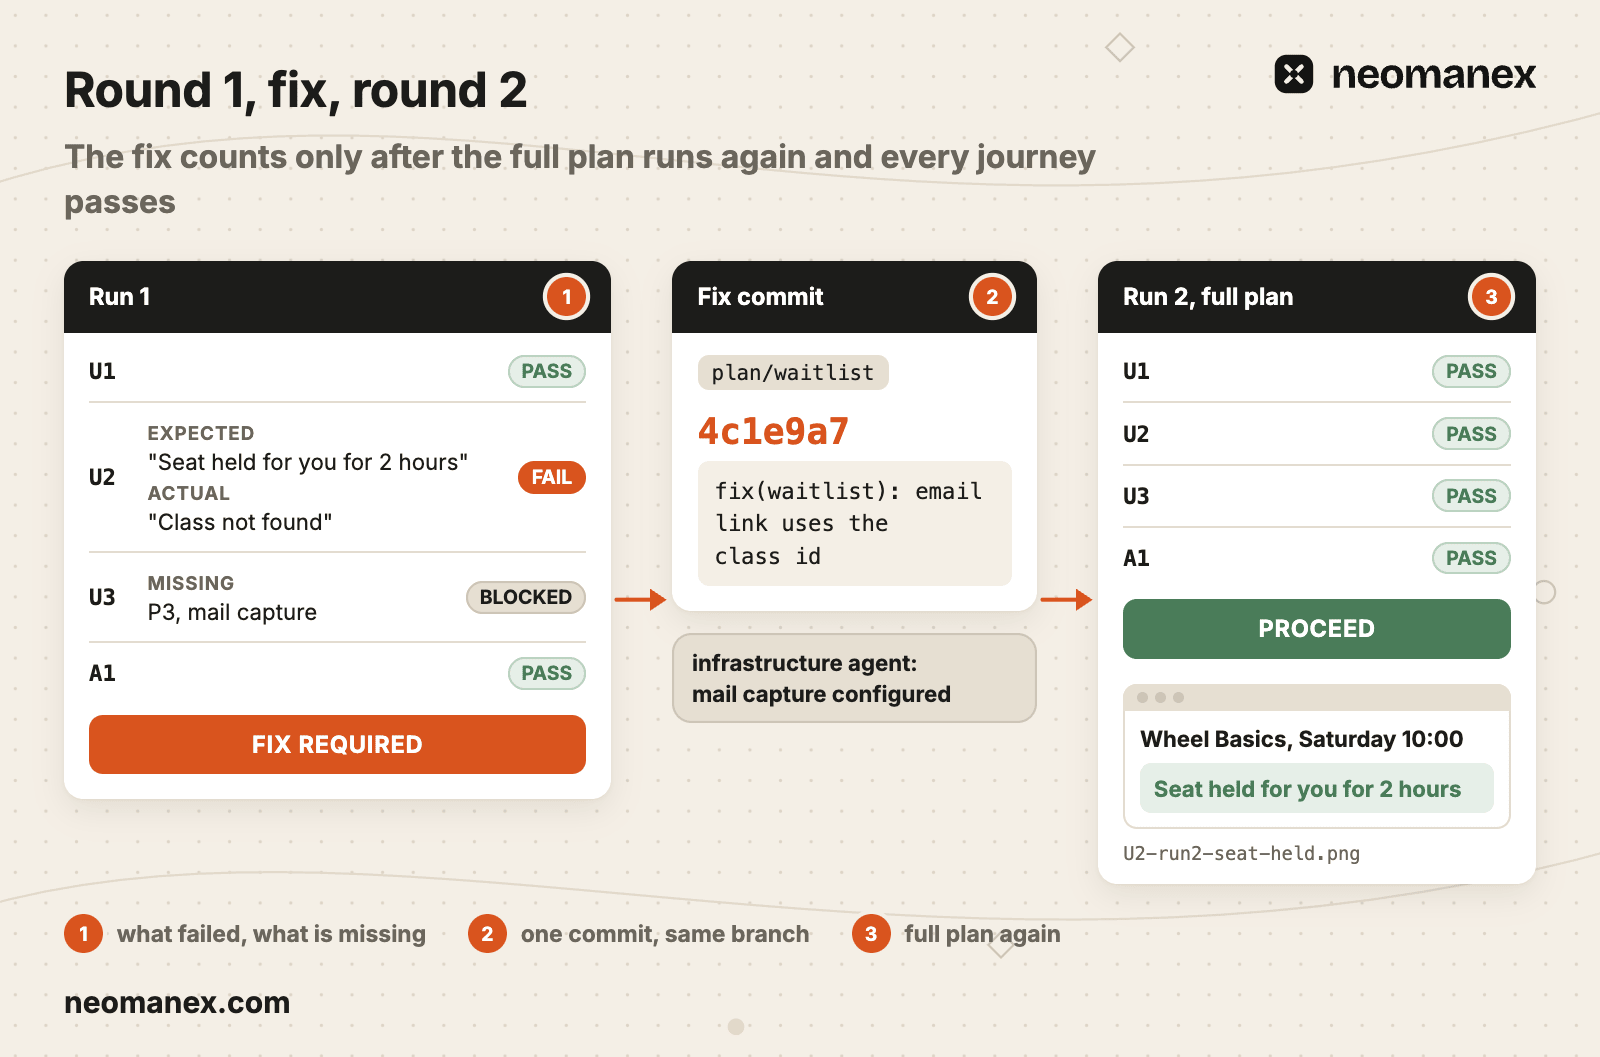
Lauf 1. Der Abnahmetester durchläuft vier Journeys bei 1440x900 und prüft layoutrelevante Bildschirme noch einmal bei 390x844.
| Journey | Urteil | Was er gesehen hat |
|---|---|---|
| U1 | PASS | „You are #1 on the waitlist“ (Sie sind Nr. 1 auf der Warteliste) |
| U2 | FAIL | Der E-Mail-Link öffnet „Class not found“ (Kurs nicht gefunden): Er enthält die ID des Wartelisteneintrags, nicht die Kurs-ID |
| U3 | BLOCKED | P3 fehlt: kein Mail-Capture in der Branch-Umgebung, im Kopfbereich benannt |
| A1 | PASS | GET /v1/classes/{id}/waitlist als Inhaberin liefert 200 mit Teilnehmer A auf Position 1 |
Empfehlung: FIX REQUIRED. U2 ist eine Nahtstelle: API und App bestehen jeweils ihre Unit-Tests, und nur die Journey führt durch beide.
Entscheiden. Eine Person gibt den Bericht frei, und die Entscheidung lautet: nicht bestanden. U2 betrifft Code, den dieser Plan ausgeliefert hat, also wird er auf dem Branch behoben und nicht als Ticket abgelegt.
Beheben. Der Entwickler-Agent reproduziert U2 in derselben Umgebung, ändert den Link, führt den Unit-Test für die geänderte Datei aus und committet fix(waitlist): email link uses the class id (4c1e9a7) auf plan/waitlist. Der Infrastruktur-Agent richtet das Mail-Capture ein.
Lauf 2. Der ganze Plan läuft erneut: alle vier Journeys, nicht nur U2 und U3. Alle bestehen, und der Screenshot von U2 zeigt „Seat held for you for 2 hours“ (Ihr Platz ist 2 Stunden für Sie reserviert). Empfehlung: PROCEED. Die Entscheidung lautet: bestanden, und der Bericht fließt in den Verifikationsabschnitt des Merge-Requests ein.
So sieht der Bericht aus, und so lesen Sie ihn
Lesen Sie BLOCKED vor FAIL. Eine Journey, die niemand durchlaufen konnte, verbirgt am ehesten einen echten Fehler.
| Teil | Was er enthält |
|---|---|
| Kopfbereich | Lauf, vorheriger Lauf mit Zahlen, Branch und Head, Hosts, Viewports, Urteil |
| Pflichtangaben im Kopfbereich | Alles, was der Lauf nicht testen konnte, jeweils benannt. Lauf 1: „P3 Mail-Capture nicht konfiguriert: U2 und U3 hängen davon ab“ |
| Journey-Ergebnisse | Eine Zeile pro Journey, vorheriger Lauf neben dem aktuellen, Belegbilder |
| Fehlschläge im Detail | Schritt, erwartet, tatsächlich, Beleg, empfohlener Fix |
| Regressions-Checkliste | Einen nicht ausgebuchten Kurs zu buchen funktioniert weiterhin. Eine Stornierung gibt den Platz weiterhin frei |
| Empfehlung | PROCEED oder FIX REQUIRED |
| Urteil | Bedeutung |
|---|---|
| PASS | Jeder Schritt wurde so beobachtet, wie das Kriterium es beschreibt |
| PARTIAL PASS | Die Journey funktioniert, aber eine genannte Beobachtung trifft nicht vollständig zu |
| FAIL | Das tatsächliche Ergebnis eines Schritts weicht vom erwarteten ab |
| BLOCKED | Die Journey konnte nicht durchlaufen werden; was fehlte, wird benannt |
| COVERED BY SUITE | Durch einen automatisierten Regressionstest belegt, den der Bericht nennt, und nicht erneut durchlaufen |
Unsere Pläne enthalten noch eine Regel: Ein Schritt, der eine undokumentierte Voraussetzung, einen zweiten Versuch oder eine manuelle Nachbesserung brauchte, ist ein FAIL, auch wenn das Verhalten am Ende funktioniert hat. Was nur mit Hilfe besteht, besteht für Nutzer nicht. Und ein PASS, dessen Screenshot das geprüfte Element nicht zeigt, ist kein Beleg: Wer das Urteil abnimmt, öffnet die Bilder.

Was schiefgeht: Nahtstellen, für die keine Ebene zuständig war
Die meisten unserer Abnahmefehler waren keine Bugs, die das Modell übersehen hat. Es waren Nahtstellen zwischen Ebenen, für die keine Ebene zuständig war.
Der wichtigste Fall hat die Form von Quillbays U2: Ein erster Abnahmelauf scheitert an einem großen Teil der Journeys, während jede untere Ebene grün ist, und jeder Fehler liegt zwischen den Ebenen. Die Regel daraus: Abnahmetests in einer echten Umgebung laufen lassen, bevor die Review-Schritte teuer werden, und für jeden Plan mit UI-, API- und MCP-Oberfläche einen zweiten vollständigen Lauf einplanen.

| Fehlschlag | Regel daraus |
|---|---|
| Fix-Runden brachten Regressionen, die der nächste Lauf fand. Bei Quillbay würde ein U2-Fix, der nebenbei die Kursseite aufräumt, U1 kaputtmachen | Nur die gemeldeten Fehlschläge beheben, kein Aufräumen. Der vollständige erneute Lauf findet, was ein Fix kaputtgemacht hat, und eine Person entscheidet, wann die Schleife endet |
| Zwei Sessions teilten sich einen Playwright-MCP-Browser. Die andere Session navigierte den Tab mitten in der Journey weg, und der beobachtete Zustand war verschwunden | Jede Session steuert ihren eigenen Browser-Kontext oder ein eigenständiges Playwright-Skript, findet ihre Seite bei jedem Aufruf neu und prüft die URL vor dem Lesen |
| Eine Journey bestand auf dem Dev-Server und zeigte nach dem Build veralteten Inhalt | Journeys, die von Prerendering oder Cache-Modus abhängen, laufen auf einem gebauten Image oder einer deployten Umgebung: Ein Dev-Server rendert jede Anfrage frisch |
| Fehlende Konfiguration ließ eine Journey über mehrere Läufe auf BLOCKED stehen, und dahinter versteckte sich ein weiterer Fehler | BLOCKED ist ein Urteil, das das Fehlende im Kopfbereich benennt. Der Lauf täuscht nie ein Bestehen vor |
| Ein Plan enthielt Prüfungen, die die Umgebung nie erfüllen konnte: eine Regel, die auf main schon verletzt war, ein Login, den die Umgebung nicht hatte | Der Testplaner gleicht jede Journey mit dem ab, was die Umgebung tatsächlich kann |
Finden und Beheben als getrennte Jobs ist auch das Rückgrat unseres Loops für die selbstheilende Website.
Selbst bauen: die Anweisungen, die jeder Agent erhält
Beginnen Sie mit den Kriterien und der Regel „nie reparieren“. Playwright MCP ist der einfache Teil. Der Tester dient der Verifikation, nicht der Fehlersuche: Erst debuggen, dann die Abnahmetests einmal laufen lassen, sobald Sie glauben, dass der Build funktioniert. Die Schritte unten geben die Reihenfolge vor; hier sind die Anweisungen zum Kopieren.
Testplaner: die Journey-Vorlage.
Für jedes eingefrorene Kriterium EINE Journey schreiben:
  ID: U<n> (UI) oder A<n> (API/MCP)
  Kriterium: <FR id>, wörtlich zitiert
  Vorbedingungen: jeweils mit „So bestätigen“.
    Eine fehlende ist ein Blocker, kein Workaround.
  Schritte: nummeriert; jeder nennt, was beobachtet wird.
  Viewports: 1440x900; jeden layoutrelevanten Bildschirm
    bei 390x844 erneut prüfen.
  Fixtures: Präfix acc-<plan>-<run>-; nach dem Lauf aufräumen.
Jede Journey mit dem abgleichen, was die Umgebung
tatsächlich kann.
Infrastruktur-Agent: vorbereiten und prüfen.
Die Branch-Umgebung des Plans vorbereiten, dann nachweisen,
dass sie grün ist.
1. Jeden Service starten, den der Plan berührt. Alle müssen laufen.
2. Daten und Credentials NUR über den Mechanismus des Plans
   bereitstellen. Kein Mechanismus: anhalten und nachfragen.
   Die Credentials für den Tester festhalten.
3. Prüfen:
   - Health liefert 200
   - ein ECHTER Daten-Endpoint liefert 2xx, nicht nur Health
   - Aufruf ohne Authentifizierung: 401/403; mit: 2xx
     (MCP: tools/list UND ein authentifizierter Tool-Aufruf)
   - 3-5 zentrale Seiten per Playwright: keine Konsolenfehler,
     keine fehlgeschlagenen Requests, keine leeren Bildschirme
   - der Hauptablauf funktioniert einmal von Anfang bis Ende
4. Beheben, was rot ist, erneut prüfen, nur bei Grün weiter.
   Produktfehler mit Fundstelle und Beleg melden.
Die Journeys nicht ausführen. Nichts abbauen.
Abnahmetester: ausführen und berichten.
Die Umgebung ist vorbereitet und läuft. Die festgehaltenen
Credentials wiederverwenden. Nichts starten oder abbauen.
Jede UI-Journey mit Playwright MCP ausführen, jede
API/MCP-Journey mit echten Aufrufen, danach die
Regressions-Checkliste.
Dem Plan der Reihe nach folgen. Nie Code reparieren. Nie
einen Fehlschlag überspringen. Keine improvisierten Tests.
Jede Beobachtung, die über einen Schritt entscheidet, per
Screenshot festhalten. API-Antworttexte protokollieren.
Urteil pro Journey: PASS, PARTIAL PASS, FAIL, BLOCKED,
COVERED BY SUITE.
Bericht: Kopfbereich; Pflichtangaben im Kopfbereich (was
nicht getestet werden konnte, jeweils benannt);
Journey-Ergebnisse; Fehlschläge im Detail (Schritt, erwartet,
tatsächlich, Beleg, empfohlener Fix); Regressions-Checkliste;
Empfehlung: PROCEED oder FIX REQUIRED.
Entscheidungsregel.
PASS nur, wenn jede Journey PASS ist oder eine akzeptierte
Ausnahme: ein Fehlschlag in Code, den diese Änderung nicht
ausgeliefert hat, als eigenes Ticket erfasst und per ID zitiert.
Alles andere ist FAIL: den Bericht an den Fix schicken, dann
den GANZEN Plan erneut ausführen.
Ein Fehlschlag in Code, den diese Änderung ausgeliefert hat,
wird auf dem Branch behoben, nie als eigenes Ticket abgelegt.
Unklar, ob ein Verhalten beabsichtigt ist? Eine Person entscheidet.
Entwickler-Agent: beheben.
Für jede fehlgeschlagene Journey: in derselben Umgebung
reproduzieren, die Ursache finden, beheben, die Journey
live erneut durchlaufen.
Nur beheben, was die Fehlschläge erfordern. Keine
Kleinigkeiten, kein Aufräumen.
Unit- und Lint-Checks nur für die geänderten Dateien ausführen.
Auf demselben Branch committen. Festhalten, was sich geändert
hat und warum.
Nie den eigenen Fix bestätigen: Der erneute Lauf ist der Beweis.
Diese Ebene ersetzt keine CI: Unit-, Integrations- und Regressionstests bleiben das deterministische Gate in der Merge-Pipeline.
Schritte
Beobachtbare Kriterien schreiben und einfrieren
Geben Sie jedem Kriterium einen Akteur, ein Verhalten und etwas, das man auf dem Bildschirm oder in einer Antwort beobachten kann. Die Freigabe durch eine Person friert die Liste ein; eine Änderung des Umfangs geht zurück zu diesem Schritt.
Eine Journey pro Kriterium schreiben
Zitieren Sie das Kriterium wörtlich, nennen Sie seine ID, listen Sie die Vorbedingungen samt Bestätigungsweg auf und legen Sie für jeden Schritt eine Beobachtung fest.
Die Umgebung in einem eigenen Schritt vorbereiten
Ein Infrastruktur-Agent stellt Daten und Credentials über den Mechanismus des Plans bereit und weist Health, einen echten Daten-Endpoint, die Authentifizierung in beide Richtungen und grüne Schlüsselseiten nach, bevor jemand testet.
Die Journeys mit einem eigenen Tester ausführen
Geben Sie dem Abnahmetester Playwright MCP in einem eigenen Browser-Kontext, echte Aufrufe für API-Journeys und zwei Regeln: nie reparieren, nie überspringen.
Den Bericht lesen und entscheiden
Lesen Sie zuerst die BLOCKED-Zeilen. Bestanden nur, wenn jede Journey PASS ist oder eine akzeptierte Ausnahme, die als eigenes Ticket erfasst ist.
Auf dem Branch beheben, dann alles erneut ausführen
Der Entwickler-Agent behebt nur die gemeldeten Fehlschläge und committet auf demselben Branch. Der ganze Plan läuft erneut; niemand bestätigt den eigenen Fix.
Häufige Fragen
Was sind agentengesteuerte Abnahmetests?
Agentengesteuerte Abnahmetests sind ein Prüf-Loop, in dem ein KI-Agent jede User Journey in einem echten Browser durchläuft und anhand eingefrorener Abnahmekriterien meldet, ob sie bestanden ist oder nicht. ConvOps führt ihn als Workflow-Schritte aus: Eine Person friert die Kriterien ein, ein Testplaner schreibt eine Journey pro Kriterium, ein separater Abnahmetester durchläuft sie mit Playwright MCP, und jeder Fehlschlag wird auf dem Branch behoben, bevor der ganze Plan erneut läuft.
Für wen sind agentengesteuerte Abnahmetests gedacht?
Agentengesteuerte Abnahmetests sind für Engineering-Leads und Gründer gedacht, die Features mit Coding-Agenten wie Claude Code ausliefern. ConvOps führt sie nach dem Build jedes Plans aus, sodass jedes von einer Person freigegebene Kriterium an der laufenden App bewiesen ist, mit einem Screenshot pro entscheidender Beobachtung, bevor der Merge-Request geprüft wird.
Lassen sich KI-Agenten in der QA einsetzen?
Ja, als Journey-Ebene. In ConvOps durchläuft ein Abnahmetester-Agent jede User Journey mit Playwright MCP und jede API-Journey mit echten Aufrufen und meldet dann pro Journey ein Urteil mit Belegen. Er repariert nie Code und überspringt nie einen Fehlschlag. Die Regressionssuite in der CI bleibt das deterministische Gate, und eine Person liest den Bericht vor der Entscheidung.
Ist Playwright MCP für Abnahmetests zuverlässig?
Ja, als Werkzeug, unter zwei Bedingungen. ConvOps weist nach, dass die Umgebung grün ist, bevor der Tester ankommt, und jede Session steuert ihren eigenen Browser-Kontext, findet ihre Seite bei jedem Aufruf neu und prüft die URL vor dem Lesen. Ein gemeinsam genutzter Browser verliert seinen Zustand, wenn eine andere Session im Tab navigiert. Jede entscheidende Beobachtung bekommt einen Screenshot, der das geprüfte Element zeigt.
Wie bringe ich einen KI-Coding-Agenten dazu, seinen eigenen Code in einem echten Browser zu testen?
Fügen Sie den ConvOps-MCP-Server unter https://mcp.convops.app/ zu Ihrem KI-Client hinzu und melden Sie sich einmal an. Schreiben Sie dann beobachtbare Abnahmekriterien und frieren Sie sie ein, lassen Sie einen Testplaner eine Journey pro Kriterium schreiben und geben Sie einem zweiten Agenten Playwright MCP, um sie zu durchlaufen. Wer baut, bewertet nie die eigene Arbeit: Fehlschläge werden auf dem Branch behoben, und der ganze Plan läuft erneut.
Ersetzen agentengesteuerte Abnahmetests den UAT durch Menschen?
Nein. In ConvOps prüft der Agent gegen Kriterien, die eine Person vor dem Build freigegeben hat, und eine Person liest und genehmigt jeden Bericht. Ein Befund, bei dem niemand weiß, ob das Verhalten beabsichtigt ist, geht vor der Entscheidung über bestanden oder nicht bestanden an eine Person. Der Agent urteilt über das, was er beobachtet hat, nie über die Absicht.
Ersetzen Abnahmetests mit einem KI-Agenten die CI-Tests?
Nein. In ConvOps-Plänen laufen Unit-Tests, Integrationstests und die Regressionssuite in der Merge-Pipeline als deterministisches Gate. Agentengesteuerte Abnahmetests sind eine vierte Ebene: Sie durchlaufen Journeys in der laufenden App und finden Fehler, die zwischen Ebenen liegen, die jede für sich bestanden haben. Allein entscheiden sie nicht über den Merge.
Was passiert, wenn der Agent eine Journey nicht testen kann?
Die Journey ist BLOCKED, und der Kopfbereich des Berichts nennt, was fehlt, etwa ein Mail-Capture-Postfach, das der Umgebung fehlte. ConvOps zählt BLOCKED nie als bestanden. Der Infrastruktur-Agent liefert das Fehlende nach, und der ganze Plan läuft erneut. Lesen Sie BLOCKED-Zeilen zuerst: Eine Journey, die niemand durchlaufen konnte, kann einen echten Fehler verbergen.