
Das können Sie danach
- Die sechs Ebenen des Lernens in Ihrem eigenen Agenten-Stack anlegen.
- Ihre Erinnerungen nach Kategorie typisieren und festlegen, was jede Kategorie speist.
- Einen Abruf am Anfang, Learning Capture am Ende und lückensuchende Schritte in einen Workflow einbauen.
- Ein Fehlerregister mit Obergrenze und eine monatliche Konsolidierung einrichten.
- Das erste Gate auswählen, das an eine protokollierte Prüfung übergeht, und die Gates festlegen, die nie wechseln.
Das Wichtigste
- Ein selbstverbesserndes KI-System verbessert seine Dateien, Erinnerungen und Workflow-Schritte, nie sein Modell: Die Lehren jedes abgeschlossenen Jobs werden zu Regeln, die der nächste Job liest.
- Es lernt in sechs Ebenen, jede davon ein Loop: Gedächtnis, Learning Capture, Workflow-Änderungen, lückensuchende Schritte, sofort erfasste Reibung und eine Pipeline, die das ganze System prüft.
- Erinnerungen sind nach Kategorie typisiert, und jede Kategorie speist einen anderen Ort: Korrekturen werden zu Regelkandidaten, Entscheidungen werden abgerufen, Abläufe werden zu Workflow-Schritten.
- Ein Test auf Klasse oder Einzelfall, ein Fehlerregister mit höchstens 15 Einträgen pro Abschnitt und eine monatliche Konsolidierung halten die Regeln klein genug, um gelesen zu werden.
- Autonomie ist das Ergebnis: Gates wechseln zu protokollierten Prüfungen, sobald die Ebenen sie vorhersehbar machen, während Merges, Veröffentlichungen und unumkehrbare Aktionen bei einer Person bleiben.
Wer ein selbstverbesserndes KI-System aufbauen will, lässt das Modell in Ruhe und verbessert alles drumherum. Ein selbstverbesserndes KI-System ist ein Repository aus Standards, ein Gedächtnisspeicher und Workflows mit Gates, die die Lehren jedes abgeschlossenen Jobs in Regeln verwandeln, die der nächste Job liest. Die Gewichte des Modells ändern sich nie. Das System lernt in sechs Ebenen, und jede davon ist ein Loop, der eine Lehre dort festhält, wo der nächste Job sie liest.
Wir betreiben alle sechs Ebenen auf ConvOps, wo unsere Tasks, Workflows, Gates und unser Gedächtnisspeicher liegen, und entwickeln sie jede Woche weiter. Dieser Guide zeigt den Aufbau, geschrieben für Engineering-Leads, Platform-Engineers und technische Gründer, die Coding- oder Content-Agenten für wiederkehrende Arbeit einsetzen. Wie eine ganz normale Woche in einfachen Worten aussieht, lesen Sie im zentralen Guide dieser Reihe: wie wir unser Unternehmen mit KI-Agenten führen. Beginnen Sie mit den Ebenen 1 und 2 an einem Workflow, den Sie jede Woche ausführen; alles Weitere baut auf dem auf, was diese beiden schreiben.
„Selbstverbessernd“ ist hier prozedural gemeint. Es geht nicht um rekursive Selbstverbesserung, und nichts wird neu trainiert. Jede Lehre landet in einer Erinnerung, einem Workflow-Schritt oder einem schriftlichen Standard, den eine Person lesen, prüfen und zurücknehmen kann. Genau darin liegt die Stärke des Designs: Sie sehen exakt, was das System gelernt hat, wo es das festgehalten hat und wer es freigegeben hat.
Alle Beispiele nutzen Copperfern, einen fiktiven Onlineshop für Wohnaccessoires, der Küchenzubehör und Tischwäsche auf Englisch und Spanisch unter copperfern.example.com verkauft. Die Schrittnamen, Gates, Kategorien und Schwellenwerte stammen von uns. Das Unternehmen, die Personen und alle Werte sind erfunden. Maya ist die Person, die am Merge-Gate (dem Kontrollpunkt, bevor Code zusammengeführt wird) freigibt.
Was ein selbstverbesserndes KI-System leistet
Ein selbstverbesserndes KI-System macht aus einem Fehler einmal eine Regel, damit kein späterer Job ihn wiederholt. Es steht auf drei Teilen: einem Repository aus Standards und Anweisungsdateien, die die Agenten lesen, einem Gedächtnisspeicher, den jeder Job zuerst abfragt und in den er während der Arbeit schreibt, und Workflows mit Gates, die festlegen, was in welcher Reihenfolge läuft und wo eine Person freigibt.
Auf diesen drei Teilen sitzen sechs Ebenen des Lernens, von einfach bis fortgeschritten. Jede Ebene ist ein Loop: In einem Job passiert etwas, eine Lehre wird irgendwo festgehalten, und ein späterer Job liest sie dort.

| Ebene | Der Loop | Was sie schreibt | Wo der nächste Job es liest | Wer freigibt |
|---|---|---|---|---|
| 1 Gedächtnis | Abruf vor dem Job, Speichern währenddessen und danach | Eine typisierte Erinnerung: eine Entscheidung, eine Korrektur, eine Stolperfalle | Der erste Schritt jedes verwandten Jobs | Niemand: Speichern ist der Normalfall |
| 2 Learning Capture (Erfassen der Lehren) | Der letzte Schritt jedes Workflows speichert, was der Lauf gelehrt hat | Erinnerungen und Routen | Der Abruf und jede Ebene darüber | Niemand: Der Agent entscheidet, was sich zu behalten lohnt |
| 3 Workflow-Änderungen | Eine wiederkehrende Lehre wird zu einer Zeile in einem Schritt oder zu einem neuen Schritt | Der Workflow selbst | Jeder Lauf dieses Workflows, ganz ohne Abruf | Eine Person gibt die Änderung frei |
| 4 Lückensuchende Schritte | Schritte im Workflow prüfen die Arbeit gegen die Standards und schreiben die fehlende Regel | Standards, Regeldateien, Anweisungsdateien, Kandidaten für das Fehlerregister | Der Discovery-Schritt (Ermittlung der Standards) jedes späteren Tasks und jedes Plan-Review | Der Agent beurteilt eine Klassenlücke und protokolliert sie; eine Person gibt den Merge frei |
| 5 Sofort erfasst | Reibung wird zum Task, sobald sie auftritt; unverletzliche Regeln werden zu Hooks | Tasks und Hooks | Der Backlog und das Harness bei jedem Tool-Aufruf | Erfassen braucht niemanden; eine Person legt den Horizont fest |
| 6 Gedächtnis-Pipeline | Liest jede Kategorie in jedem Workspace, führt zusammen, befördert, mustert aus und schlägt vor | Einträge im Fehlerregister, Regelvorschläge, Änderungen an Agenten und Anweisungsdateien | Alles darüber | Kleine Änderungen werden direkt übernommen; neue Regeln brauchen eine Person |
Die unteren Ebenen sind günstig und sehen einen Job. Die oberen sind langsamer und sehen das ganze System. Bauen Sie sie der Reihe nach auf, denn jede obere Ebene liest, was die unteren schreiben. Aus Beratungssicht ist das eine Etappe auf dem Weg zum KI-Betriebsmodell; dieser Guide bleibt bei der Mechanik.
Ebene 1: Gedächtnis, vor jedem Job abgerufen und danach gespeichert
Ein Agent, der jede Sitzung bei null beginnt, wiederholt jeden Fehler, den er je gemacht hat. Das Gedächtnis ist der erste Loop, und es funktioniert nur, wenn jeder Job liest, bevor er schreibt.
Was ist das Gedächtnis eines KI-Agenten in einem selbstverbessernden System? Das Gedächtnis eines KI-Agenten ist ein Speicher kurzer, typisierter Notizen (Entscheidungen, Korrekturen, Stolperfallen, Abläufe und mehr), den jeder Job in seinem ersten Schritt abfragt und in den er während der Arbeit schreibt. Wir betreiben einen einzigen Speicher für jeden Workspace und jeden verbundenen Agenten, Claude Code wie OpenCode, sodass eine im Support-Bereich gespeicherte Lehre von einem Website-Task gefunden wird.
Zuerst abrufen, unterwegs speichern
Der erste Schritt unserer Workflows beginnt mit dem Abruf. Ein einziger Aufruf, context_query, liefert zwei Dinge auf einmal: Routen, die festhalten, wo etwas liegt (Module, Dateien, Dokumentation), und Erinnerungen, die festhalten, was wir wissen. Ein engerer Aufruf, memory_recall, filtert nach Kategorie, Tags und Mindestwichtigkeit, wenn ein Schritt nur eine Art von Notiz braucht.
Gespeichert wird mit memory_store, mit einer Kategorie, einer Wichtigkeit von 1 bis 10 und Tags. Der Abruf gewichtet nach inhaltlicher Ähnlichkeit, Wichtigkeit und Aktualität, also setzt der Agent die Wichtigkeit danach, wie viel ein späterer Job verliert, wenn ihm die Notiz entgeht. Eine neue Notiz, die eine bestehende wiederholt, ersetzt diese, statt als Duplikat daneben zu liegen.
Der Checkout-Task von Copperfern beginnt damit, die Entscheidung „Alle Datumsangaben in UTC speichern, in der Zeitzone des Kunden anzeigen (März)“ und die Stolperfalle „Die Bestell-E-Mail formatiert Datumsangaben in ihrem eigenen Template“ abzurufen. Bevor der Agent eine Zeile Code schreibt, kennt er die Regel und die Falle.
Erinnerungen sind typisiert, und jeder Typ speist einen anderen Ort
Die Kategorie ist das wichtigste Feld einer Erinnerung, denn sie entscheidet, wohin die Lehre als Nächstes geht. Eine Korrektur ist ein Regelkandidat. Eine Entscheidung wird abgerufen, nicht neu aufgerollt. Eine Präferenz gehört in eine Anweisungsdatei, die jede Sitzung ohne Abfrage liest.
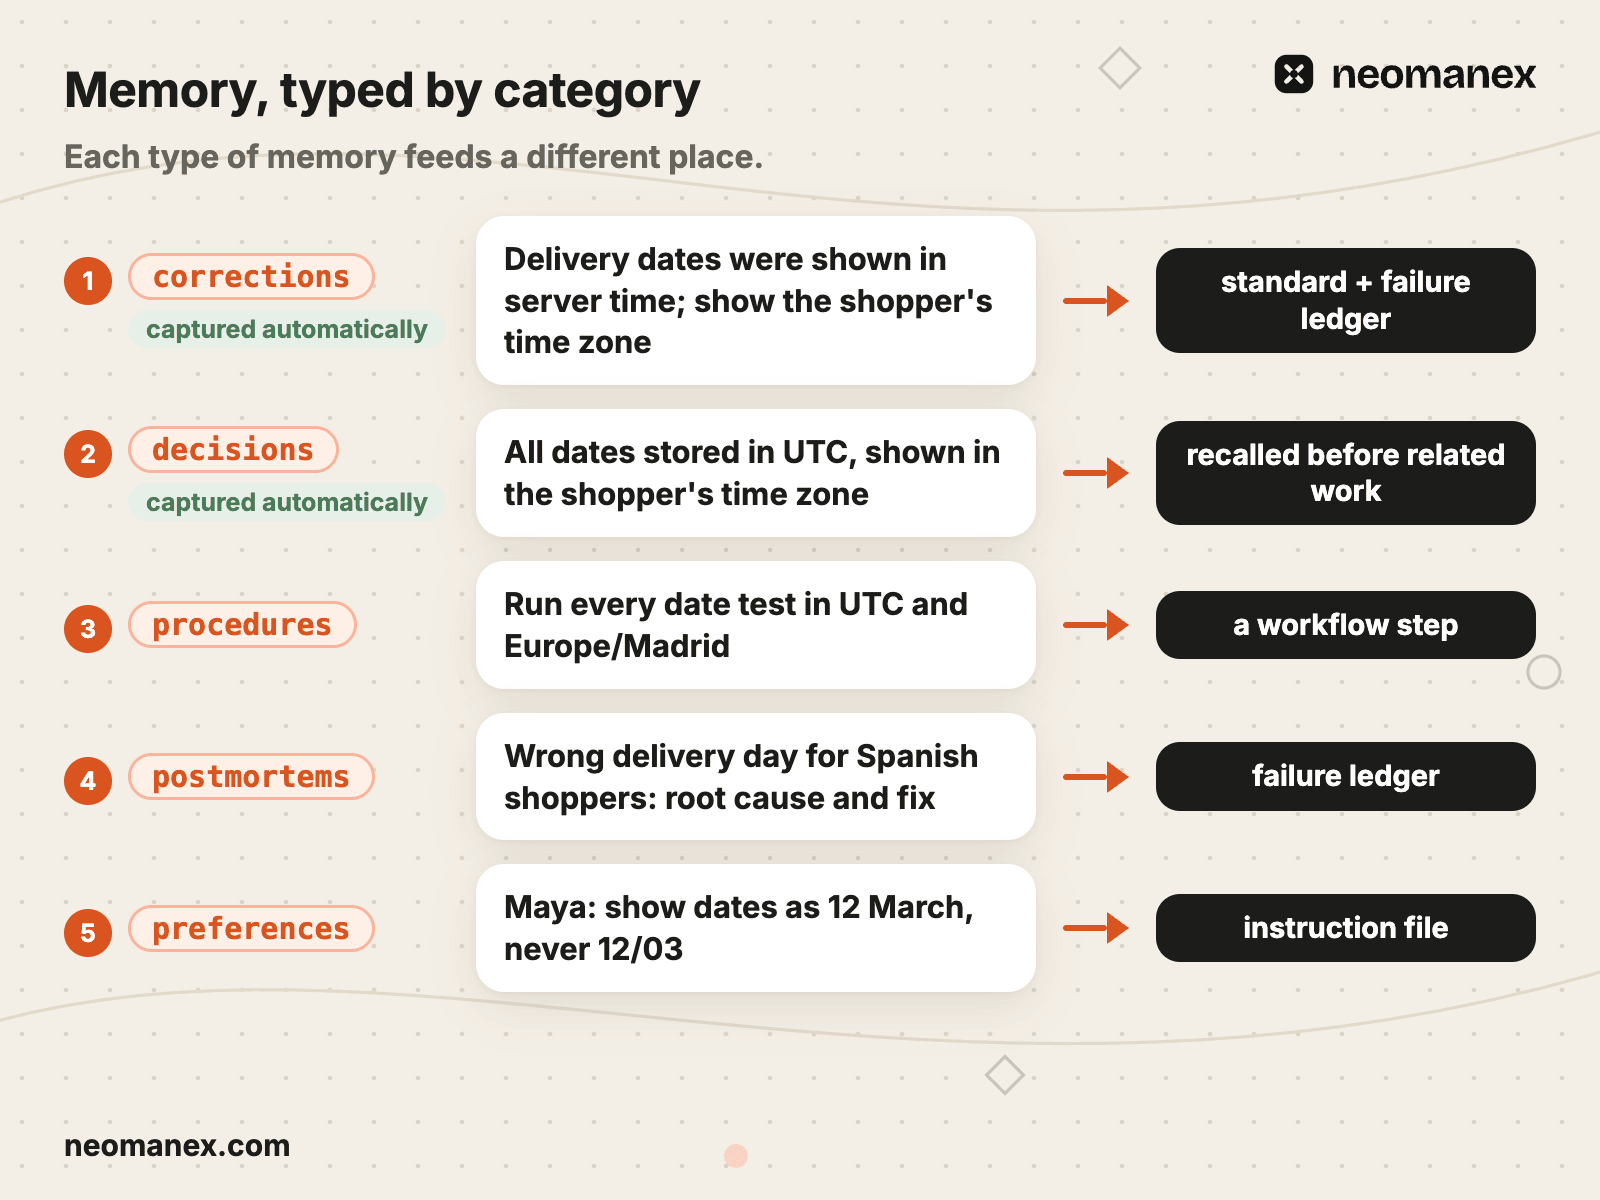
| Kategorie | Erinnerung bei Copperfern | Was sie als Nächstes speist |
|---|---|---|
corrections | „Lieferdaten wurden in Serverzeit angezeigt; die Zeitzone des Kunden anzeigen“ | Ein Regelkandidat für einen Standard und das Fehlerregister |
gotchas | „Die Bestell-E-Mail formatiert Datumsangaben in ihrem eigenen Template“ | Ein Regelkandidat; vor jeder Datumsänderung abgerufen |
decisions | „Alle Datumsangaben in UTC speichern, in der Zeitzone des Kunden anzeigen (März)“ | Vor verwandter Arbeit abgerufen |
context | Mayas Merge-Notiz: „Freigegeben, nachdem der Madrid-Test bestanden war“ | Bleibt bei ihrem Task, abgerufen, wenn die Arbeit weitergeht |
procedures, patterns | „Jeden Datumstest in UTC und Europe/Madrid ausführen“ | Workflow-Schritte und Standards |
postmortems | „Falscher Liefertag für spanische Kunden: Ursache und Fix“ | Das Fehlerregister |
preferences | „Maya: Datumsangaben als 12. März anzeigen, nie als 12/03“ | Anweisungsdateien |
progress | „Lieferdatums-Task gemergt, Branch aufgeräumt“ | Bleibt bei seinem Task |
reference, customers, marketing, posts | Fachwissen für die jeweils eigene Arbeit | Nach Fachgebiet abgerufen |
Ebene 6 liest all diese Kategorien auf einmal. Dort zeigt sich, dass eine Korrektur in einem Bereich und eine Stolperfalle in einem anderen dieselbe Lehre sind.
Manche Erinnerungen speichern sich selbst
Drei automatische Kanäle speichern, ohne dass jemand darum bittet, sobald Ereignisse im Lebenszyklus eines Tasks eintreten. Jeder wird pro Workspace eingeschaltet, und bei uns laufen alle drei:
decisions: wenn ein Entscheidungsschritt abgeschlossen, ein Task abgebrochen oder eine DECISION-Notiz (Entscheidungsnotiz) geschrieben wird.progress: bei jedem Schrittwechsel und jedem Abschluss.corrections: wenn jemand eine BLOCKER-Notiz (Notiz zu einem blockierenden Problem) schreibt, etwa eine Ablehnung an einem Gate.
Hinzu kommen context=-Notizen, die immer dann geschrieben werden, wenn sie übergeben werden. Der Parameter context= an Task- und Workflow-Aufrufen speichert die Notiz als context-Erinnerung im selben Aufruf wie die Aktion. Eine Workspace-Einstellung steuert das, und sie ist standardmäßig aktiv.
Alles andere wird bewusst gespeichert. Eine context=-Notiz umfasst 2 bis 3 Zeilen, eine Entscheidung und ihre Begründung, nie einen Statusbericht. Eine Notiz unter 40 Zeichen wird gar nicht gespeichert, weil leere Notizen den Abruf vergiften, und diese Untergrenze sitzt im Speicher selbst statt in der Disziplin irgendeiner Person.
Die Task-Buchhaltung (context und progress) bleibt bei ihrem Task. Diese Einträge werden markiert und standardmäßig aus dem Abruf anderer Tasks herausgehalten, damit eine Statuszeile vom letzten Monat im Abruf nie vor einer Entscheidung landet.
Wer eine Erinnerung freigibt
Niemand. Speichern ist der Normalfall, und der Agent setzt die Wichtigkeit. Eine schwache Erinnerung wird später in Ebene 6 ersetzt oder zusammengeführt, nie vorab freigegeben. Ein Freigabeschritt an dieser Stelle führt dazu, dass Agenten weniger speichern, und eine fehlende Lehre kostet weit mehr als eine verrauschte, die die Pipeline zusammenführt.
Was beim Gedächtnis schiefging, und die Regel daraus
Unser erstes Gedächtnisdesign hatte eine einzige Sammelkategorie, learnings. Alles landete dort, und der Abruf lieferte zu jeder Anfrage einen Haufen gemischter Notizen. Die Regel: learnings ist in unserem Gedächtnisstandard für neue Erinnerungen abgekündigt, und Erinnerungen kommen in spezifische Kategorien mit jeweils eigener Aufgabe. Bei Copperfern lagen im selben Haufen Datumsangaben, E-Mails und Preise nebeneinander; jetzt hat jede Notiz einen Typ und ein Ziel.
Der zweite Fehler kam, nachdem die automatischen Kanäle eingeschaltet waren. Die Task-Buchhaltung übertraf das bewusst gespeicherte Wissen zahlenmäßig und rangierte im Abruf darüber. Die Regel: Buchhaltung wird markiert und standardmäßig vom taskübergreifenden Abruf ausgeschlossen, und jeder neue Erfassungskanal kommt mit einer Abrufgewichtung, einer Eignungsklasse und einer konfigurierbaren Wichtigkeit.
Wenn Ihre Agenten jede Sitzung bei null beginnen, bauen Sie diese Ebene zuerst. ConvOps ist der Ort, an dem wir sie betreiben: Workflows mit einem Abrufschritt am Anfang und Learning Capture am Ende sowie ein Gedächtnisspeicher, den jeder verbundene Agent liest. So funktioniert ConvOps(wird in einem neuen Tab geöffnet).
Ebene 2: Learning Capture, der letzte Schritt jedes Workflows
Wenn das Speichern einer Lehre davon abhängt, dass der Agent daran denkt, passiert es nicht. Deshalb ist es in unserem System ein Schritt, und zwar der letzte jedes Workflows.
Learning Capture ist ein globaler Schritt. Wir definieren ihn einmal, und die Workflow-Engine hängt ihn, gefolgt von Complete (Abschluss), an jeden Workflow in seinem Geltungsbereich an. Niemand fügt ihn einem neuen Workflow von Hand hinzu, und niemand kann ihn vergessen. Fix-Workflows und die Workflows, die einzelne Phasen eines größeren Plans ausführen, liegen außerhalb dieses Geltungsbereichs.
Der Schritt gibt dem Agenten vor:
Lehren aus dieser Workflow-Ausführung erfassen. Entscheidungen, Stolperfallen und Muster per memory_store() speichern. Neue Codepfade als Routen indexieren, wenn bedeutende Codebereiche entstanden sind: route_create für einen neuen Bereich oder route_update, um einen bestehenden zu erweitern. Zuerst die bestehende Route abfragen und die Pfade selbst zusammenführen, da route_update jedes gesendete Feld ersetzt. Wenn nichts Nennenswertes passiert ist, mit „no learnings to store“ überspringen.
Drei Designentscheidungen stecken in diesem Text:
- Er nennt die Kategorien. Entscheidungen, Stolperfallen, Muster: Der Agent speichert typisierte Erinnerungen, kein Tagebuch des Laufs.
- Er indexiert neuen Code als Routen. Der Abruf des nächsten Jobs sagt, wo der Code liegt, und nicht nur, was wir darüber wissen.
- Er erlaubt das Überspringen. Ein Lauf ohne Neues speichert bewusst nichts. Eine erzwungene Notiz bei jedem Lauf wäre die Buchhaltungsflut aus Ebene 1, die zurückkehrt.
Workflows mit eigenem Lernschritt führen beide aus. Unser Verbesserungszyklus (Ebene 3) hat einen eigenen Schritt Learn (Lernen), der speichert, was jeder Zyklus gelehrt hat, und das globale Learning Capture läuft trotzdem vor Complete.
Learning Capture speist drei Orte: den Speicher, den Ebene 1 abruft, die Workflow-Änderungen aus Ebene 3 und die Pipeline aus Ebene 6. Niemand gibt es frei; der Agent entscheidet, was sich zu behalten lohnt.
Der Lieferdatums-Task von Copperfern endet damit, dass Learning Capture die Stolperfalle „Die Server-Zeitzone sickert in die Lieferdaten; in Europe/Madrid testen“ und eine Route für das neue Datumsformatierungsmodul speichert. Der nächste Datums-Task findet beides in seinem ersten Schritt: was zu testen ist und wo der Code liegt.
Was schiefging. Sitzungen änderten Dateien und endeten, ohne etwas zu speichern. Ein Schritt am Ende eines Workflows erfasst keine Arbeit, die außerhalb eines Workflows passiert, und auch keine Sitzung, die vor ihrem letzten Schritt endet. Die Regel: Ein Stop-Hook im Agent-Harness (in Claude Code ein Skript, das jedes Mal läuft, wenn der Agent anhält) prüft nach jeweils 2 Antworten des Assistenten, ob die Sitzung etwas gespeichert hat. Eine Sitzung, die Dateien geändert und nichts gespeichert hat, wird sofort markiert, ohne diese Zählung abzuwarten. Das Protokoll hängt nie vom Gedächtnis irgendeiner Person ab, auch nicht von dem des Agenten.
Ebene 3: Workflows, die sich selbst ändern
Eine Lehre, die nur im Gedächtnis lebt, ist darauf angewiesen, dass der Abruf sie findet. Eine Lehre, die im Schritt steht, wird jedes Mal gelesen, wenn der Job diesen Schritt erreicht. Deshalb macht die dritte Ebene aus dem, was Learning Capture gefunden hat, eine Änderung am Workflow selbst: eine schärfere Anweisung, einen neuen Schritt, ein neues Gate, einen begrenzten Loop.
Darum halten wir Abläufe in Workflows statt in einer langen Anweisungsdatei. Ein Workflow ist ein Graph aus Schritten, also landet eine Lehre in dem einen Schritt, der sie braucht, und nicht in einer Datei, die jeder Schritt lesen muss (die Idee hinter Graph Engineering).
Wie sich ein Schritt ändert
Änderungen sind chirurgisch: ein Schritt nach dem anderen, nie ein Neuaufbau eines laufenden Workflows. Jede Änderung wird nur mit null Validierungswarnungen übernommen und danach aus der Engine zurückgelesen, um zu bestätigen, dass der Schritt sagt, was gemeint war. Vor einer strukturellen Änderung, etwa dem Verschieben oder Entfernen eines Schritts, werden die laufenden Durchläufe geprüft, damit kein aktiver Task seinen nächsten Schritt verschwunden vorfindet.
Der Schritttext enthält nur das Vorgehen: was der Ausführende an diesem Schritt tut. Der Grund für eine Änderung kommt in eine Erinnerung, nie in den Schritt. Einen Schritt voller Vorgeschichte überfliegen Agenten nur.
Der Entwicklungs-Workflow von Copperfern lernt die Lieferdatums-Lehre in einer Zeile:
Implement
  (existing instructions unchanged)
+ Run every date test in UTC and Europe/Madrid.
Von da an liest jeder Task, der Implement (Umsetzung) erreicht, diese Zeile. Kein Abruf muss sie finden und gewichten, und kein Agent muss sich an sie erinnern.
Workflow-Änderungen gibt eine Person frei. Der Agent schlägt die Änderung vor und nimmt nach der Freigabe die chirurgische Änderung vor. Eine einzeilige Korrektur an einem Standard oder einer Anweisungsdatei, auf die ein Schritt verweist, wird unter unserem Standard für Anweisungsdateien direkt übernommen (Ebene 5 zeigt, wo diese Grenze verläuft).
Der Verbesserungszyklus: eine Verbesserung pro Zyklus
Manche Arbeit verbessert ein Ergebnis, statt einen Task abzuschließen: eine Seite, einen Text, ein wiederkehrendes Audit. Dafür betreiben wir den Workflow Autonomous Cycle (autonomer Zyklus), einen Loop, der seinen eigenen Output Änderung für Änderung bearbeitet.
| Schritt | Was er tut |
|---|---|
| Analyze (Analysieren) | Ruft frühere Lehren zu diesem Ergebnis ab (Mindestwichtigkeit 5, höchstens 10) und schreibt eine Analyse |
| Validate (Validieren) | Ruft frühere Entscheidungen (bis zu 10) und Stolperfallen (bis zu 5) ab. Ist die Analyse fehlerhaft oder wiederholt sie eine frühere Entscheidung, schreibt er die Begründung und schickt den Zyklus zurück zu Analyze |
| Plan (Planen) | Wählt die eine Verbesserung mit der größten Wirkung. Eine pro Zyklus, dafür gründlich |
| Execute (Ausführen) | Nimmt genau diese eine Änderung vor |
| Learn | Speichert, was der Zyklus gelehrt hat |
| Continue? (Weitermachen?) | improve-more plant den nächsten Zyklus eine Minute später ein; done schließt den Lauf. Eine Zyklusobergrenze, sofern der Lauf eine setzt, stoppt ihn |
Learning Capture und Complete folgen, wie bei jedem Workflow. Eine Verbesserung pro Zyklus hält jeden Schritt klein und überprüfbar: Ein Zyklus, der fünf Dinge ändert, kann nicht sagen, welches davon geholfen hat. Der Rücksprung von Validate zu Analyze verhindert, dass der Loop vorschlägt, wogegen schon entschieden wurde.
Was bei Workflows schiefging, und die Regeln daraus
Unsere Guides erschienen nur auf Englisch, nachdem ein separater Übersetzungsjob nicht mehr lief, und nichts im Guide-Workflow bemerkte es. Die Regel: Die Übersetzung wurde zu einem Schritt im Guide-Workflow, gefolgt von einem Übersetzungsprüfer, der für jede Sprache null Befunde liefern muss. Bei Copperfern hinkten die spanischen Seiten aus demselben Grund den englischen hinterher; jetzt übersetzt und prüft der Seiten-Workflow, bevor er veröffentlichen kann.
Auch Review-Schritte drehten sich im Kreis, ohne zu konvergieren, und jede Runde fand etwas Neues. Die Regel: Jedes Review weist an einen Überarbeitungsschritt zurück, und nach 2 Runden legt es einen Bug an und stoppt, statt eine dritte zu starten. Ein kreisendes Review verbrennt Läufe; ein Bug holt eine Person mit den Belegen dazu.
Ebene 4: Schritte, die Lücken finden und die Standards korrigieren
Der beste Ort, um eine fehlende Regel zu finden, ist der Workflow, der sie gerade gebraucht hat. Deshalb trägt unser Entwicklungs-Workflow eigene lückensuchende Schritte. Diese Schritte prüfen die Arbeit gegen die Standards, finden, wo ein Standard fehlt oder schwach ist, und schreiben die Korrektur zurück, bevor der nächste Task beginnt.
Der Workflow heißt Development Task (MR flow) (Entwicklungs-Task mit Merge-Request-Ablauf). Das sind die Schritte, die für diese Ebene zählen, in ihrer Reihenfolge, wobei die fünf lückensuchenden Schritte wie in der Abbildung unten nummeriert sind. Andere Schritte, etwa die Use-Case-Dokumentation, der Push und die CI-Checks, laufen dazwischen:
Functional Analysis (fachliche Analyse; eine Person gibt frei, die Anforderungsliste wird eingefroren) → 1 Discover Standards & Flag Gaps (Standards ermitteln, Lücken melden) → Technical Analysis (technische Analyse) → 2 Traceability Check (one pass) (Rückverfolgbarkeitsprüfung in einem Durchgang) → Implement → 3 Check Standards Compliance (Einhaltung der Standards prüfen) und Compliance Decision (Entscheidung zur Einhaltung) → 4 Terminal Gap Check (abschließende Lückenprüfung) → Update Documentation (Dokumentation aktualisieren) → Merge (Verification Review + CI Green + Operator) (Zusammenführen nach Verifikations-Review, grüner CI und Freigabe durch eine Person) → Standards Check? (Standards betroffen?) → 5 Standards Capture (Standards erfassen) → Learning Capture → Complete.

1. Discover Standards & Flag Gaps
Vor jedem Design liest ein Standards-Discovery-Agent unsere Routing-Dateien (eine pro Team, die einzige verbindliche Quelle dafür, welche Standards für welche Arbeit gelten) und erstellt die Liste der Standards, die für diesen Task maßgeblich sind. Im selben Durchgang öffnet er jeden Standard und meldet eine Lücke, wenn:
- kein Standard den Bereich überhaupt abdeckt
- ein Standard existiert, aber das Muster verfehlt, das diese Arbeit braucht
- ein Standard veraltet ist oder der Praxis widerspricht
- die Arbeit ein neues Muster einführt, das kein Standard behandelt
- eine Standards-Datei existiert, die keine Routing-Datei erreicht
Bei null Lücken sagt der Schritt das und geht weiter, ohne zu warten. Bei jeder Lücke hält er an, und eine Person entscheidet pro Lücke: einen Task anlegen, einen bestehenden Standard erweitern oder das Risiko akzeptieren. Beim Weitergehen wird die Liste für diese Arbeit festgeschrieben. Jede spätere Prüfung läuft gegen die festgeschriebene Liste, damit niemand mittendrin die Spielregeln ändert.
2. Traceability Check (one pass)
Nach der Technical Analysis geht ein Gap-Analyzer einmal eine geschlossene Checkliste mit vier Punkten durch. Ein Durchgang, nie ein Loop. Blocker aus den ersten drei Punkten werden an Ort und Stelle behoben, der vierte Punkt hält für eine Person an, und alles andere kommt auf die Beobachtungsliste bekannter Risiken des Tasks statt in eine weitere Review-Runde.
3. Check Standards Compliance und Compliance Decision
Nach Implement prüft ein Standards-Reviewer die Änderung gegen die festgeschriebene Liste. Compliance Decision liest den Bericht:
| Befund | Was passiert |
|---|---|
| HIGH oder MEDIUM (hoch oder mittel) | Der Fix-Workflow läuft einmal. Der Reviewer läuft nicht erneut: Der Nachweis sind die eigenen Belege des Fixers (Lint, Typprüfung und die betroffenen Unit-Tests grün), zitiert in den Task-Notizen |
| LOW (niedrig), eine Zeile | Direkt behoben |
| LOW, mehr als eine Zeile | Abgleich mit bestehenden Tasks, sonst als Task mit dem Tag discovered-during-execution angelegt, mit Angabe von Datei, Zeile und Standard |
| Schon vorher vorhanden | Wird hier nie behoben |
Der Schritt gilt als bestanden, wenn null HIGH- und null MEDIUM-Befunde offen sind.
4. Terminal Gap Check
Vor Dokumentation und Merge erledigt der Terminal Gap Check drei Dinge. Jeder Punkt der Beobachtungsliste aus Schritt 2 wird geschlossen: Ein eingetretenes Risiko wird jetzt behoben, ein nicht eingetretenes bekommt eine einzeilige Einordnung. Jede Anforderung wird ihrem ausgelieferten Nachweis zugeordnet, und eine Anforderung ohne Nachweis bekommt jetzt einen Test oder hält für eine Person an. Und jeder Ausführungsfehler, den nichts vorhergesagt hat, wird als failure-pattern-Erinnerung mit Wichtigkeit 7 gespeichert: Das sind die Kandidaten für das Fehlerregister.
Update Documentation folgt, geschrieben von einem Dokumentations-Agenten auf Basis des Diffs. Nach dem Push und den CI-Checks kommt das Merge-Gate: Es braucht eine grüne Pipeline und die Freigabe einer Person, beides. Es ist der einzige Kontrollpunkt für eine Person zwischen der freigegebenen Analyse und dem Merge, und eine rote Pipeline heißt, die Ursache zu beheben, nie trotzdem zu mergen.
5. Standards Check? und Standards Capture
Nach dem Merge entscheidet Standards Check?, ob der Fix den Standards etwas beibringt. Ja, wenn ein Bug behoben wurde, der für eine Klasse von Fehlern stehen könnte, wenn ein fehlender oder schwacher Standard das Problem hätte verhindern können oder wenn die Änderung eine Lücke in den Standards offengelegt hat. Nein bei einem einfachen Feature, einem Refactoring ohne Verhaltensänderung oder einer reinen Dokumentationsänderung.
Ja startet Standards Capture, drei Schritte:
- Assess Standards Gap (Standardlücke bewerten) liest die Standards, die Regeldateien der Agenten und die Anweisungsdateien. Der Schritt liefert „No gap“ (keine Lücke) mit einer einzeiligen Begründung oder „Gap found“ (Lücke gefunden) mit der genauen Datei, der Regel, der Begründung und einem Formulierungsentwurf. Er empfiehlt eine Regel nur, wenn der Bug für eine Klasse von Fehlern steht, die eine Regel abfangen würde, nie für einen Einzelfall.
- Standards Judgment (Standards-Beurteilung) ist die eigene Entscheidung des Agenten, ohne Freigabe durch eine Person. Bevor er weitergeht, muss er das Ergebnis als Aktivität protokollieren. Dieses Protokoll hat die Abzeichnung durch eine Person ersetzt, und es ist der Prüfpfad.
- Apply Standard (Standard anwenden) läuft nur, wenn die Lücke als berechtigt beurteilt wurde. Ein Dokumentations-Agent schreibt die Regel und liest die Datei danach erneut, um zu prüfen, dass die Änderung angekommen ist.
Der Klassentest hält die Standards lesbar. Eine Regel für jeden einzelnen Bug bläht einen Standard auf, bis kein Agent ihn mehr genau liest.
Der Lieferdatums-Fix von Copperfern läuft so hindurch:
Standards Check?   yes
Assess             Gap found. Class: any date shown to a shopper can leak server time
Judgment (logged)  Standards judgment: applied dates-and-times.md, shopper time zone
Apply              dates-and-times.md v1.2
                   Store UTC; render in the shopper's time zone;
                   every date test runs in two time zones
Standards Capture ändert Standards, Regeldateien und Anweisungsdateien. Workflow-Korrekturen kommen über Ebene 3. Änderungen an Agentendefinitionen kommen aus dem, was diese Schritte finden, und aus den Vorschlägen von Ebene 6.
Das Fehlerregister: der Maßstab für Plan-Reviews
Was ist ein Fehlerregister (Failure Ledger)? Ein Fehlerregister ist eine kuratierte Liste falsifizierbarer Fehlermuster, jedes aus einem echten Vorfall, gegen die Plan-Reviews prüfen. Jeder Eintrag hat vier Felder: ID, Muster (Pattern), Prüfung (Check) und Vorfall (Incident). Ein Reviewer liefert pro Eintrag PASS, FAIL oder N/A (bestanden, nicht bestanden, nicht anwendbar) und liest nur den globalen Abschnitt und den Abschnitt seines eigenen Projekts.
| ID | Muster | Prüfung | Vorfall |
|---|---|---|---|
FL-P1 | Datum ohne die Zeitzone des Kunden angezeigt | Jedes Datum im Plan nennt seine Zeitzone | Lieferdatum auf Produktseiten |
| Registerregel | Wert | Warum |
|---|---|---|
| Aufnahme | Nur echte Vorfälle; Kandidaten werden bei der Konsolidierung befördert, nie mitten im Review | Ein Register erdachter Risiken ist eine Wunschliste |
| Obergrenze pro Abschnitt | 15 Einträge; an der Obergrenze werden überlappende Einträge zusammengeführt, bevor ein neuer hinzukommt | „Die Obergrenze erzwingt die Disziplin“ |
| Ausmusterung | Nur PASS oder N/A über 5 aufeinanderfolgende Pläne: bei der Konsolidierung in den Abschnitt Retired (ausgemustert) verschoben | Eine Prüfung, die nie anschlägt, kostet jedes Review Zeit |
| Wo geprüft wird | Im Review des nächsten Plans | Der Entwicklungs-Workflow liefert Kandidaten; Plan-Reviews lesen das Register |
Was schiefging. Ein Plan-Review lief Runde um Runde, jede fand etwas Neues, und es kam nie zu einem Ergebnis. Die Regel: Reviews prüfen gegen ein kuratiertes Register falsifizierbarer Muster aus echten Vorfällen, jeder Befund ist durch seinen Vorfall belegt, mit einer Obergrenze pro Abschnitt und begrenzten Runden.
Ebene 5: Verbesserungen, im laufenden Betrieb erfasst
Der günstigste Moment, eine Reibung festzuhalten, ist der Moment, in dem sie auftritt. Eine Lehre, an die man sich erst am Ende der Woche erinnert, ist schon halb verloren. Deshalb wird jeder Vorschlag, einen Loop, einen Schritt, einen Standard oder ein Tool zu verbessern, in dem Moment als Task angelegt, in dem er auftaucht, und die Arbeit geht weiter.
Die Regel steht in unserer zentralen Anweisungsdatei. Eine Aktion, die nicht auf Anhieb klappte (ein Test, der beim ersten Mal fehlschlägt, eine versteckte Voraussetzung, ein fehlendes Setup, ein undokumentierter Schritt), wird einer Person gemeldet, mit bestehenden Tasks abgeglichen und nur dann mit dem Tag discovered-during-execution angelegt, wenn keiner passt. Jeder solche Task hängt unter einem einzigen Engineering-Health-Ziel, egal aus welchem Projekt er stammt, sodass Reibung ein Zuhause und einen Backlog hat.
Compliance Decision wendet dieselbe Regel innerhalb eines Workflows an: Ein LOW-Befund, der größer als eine Zeile ist, wird zum Task, nie zum Grund, den Merge aufzuhalten.
Beim Beheben des Lieferdatums stellt der Agent von Copperfern fest, dass die Bestell-E-Mail Datumsangaben in ihrem eigenen Template formatiert. Er legt „Bestell-E-Mail ignoriert die Zeitzone des Kunden“ an, mit dem Tag discovered-during-execution, und schließt den Task ab, an dem er gerade war. Die E-Mail bekommt ihren eigenen Task, ihr eigenes Review und ihren eigenen Merge.
Das Anlegen braucht keine Freigabe. Eine Person legt den Horizont fest: now, next oder later (jetzt, als Nächstes, später). Ist der Fix eine kleine Änderung an einer Anweisungsdatei, einem Standard oder einem Protokoll (eine Zeile, ein veralteter Wert, ein Tippfehler, ohne neue Regel und ohne Designentscheidung), nimmt der Agent sie unter unserem Standard für Anweisungsdateien direkt vor, committet und pusht sie. Eine neue Regel, eine Umstrukturierung oder alles, was das Verhalten der Agenten ändert, wird zuerst vorgeschlagen und von einer Person freigegeben. Diese Trennung hält Anweisungsdateien kurz: Solche Dateien verweisen auf Standards, statt sie zu enthalten (warum eine lange CLAUDE.md ein Symptom ist).
Hooks: die Regeln, die nie vom Gedächtnis abhängen
Manche Regeln sind zu wichtig, um in einem Prompt zu stehen. Die Hooks Ihres Agent-Harness laufen vor oder nach Tool-Aufrufen und wenn der Agent anhält, sodass sie eine Regel durchsetzen, ob der Agent sich an sie erinnert oder nicht. Drei der Hooks, die wir in Claude Code betreiben:
| Hook | Wann er läuft | Was er durchsetzt |
|---|---|---|
| Sperre destruktiver Befehle | Vor jedem Shell-Befehl | Löschen wird blockiert, bevor es läuft, und Dateien werden stattdessen archiviert (wie wir Löschungen stoppen) |
| Git-Drift-Prüfung | Wenn die Sitzung anhält | Nicht committete oder nicht gepushte Arbeit verhindert das Ende der Sitzung |
| Gedächtnisprüfung | Wenn die Sitzung anhält, nach jeweils 2 Antworten des Assistenten | Geänderte Dateien ohne gespeicherte Erinnerung werden sofort markiert |
Angelegte Tasks speisen den Backlog, wo jeder als eigener Task behoben wird. Außerdem speisen sie Ebene 6, die angelegte Issues neben den Erinnerungen liest. Und wenn der Fix ein Schritt oder ein Standard ist, speisen sie die Ebenen 3 und 4.
Was schiefging. Ein Standards-Loop aus Prüfen, Beheben und erneutem Prüfen fand Runde um Runde neue LOW-Befunde, bis eine Person ihn stoppte, während der eigentliche Task wartete. Die Regel: HIGH- und MEDIUM-Befunde werden einmal behoben, ohne erneutes Review. Ein LOW-Befund wird direkt behoben, wenn er eine Zeile umfasst, und sonst als Task angelegt. Bei Copperfern hätte derselbe Loop den Lieferdatums-Fix wegen der Formulierung eines Kommentars aufgehalten; nach der Regel geht die Formulierung in einen Task, und der Fix wird gemergt.
Ebene 6: die Gedächtnis-Pipeline, die das ganze System prüft
Jede Ebene darunter sieht einen Job. Diese sieht alle, und genau dort zeigen sich die Muster, die kein einzelner Job sehen kann.
Die Gedächtnis-Pipeline liest jede Kategorie von Erinnerungen, jede Entscheidung und jedes angelegte Issue über alle Workspaces hinweg. Die Pipeline führt zusammen, was sich wiederholt, hält das Register ehrlich und schlägt Verbesserungen für das ganze System vor: Standards, Workflows, Agentendefinitionen und Anweisungsdateien.
Die Mechanik:
- Konsolidierung führt
memory_consolidatemonatlich für jede aktive Kategorie aus: zuerst ein Probelauf, damit eine Person lesen kann, was zusammengeführt wird, dann das Zusammenführen von Erinnerungen ab einer Ähnlichkeit von 0,85. Dieser Schwellenwert führt Beinahe-Duplikate zusammen und hält unterschiedliche Lehren getrennt. - Supersede-Ketten (Ersetzungsketten) ersetzen eine alte Erinnerung durch ihre neuere Version, statt beide zu behalten.
expires_atentfernt zeitgebundenen Kontext, sobald er nicht mehr zutrifft.- Registerpflege befördert
failure-pattern-Kandidaten in das Register, nie mitten im Review, und verschiebt Einträge mit 5 sauberen aufeinanderfolgenden Plänen nach Retired.
Jeder Vorschlag landet dort, wo er hingehört, mit eigener Freigabe:
| Vorschlag | Landet als | Wer freigibt |
|---|---|---|
| Ein Kandidat für ein Fehlermuster | Ein Registereintrag | Bei der Konsolidierung befördert |
| Ein Registereintrag, der nie anschlägt | Ein Eintrag in Retired | Bei der Konsolidierung nach der Registerregel verschoben |
| Eine kleine Korrektur an einer Anweisungsdatei, einem Standard oder Protokoll | Eine direkte Änderung | Der Agent, unter dem Standard für Anweisungsdateien |
| Eine neue Regel oder eine Umstrukturierung | Ein Vorschlag | Eine Person |
| Eine Workflow-Änderung | Eine Änderung auf Ebene 3 | Eine Person |
| Eine Zeile für eine Agentendefinition | Ein Vorschlag | Eine Person |
Die Konsolidierung bei Copperfern liest corrections und gotchas aus dem Website- und dem Support-Bereich. Dabei findet sie drei Korrekturen zu Datum und Zeitzone, führt sie zusammen und befördert den Registereintrag FL-P1. Außerdem schlägt sie eine Zeile für die Definition des Implementierungs-Agenten vor, „Nie ein Datum ohne die Zeitzone des Kunden darstellen“, und Maya gibt sie frei.
Was schiefging. Beide Fehler aus Ebene 1, die Sammelkategorie und die Buchhaltungsflut, zeigten sich zuerst hier, als Abruf, der Rauschen lieferte. Aus Sicht eines einzelnen Jobs wirkt dieses Rauschen wie Pech; über den ganzen Speicher betrachtet ist es ein Muster mit einer Ursache, und nur diese Ebene sieht den ganzen Speicher.
KI-Agenten, die aus Fehlern lernen: eine Lehre durch sechs Ebenen
KI-Agenten, die aus Fehlern lernen, tun das, indem sie die Lehre an mehr als einem Ort festhalten. Hier ist eine Lehre von Copperfern, von einem abgelehnten Merge bis zum nächsten Task, der besteht. Der Task heißt „Lieferdatum auf Produktseiten anzeigen“ und läuft im Workflow Development Task (MR flow).

- Auslöser. Am Merge-Gate lehnt Maya mit einer BLOCKER-Notiz ab: „Spanische Kunden sehen das Datum von morgen als heute.“
- Ebene 1, Gedächtnis. Die BLOCKER-Notiz wird automatisch als
corrections-Erinnerung erfasst: „Lieferdaten wurden in Serverzeit angezeigt; die Zeitzone des Kunden anzeigen.“ - Ebene 2, Learning Capture. Der korrigierte Task endet damit, die Stolperfalle „Die Server-Zeitzone sickert in die Lieferdaten; in Europe/Madrid testen“ zu speichern, dazu eine Route zum Datumsformatierungsmodul.
- Ebene 3, Workflow-Änderung. Der Schritt Implement bekommt die Zeile „Run every date test in UTC and Europe/Madrid“ (jeden Datumstest in UTC und Europe/Madrid ausführen).
- Ebene 4, Lückenschritte. Standards Check? sagt ja. Assess findet eine Klasse: Jedes Datum, das ein Kunde sieht, kann Serverzeit durchsickern lassen. Die Beurteilung wird protokolliert, und
dates-and-times.mdv1.2 erhält die Regel „Store UTC; render in the shopper's time zone; every date test runs in two time zones“ (in UTC speichern, in der Zeitzone des Kunden darstellen, jeden Datumstest in zwei Zeitzonen ausführen), die nach dem Schreiben erneut gelesen wird. Der Terminal Gap Check hatte denfailure-pattern-Kandidaten bereits gespeichert. - Ebene 5, erfasst. „Bestell-E-Mail ignoriert die Zeitzone des Kunden“ wird als Task angelegt, mit dem Tag
discovered-during-execution. - Ebene 6, Pipeline. Die Konsolidierung führt drei Zeitzonen-Korrekturen aus Website und Support zusammen, befördert
FL-P1und schlägt „Nie ein Datum ohne die Zeitzone des Kunden darstellen“ für den Implementierungs-Agenten vor. Maya gibt die Zeile frei. - Nächster Task. „Abholzeitfenster anzeigen“ startet. Sein erster Schritt ruft die UTC-Entscheidung ab. Discover Standards & Flag Gaps listet
dates-and-times.md. Check Standards Compliance besteht. Das Review des Plans, zu dem der Task gehört, prüftFL-P1: PASS. Maya gibt am Merge-Gate frei.
Der nächste Task besteht, weil sechs Ebenen die Lehre an sechs Orten festgehalten haben, nicht weil sich das Modell geändert hat. Wenn der Abruf die Erinnerung verfehlt, steht die Zeile im Schritt. Wenn ein neuer Agent den Schritt überspringt, steht der Standard in seiner festgeschriebenen Liste. Wenn der Plan abdriftet, fängt das Register es ab.
Wie Autonomie nach den Ebenen aussieht
Autonomie ist kein Regler, den wir hochdrehen. Sie ist vielmehr das, was bleibt, wenn die Ebenen darunter die Entscheidung eines Gates vorhersehbar gemacht haben. Ein Gate wechselt nur dann von der Abzeichnung durch eine Person zu einer protokollierten Prüfung, wenn das zutrifft, und die Entscheidung bleibt protokolliert, damit eine Person sie lesen kann (wie wir Entscheidungen von Agenten nachvollziehen).

| Von der Abzeichnung durch eine Person zur protokollierten Prüfung gewechselt | Wechselt nie |
|---|---|
| Standards Judgment bei einer Klassenlücke: Der Agent entscheidet und protokolliert eine Aktivität, die eine Person liest | Das Merge-Gate für Code: grüne Pipeline und die Freigabe einer Person |
| Standards-Compliance: HIGH und MEDIUM einmal behoben, mit den Belegen des Fixers, ohne zweites Review | Die Veröffentlichung eines Guides |
| Review-Runden: Ein fehlschlagendes Review geht an einen Überarbeitungsschritt, nach 2 Runden an einen Bug | Force-Push, Umschreiben der History und öffentliche Release-Tags |
| Gates, die für einen Lauf vorab freigegeben sind, wenn eine Person „go autonomous“ (autonom weitermachen) sagt | Löschen von Dateien: durch einen Hook blockiert, stattdessen archiviert |
| Kleine Korrekturen an veröffentlichten Seiten, live nachgeprüft, alles andere wartet auf eine Person (der Self-Healing-Loop) | Neue Regeln und Umstrukturierungen von Anweisungsdateien und Protokollen |
Standards Judgment ist das deutlichste Beispiel. Früher wartete der Schritt auf eine Person. Der Klassentest in Assess, die Standards, die er liest, und das erneute Lesen in Apply haben sein Ergebnis so vorhersehbar gemacht, dass eine protokollierte Entscheidung die Abzeichnung jetzt ersetzt. Die Aktivität bei Copperfern lautet „Standards judgment: applied dates-and-times.md, shopper time zone“, und Maya liest sie, wann immer sie will. Der Merge wartet weiterhin auf sie.
Die rechte Spalte ist eine Designentscheidung, keine Reifelücke. Diese Aktionen sind unumkehrbar oder öffentlich, und eine nachträglich protokollierte Entscheidung kann sie nicht rückgängig machen. Wo eine Person im Loop bleibt, liegt das am Risiko (Human-in-the-Loop-KI-Systeme aufbauen).
Was schiefgeht, wenn Sie selbstverbessernde KI-Agenten bauen
Jede Regel in diesem System stammt aus einem Fehler, auf den wir gestoßen sind. Hier stehen sie an einem Ort, zusammen mit der Ebene, die jeder Fehler verändert hat.
| Fehler | Regel daraus | Ebene |
|---|---|---|
| Eine Sammelkategorie für Erinnerungen; der Abruf lieferte Rauschen | Spezifische Kategorien; learnings für neue Erinnerungen abgekündigt | 1, 6 |
| Task-Buchhaltung übertraf bewusst gespeichertes Wissen im Abruf | Buchhaltung bleibt bei ihrem Task, außerhalb des taskübergreifenden Abrufs | 1, 6 |
| Sitzungen änderten Dateien und speicherten nichts | Stop-Hook markiert Änderungen ohne Erinnerung sofort | 2, 5 |
| Guides erschienen nur auf Englisch | Übersetzung als Workflow-Schritt, mit Prüfer | 3 |
| Reviews drehten sich im Kreis, ohne zu konvergieren | Fehlerregister, Überarbeitungsschritte, ein Bug nach 2 Runden | 3, 4 |
| Ein Standards-Loop fand immer neue LOW-Befunde | HIGH und MEDIUM einmal behoben; LOW direkt oder als Task | 5 |
| Ein Briefing plante ein Bild für jeden Absatz | Ein Bildbudget im Guide-Standard | 4 |
Die letzte Zeile zeigt denselben Loop bei Content statt Code. Ein Guide-Briefing plante weit mehr Bilder, als ein Leser braucht, und keine Regel setzte eine Obergrenze. Eine Person lehnte es am Brief-Gate (Freigabe des Briefings) ab, und weil jedes Briefing Bilder plant, ging die Korrektur in den Standard statt in dieses eine Briefing: Der Guide-Standard erhielt ein Bildbudget von höchstens 8 Bildern für einen Loop-Guide und 6 für jeden anderen Guide, das Hero-Bild eingeschlossen. Bei Copperfern hätte dieselbe Regel ein Briefing für einen Kaufratgeber, das ein Bild für jeden Absatz plante, auf die wenigen gekürzt, die etwas erklären, was Text nicht kann.
Das Muster hinter jeder Zeile ist dasselbe. Der Fehler passierte einmal, jemand schrieb die Regel in die Ebene, die ihn abgefangen hätte, und der nächste Job las die Regel, statt den Fehler neu zu entdecken. Unser Loop für SEO-Experimente hat seine Regeln auf dieselbe Weise entwickelt.
Ihr eigenes KI-Betriebssystem aufbauen, Ebene für Ebene
Sie brauchen nicht alle sechs Ebenen am ersten Tag. Die Ebenen 1 und 2 kommen zuerst, weil jede obere Ebene liest, was sie schreiben. Ergänzen Sie die lückensuchenden Schritte, sobald Sie Standards haben, gegen die sich eine Prüfung lohnt, und die Pipeline, sobald Ihr Speicher genug Erinnerungen enthält, um sich zu wiederholen.
Die sechs Schritte unten folgen den Ebenen der Reihe nach. Jeder funktioniert mit jedem Agent-Harness; ConvOps ist das Beispiel, weil wir unser System dort betreiben. Erstellen Sie ein kostenloses ConvOps-Konto(wird in einem neuen Tab geöffnet) und verbinden Sie Ihren Agenten(wird in einem neuen Tab geöffnet), um direkt mitzumachen.
Schritte
Jedem Job ein Gedächtnis geben
Setzen Sie in jedem Workflow einen Abrufschritt an den Anfang und speichern Sie typisierte Erinnerungen, während der Job läuft: Entscheidungen, Korrekturen, Stolperfallen, Abläufe. Legen Sie fest, was jede Kategorie speist. Schalten Sie die automatische Erfassung von Entscheidungen, Fortschritt und Korrekturen ein; sie bleibt aus, bis Sie sie für Ihren Workspace aktivieren.
Learning Capture zum letzten Schritt machen
Ergänzen Sie jeden Workflow um einen globalen letzten Schritt, der Entscheidungen, Stolperfallen und Muster speichert und festhält, wo neuer Code liegt. Lassen Sie ihn mit „no learnings to store“ überspringen, wenn ein Lauf nichts Neues gelehrt hat.
Den Workflow ändern, nicht den Prompt
Machen Sie aus jeder wiederkehrenden Lehre eine Zeile in dem Schritt, der sie gebraucht hat, oder einen neuen Schritt. Nehmen Sie eine chirurgische Änderung nach der anderen vor, validieren Sie sie, lesen Sie sie zurück und halten Sie die Begründung in einer Erinnerung fest, nicht im Schritt.
Lückensuchende Schritte ergänzen
Ermitteln Sie vor der Arbeit die maßgeblichen Standards und melden Sie Lücken, prüfen Sie danach die Einhaltung und führen Sie eine abschließende Lückenprüfung durch, die Kandidaten für Fehlermuster speichert. Beurteilen Sie jeden Fix als Klasse oder Einzelfall, und führen Sie für Plan-Reviews ein Fehlerregister echter Vorfälle mit höchstens 15 Einträgen pro Abschnitt.
Reibung sofort erfassen
Wenn etwas nicht auf Anhieb klappt, informieren Sie eine Person, suchen nach einem bestehenden Task und legen einen mit dem Tag discovered-during-execution an; dann schließen Sie den Task ab, an dem Sie gerade arbeiten. Verlagern Sie die Regeln, die nie versagen dürfen, etwa das Blockieren von Dateilöschungen, in die Hooks Ihres Agent-Harness.
Die Gedächtnis-Pipeline betreiben und ein Gate verlagern
Konsolidieren Sie Erinnerungen monatlich pro Kategorie mit vorherigem Probelauf, befördern Sie Kandidaten ins Fehlerregister, mustern Sie Einträge aus, die nie anschlagen, und schlagen Sie Änderungen an Standards, Workflows, Agenten und Anweisungsdateien vor. Übergeben Sie dann ein vorhersehbares Gate an eine protokollierte Entscheidung des Agenten, und lassen Sie Merges und Veröffentlichungen bei einer Person. Erstellen Sie ein kostenloses ConvOps-Konto unter https://my.convops.app/register und verbinden Sie Ihren Agenten unter https://convops.app/connect. Sie möchten es gemeinsam mit Ihrem Team aufbauen? Buchen Sie eine kostenlose Discovery Session unter https://neomanex.com/de/services.
Häufige Fragen
Was ist ein selbstverbesserndes KI-System?
Ein selbstverbesserndes KI-System ist ein Repository aus Standards, ein Gedächtnisspeicher und Workflows mit Gates, die die Lehren jedes abgeschlossenen Jobs in Regeln verwandeln, die der nächste Job liest. ConvOps enthält die Workflows, Gates und den Gedächtnisspeicher, auf denen wir unser System betreiben. Es lernt in sechs Ebenen, vom Gedächtnis, das vor jedem Job abgerufen wird, bis zu einer Pipeline, die das ganze System prüft. Das Modell ändert sich nie; die Dateien, Schritte und Erinnerungen drumherum schon.
Für wen ist ein selbstverbesserndes KI-System gedacht?
Ein selbstverbesserndes KI-System ist für Engineering-Leads, Platform- und Ops-Engineers und technische Gründer gedacht, die KI-Agenten für wiederkehrende Arbeit in Entwicklung, Content oder Betrieb einsetzen. ConvOps führt diese Arbeit als Tasks in Workflows mit Gates aus, sodass ein wiederholter Fehler zu einer schriftlichen Regel wird, samt Nachweis, wer sie freigegeben hat, und der nächste Job diese Regel liest, bevor er beginnt.
Ist eine selbstverbessernde KI ohne erneutes Training des Modells möglich?
Ja. In ConvOps landen die Lehren als typisierte Erinnerungen, Workflow-Schritte und schriftliche Standards, und die Gewichte des Modells werden nie angefasst, sodass jede Lehre lesbar und umkehrbar bleibt. Das System ändert weder das Modell noch seine eigenen Leitplanken: Eine Person gibt Merges, Veröffentlichungen, neue Regeln und Umstrukturierungen von Anweisungsdateien frei, und ein Hook blockiert das Löschen von Dateien.
Wie baue ich ein selbstverbesserndes KI-System auf?
Erstellen Sie unter my.convops.app/register ein kostenloses ConvOps-Konto und verbinden Sie den Agenten, den Sie bereits nutzen. Setzen Sie dann in einem Workflow einen Abrufschritt an den Anfang und einen Learning-Capture-Schritt (Erfassen der Lehren) an das Ende, und schalten Sie die automatische Erfassung von Entscheidungen und Korrekturen ein. Ergänzen Sie lückensuchende Schritte, die die Arbeit gegen Ihre Standards prüfen, legen Sie Reibung als Task an, sobald sie auftritt, und führen Sie monatlich eine Konsolidierung Ihrer Erinnerungen durch.
Wie verhindern Sie, dass Regeln und Erinnerungen grenzenlos wachsen?
ConvOps hält Erinnerungen in spezifischen Kategorien, ersetzt Wiederholungen schon beim Speichern und führt Beinahe-Duplikate in einer monatlichen Konsolidierung ab einer Ähnlichkeit von 0,85 zusammen. Die Task-Buchhaltung bleibt aus dem taskübergreifenden Abruf heraus. Ein Standard bekommt eine neue Regel nur für eine Klasse von Fehlern, nie für einen Einzelfall. Das Fehlerregister enthält höchstens 15 Einträge pro Abschnitt, und ein Eintrag, der über 5 aufeinanderfolgende Pläne nur PASS oder N/A (bestanden oder nicht anwendbar) liefert, wird ausgemustert.
Wer gibt eine Änderung an den Regeln frei?
In ConvOps hängt das von der Ebene ab. Agenten speichern Erinnerungen ohne Freigabe. Eine Klassenlücke in den Standards beurteilt der Agent und protokolliert sie als Aktivität, die eine Person lesen kann. Kleine Änderungen an Anweisungsdateien und Standards, etwa eine Zeile oder ein veralteter Wert, werden unter einem Standard direkt übernommen. Neue Regeln, Umstrukturierungen und Workflow-Änderungen brauchen eine Person, und Merges und Veröffentlichungen warten immer auf eine.
Worin unterscheidet sich ein selbstverbesserndes KI-System von einer Learnings-Datei?
Eine Learnings-Datei ist ein Sammelbecken, das grenzenlos wächst, und genau deshalb haben wir unsere eigene Gedächtniskategorie learnings für neue Erinnerungen abgekündigt. In ConvOps ist jede Lehre typisiert und landet in der Ebene, die sie nutzt: als abgerufene Entscheidung, als Workflow-Schritt, als Standard oder als Eintrag im Fehlerregister. Das Ganze ist begrenzt und wird konsolidiert, und der Abruf liefert nur die Erinnerungen, die zum Job passen.