
Das können Sie danach
- Festgelegte Regelnamen und einen nur berichtenden Auditor definieren, der Seite, Regel und Detail liefert, und seine Befunde als deduplizierte Bugs anlegen.
- Die Abfrage nach offenen Bugs als Pool speichern und den Executor wählen, der daraus abruft.
- Eine isolierte Umgebung mit minimalen Rechten schreiben: ein Repo, Tool-Allowlists, Schreibzugriff nur auf den eigenen Task, Credential-Referenzen, ein Dispatch-Limit.
- Bugs in Reparaturspuren und eine Wartespur leiten und jeden Schreibvorgang vor dem Schließen mit einem Re-Lint verifizieren.
- Ein Präventionsregister führen, das wiederholte Befunde in Prüfungen beim Schreiben verwandelt.
Das Wichtigste
- Ein KI-Agent für die selbstheilende Website liest, was beim Leser ankommt, legt jeden Fehler als Bug an und repariert nur, was er über die CMS-API umschreiben und danach erneut prüfen kann.
- Halten Sie Finden und Beheben getrennt: Ein nur berichtender Prüflauf legt Bugs an, und jeder Bug bekommt seinen eigenen Reparaturlauf in seiner eigenen isolierten Umgebung.
- Die Mechanik entscheidet über die Sicherheit: Ein Pool entscheidet, was bearbeitet wird, die Umgebung, was der Agent anfassen darf, der Workflow, wann er fertig ist.
- Eine Reparatur zählt erst, wenn ihre erneute Prüfung besteht: ein sauberer Re-Lint des gespeicherten Beitrags, ein aktualisierter Prüfstempel oder HTTP 200 mit dem eigenen Inhalt der Seite; alles, was der Agent nicht verifizieren kann, wartet auf eine Person.
- Ein Fehler, der immer wiederkommt, gehört in eine Ablehnung beim Schreiben, nicht in den Prüflauf der nächsten Woche.
Was der Loop für die selbstheilende Website tut
Eine Website heilt sich nur dort selbst, wo der Agent die Korrektur beweisen kann, und um genau diese Grenze haben wir den ganzen Mechanismus gebaut. Unser KI-Agent für die selbstheilende Website prüft die Live-Website jede Woche, legt jeden Fehler als Bug an und schickt jeden Bug in einen eigenen Lauf in einer isolierten Umgebung. Dieser Lauf schreibt um, was er über die CMS-API umschreiben kann, prüft die gespeicherte Seite erneut und schließt den Bug nur bei einer sauberen Prüfung. ConvOps steuert den Zeitplan, die Bug-Warteschlange und beide Workflows. Es ist einer der Loops, mit denen wir unser Unternehmen führen.
Eine selbstheilende Website ist eine Website, auf der ein Agent Fehler findet, die Leser sehen, und diejenigen repariert, die er verifizieren kann, während der Rest auf eine Person wartet. Sie ist keine selbstheilende Testsuite: Die repariert Selektoren in Tests, dieser Loop dagegen repariert die Inhalte, die ein Leser sieht.
Alle Ansichten und Zahlen unten verwenden Beispieldaten von Shutterlane, einer fiktiven Website mit Testberichten zu Kameraausrüstung, die zwei Personen unter shutterlane.example.com betreiben.
| Teil | Was es ist |
|---|---|
| Auslöser | Ein wöchentlicher Zeitplan, jeden Dienstag um 05:00 UTC |
| Eingaben | Live-Seiten, die CMS-API, die Entitätsdatenbank hinter den Modell- und Verzeichnisseiten |
| Bausteine | Der Prüflauf, der Bug-Pool, der Executor und seine isolierte Umgebung, der Reparatur-Workflow pro Bug |
| Ausgaben | Bugs, Reparaturen, zurückgehaltene Bugs, Präventionsvorschläge, ein Laufprotokoll in Git |
| Umfang | Schreibt absolute-self-link, dead-link und encoding-artifact in Beiträgen um. Prüft freshness und reader-error erneut. Hält counter-sanity, vocab-drift und jede Regel auf einem Seitentyp zurück, den er nicht schreiben kann |
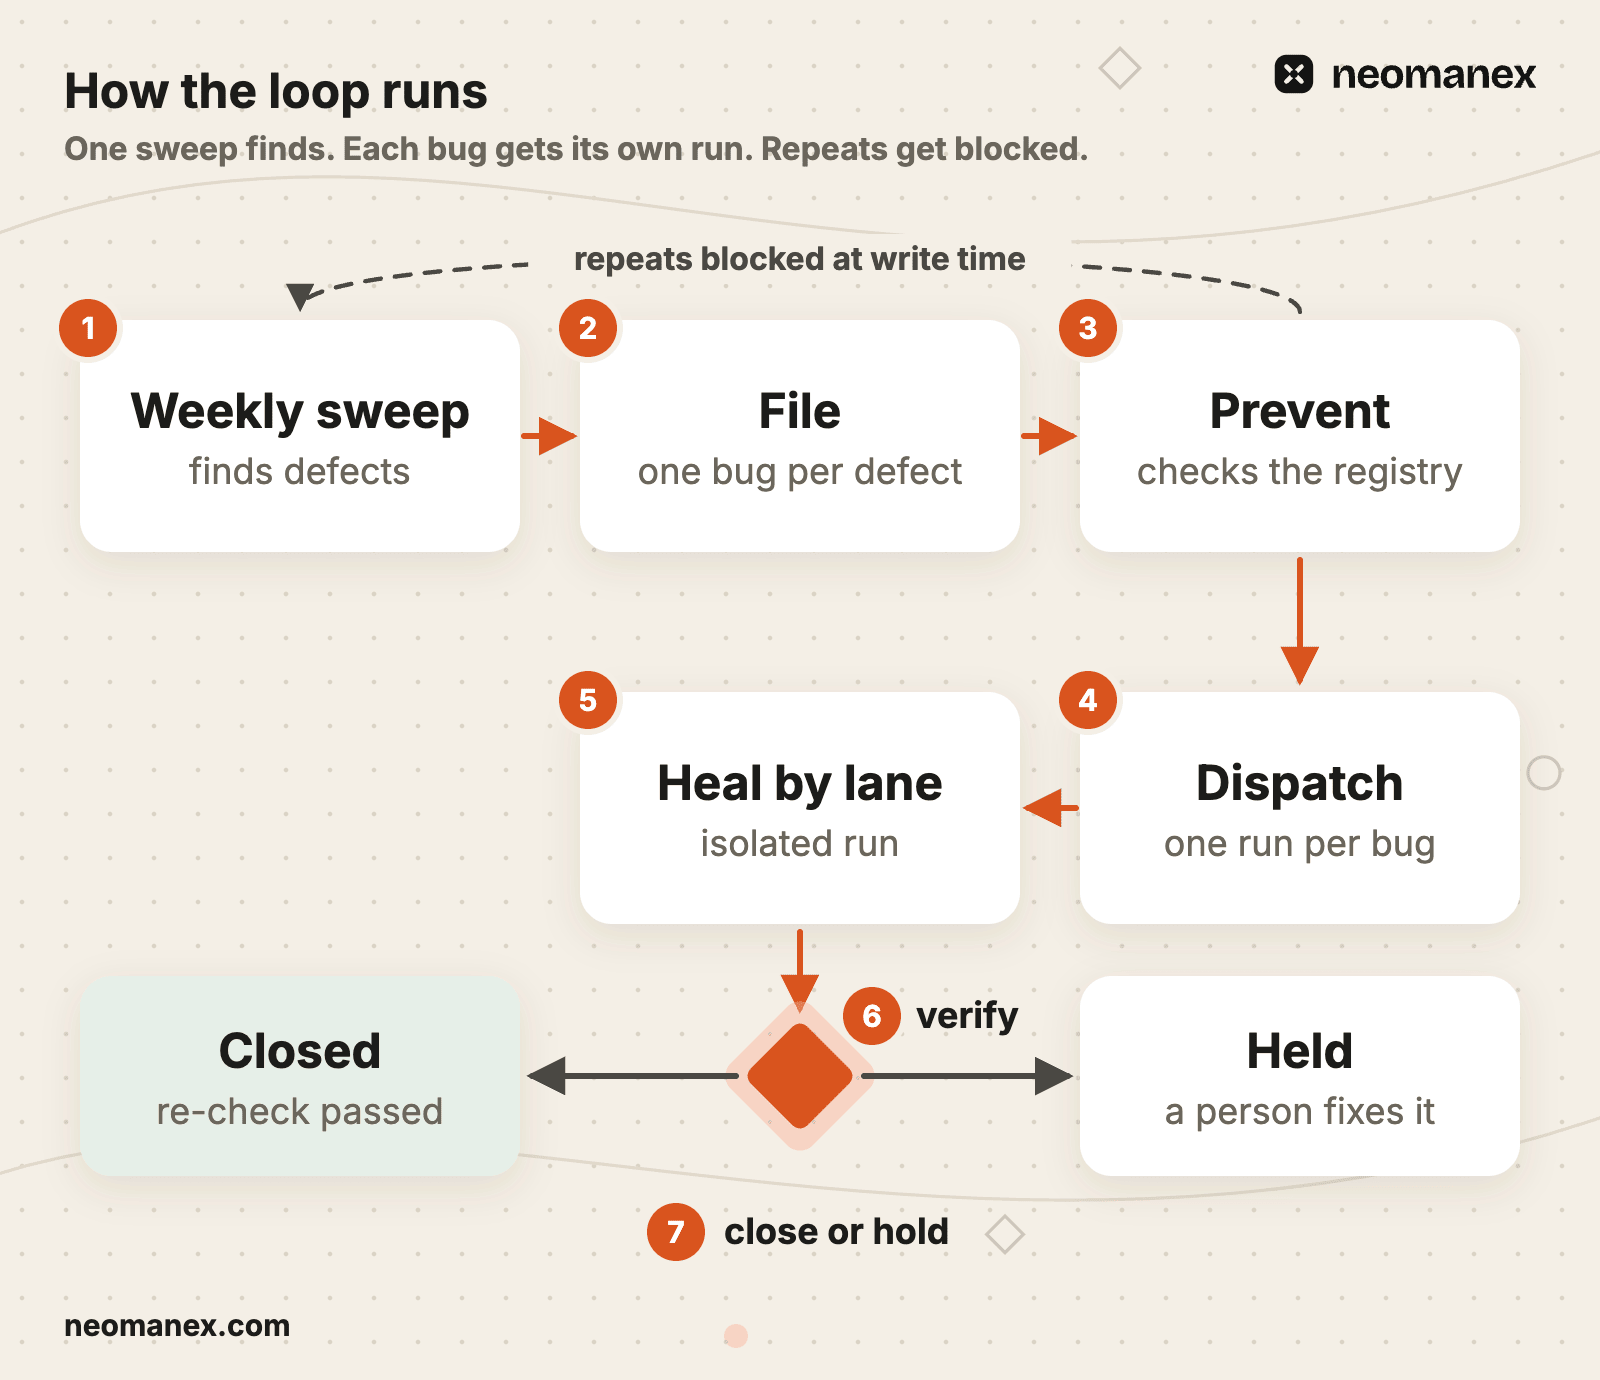
Der Prüflauf (Markierung 1) legt Befunde an (2), gleicht sie mit dem Präventionsregister ab (3) und verteilt offene Bugs (4). Jeder Bug wird in seiner Spur repariert (5), verifiziert (6) und dann geschlossen oder zurückgehalten (7).
Warum wir ihn gebaut haben: ein KI-Agent, der Inhaltsfehler auf der Website behebt
Ein QA-Agent, der nur berichtet, erzeugt nur Rauschen. Ein Agent, der in einem Lauf findet und behebt, benotet seine eigenen Hausaufgaben. Wir haben beides getrennt.
Unser Prüflauf berichtete anfangs nur. Er fand jede Woche dieselben kaputten Links und veralteten Seiten, und niemand war für die Korrektur zuständig. Das Diagramm zeigt dieses Muster auf Shutterlane-Daten: Ein Bug wird angelegt (Markierung 1), sammelt jeden Dienstag eine Wiederholungsnotiz (2) und wird nie repariert (3).

Daraus entstanden drei Prinzipien:
- Finden und Beheben sind getrennte Jobs. Der Prüflauf schreibt nie Inhalte, und die Reparatur beurteilt nie die Website.
- Ein Fehler ist eine Arbeitseinheit. Jeder neue Befund ist ein eigener Bug, und jeder Reparaturlauf gehört genau einem Bug.
- Erledigt heißt verifiziert. Ein Bug wird erst nach einer erneuten Prüfung der gespeicherten Seite geschlossen, nie auf das Wort des Agenten hin.
Wenn sich Ihre QA-Berichte genauso stapeln, sehen Sie sich an, wie ConvOps aus Befunden Bugs macht, die Executors einzeln abarbeiten(wird in einem neuen Tab geöffnet).
So läuft er: Pool, Executor, Umgebung, Workflow
Das Modell ist der uninteressanteste Teil. Der Pool entscheidet, was bearbeitet wird, die Umgebung, was der Agent anfassen darf, der Workflow, wann er fertig ist. Zwei Workflows tragen die Arbeit: der Prüf-Workflow WF-qa und der Reparatur-Workflow WF-bugfix. Es ist ein Graph aus Schritten und Gates, die Form, die wir in Was ist Graph Engineering? beschreiben, derselbe Loop mit Gates und Zeitplan wie bei unseren SEO-Experimenten mit Claude Code und die Antwort auf Agent Sprawl.

Befunde werden zu Bugs in einem Pool
Ein Pool ist eine gespeicherte Abfrage in ConvOps: ein Filter über Task-Typ, Tags, Projekt, Horizont und Status, dazu eine Sortierung. Er enthält nie Tasks; er löst sich bei jeder Abfrage in die passenden auf, sodass Bugs aus jedem Projekt in jedem passenden Pool landen. pools_next liefert den einen obersten Task, entscheidet Gleichstände nach Task-ID und schreibt pro Aufruf eine Abrufzeile, sodass jeder Abruf nachvollziehbar ist.
Shutterlanes Pool open-qa-bugs lautet type = bug AND tags contains qa-finding AND status in [backlog, todo], die ältesten zuerst (Markierung 1).
Executors übernehmen die Arbeit
Ein Executor ist ein benannter Runner, optional an den Pool gebunden, aus dem er abruft (Markierung 2). Es gibt genau zwei Arten:
| Art | So läuft ein Dispatch |
|---|---|
| Isoliert | ConvOps startet Claude Code oder OpenCode in einer Version aus seinem Katalog als eigenen Kubernetes Job |
| Lokal | Ein Coding-Agent auf einem Rechner, etwa Claude Code oder Kimi Code CLI, verbindet sich mit ConvOps, übernimmt das Dispatch-Paket und führt den Task dort aus |
Unser Loop läuft auf einem isolierten Claude-Code-Executor, der im Zeitplan benannt ist. Der Verteilschritt des Prüflaufs führt die Abfrage in Pool-Form selbst aus und schickt jeden Bug an diesen Executor; wird der Executor an einen Pool gebunden, übernimmt ConvOps denselben Abruf. Ein hängender Lauf wird bei time_limit_s beendet (pro Executor 60 bis 86.400 Sekunden, sonst gilt die Workspace-Einstellung: hier 14.400).
Isolierte Umgebungen begrenzen, was der Agent anfassen darf
Eine isolierte Umgebung ist die schriftliche Definition von allem, was ein Lauf anfassen darf. Jeder Lauf ist ein Kubernetes Job, angelegt im angehaltenen Zustand; ein Secret pro Lauf, das dem Job gehört, kommt vor dem Start hinzu. Ein Task-Volume bewahrt den Arbeitsordner des Tasks über seine Läufe hinweg. Der Job wird 300 Sekunden nach seinem Ende entfernt und das Secret mit ihm, sodass Credentials den Lauf nie überdauern.

- Repos. Genau eines erhält Arbeit und wird immer gepusht (Markierung 1): direkt auf die ausgecheckte Ref, einmal neu angewendet, nie erzwungen.
- Tool-Regeln. Der CMS-Server verweigert standardmäßig alles und erlaubt 8 Tools (Markierung 2). Der Browser erlaubt nur lesende Tools: navigate, snapshot, screenshot und drei weitere.
- Referenzen statt Werte.
CMS_API_TOKENverweist auf einen Eintrag in einem Secret Manager (Markierung 3), und auch das Credential des Executors ist eine gespeicherte Referenz (Markierung 4). Markierung 5 ist die Pool-Bindung. - ConvOps-Berechtigungen. Schreibzugriffe auf Tasks erreichen nur den eigenen Task des Laufs. Notizen und Lesezugriffe erreichen jeden Task, sodass der Prüflauf Bugs kommentieren kann, aber nur ein Reparaturlauf schließt seinen eigenen Bug.
- Dispatch-Limits.
run_dispatch_limitliegt bei 10 pro Lauf, das begrenzt Kosten und Schadensradius eines Prüflaufs.run_dispatch_named_environmentist false, sodass ein Lauf die Sandbox dessen, was er verteilt, nicht erweitern kann.
Zwei Workflows: einer findet, einer behebt
| # | Prüfschritt | Wer ihn ausführt | Gate |
|---|---|---|---|
| 1 | recall-scope | Lauf-Agent | Kein Ziel-Host: einen Bug für den roten Lauf anlegen und anhalten |
| 2 | scan-audit | qa-auditor, nur berichtend | Sieben festgelegte Regelnamen. Ein fehlgeschlagener Lesevorgang ist ein reader-error |
| 3 | file-findings | Lauf-Agent | qa-dedupe auf (page, rule): Neues legt einen Bug an, eine Wiederholung fügt eine Notiz hinzu |
| 4 | prevent | Lauf-Agent | Durchschlupf oder Lücke: ein prevention-proposal pro Regel |
| 5 | dispatch-bugs | Lauf-Agent | Die ältesten zuerst, Stopp beim Dispatch-Limit |
| 6 | finalize | Lauf-Agent | Laufprotokoll committen, eine Erinnerung speichern |
| # | Reparaturschritt | Wer ihn ausführt | Gate |
|---|---|---|---|
| 1 | read-bug | Lauf-Agent | Wählt die Spur. hold setzt blocked (blockiert) und hält an |
| 2 | heal-post | Lauf-Agent | Ein versionsgeschützter Schreibvorgang, dann ein sauberer Re-Lint |
| 3 | heal-freshness | verifier | Allgemeiner Prüfstempel am oder nach dem Erstellungsdatum des Bugs |
| 4 | heal-reader | Lauf-Agent | HTTP 200 mit dem eigenen Inhalt der Seite |
| 5 | close | Lauf-Agent | Repariert: abgeschlossen. Sonst blocked mit Begründung |
Der Auditor liest Seiten so, wie sie beim Leser ankommen: manche im Browser gerendert, die übrigen als rohes HTML, wobei Zähler und Aktualität mit der Datenbank abgeglichen werden. Das Aktualitätsversprechen beträgt 7 Tage für Kameramodelle und 14 für Verzeichniseinträge, der Takt, in dem ihre Prüf-Loops laufen.


Der Zeitplan (Markierung 1) lautet FREQ=WEEKLY;BYDAY=TU;BYHOUR=5;BYMINUTE=0. Wöchentlich passt zum 7-Tage-Aktualitätsversprechen, sodass ein Befund noch aktuell ist, wenn seine Reparatur läuft.
Ein Lauf Schritt für Schritt: ein Bug vom Befund bis zur verifizierten Korrektur
Das Spannende an einer Reparatur ist die Prüfung nach dem Schreiben, nicht das Schreiben selbst. Hier ist Shutterlanes Prüflauf qa/2026-09-15, vom Zeitplan bis zum Ergebnis.
Dienstag, 05:00 UTC: Der Prüflauf findet Fehler und legt Bugs an
Der Prüflauf läuft auf isolated-sonnet in einem Job mit shutterlane-qa. Der Auditor liest 24 Seiten (6 im Browser, 18 als rohes HTML) und liefert 7 Befunde, einen pro Regel.

Dieser Befund ist neu und wird deshalb zum Bug demo0101, absolute-self-link: /blog/best-travel-cameras-2026, Status todo (zu erledigen). Der Lauf protokolliert qa-dedupe: 5 novel, 2 recurrences; jede Wiederholung fügt ihrem offenen Bug eine Notiz hinzu.
Der Präventionsschritt liest das Register. absolute-self-link ist covered (abgedeckt), und der Beitrag ist 3 Tage alt, also innerhalb des 7-Tage-Fensters für Durchschlüpfe. Deshalb legt der Prüflauf die Idee demo0110 als prevention-proposal an.
Der Verteilschritt listet die offenen QA-Bugs auf, die ältesten zuerst: 7, innerhalb des Limits von 10. Jeder geht an isolated-sonnet, ohne dass eine Umgebung genannt wird, und erhält so die Standardumgebung seines Projekts.
Ein Bug, ein Lauf

demo0101 erhält einen eigenen Job, run-demoex01, und ein eigenes Volume. read-bug wählt die Spur nach Seitentyp und Regel: Ein Self-Link auf einer /blog/-Seite gehört zu post. Er schreibt bugfix-demo0101/2026-09-15 lane=post, bevor er irgendetwas anfasst.
Ein geschützter Schreibvorgang

heal-post führt post-lint aus, das das fehlerhafte Ziel und seine Korrektur benennt. Dann folgt ein verankerter body_md_edits-Replace, geschützt durch die gelesene expected_version. Er übergibt nie status, sodass eine Reparatur eine Seite nie veröffentlichen oder depublizieren kann.
Bei einem Versionskonflikt liest der Agent einmal neu und baut die Änderung neu auf; eine zweite Ablehnung endet als not healed (nicht repariert). Ein toter Link ohne bekannte Adresse wird entfernt, sein Linktext bleibt erhalten. Einen Link zu entfernen ist sicher; ein Ziel zu raten nicht.
Repariert oder zurückgehalten

Der Agent liest den gespeicherten Beitrag erneut und lintet ihn neu. Repariert heißt: Die Regel hat keinen Befund mehr UND das fehlerhafte Ziel ist aus dem gespeicherten Text verschwunden, denn der Lint kann ein Ziel übersehen, das der Auditor gesehen hat. Die Notiz lautet healed: https://shutterlane.example.com/models/orrin-k5 -> /models/orrin-k5, das Laufprotokoll wird committet, der Bug wird abgeschlossen, und Job und Secret verschwinden 300 Sekunden später.
Rechts landet demo0104 (counter-sanity: /news) in hold. Er wird auf blocked gesetzt, mit der Begründung „needs a product or operator fix“ (braucht eine Korrektur am Produkt oder durch das Betriebsteam), der Inhalt bleibt unberührt.
So sieht das Ergebnis aus: Bericht, Notizen, Register
Lesen Sie den Prüflauf nach Status, nicht nach Anzahl. Eine Wiederholung bei einer abgedeckten Regel ist ein Fehler in Ihrer Schutzprüfung, nicht in Ihren Inhalten.

| Artefakt | Spalten | So lesen Sie es |
|---|---|---|
| Prüfbericht | Seite, Regel, Detail, neu oder Wiederholung, Spur | Neue Zeilen sind neue Bugs. Wiederholungen sind Notizen an offenen Bugs |
| Notizverlauf des Bugs | Lauf-ID, Spur, healed: oder not healed: mit Begründung | Die Entscheidung eines Laufs, lesbar ohne das Transkript |
| Präventionsregister | Regel, covered / partial / uncovered, verhindert durch, Reparaturspur | Wo jede Regel gestoppt wird, bevor sie die Website erreicht |
Zwei Signale steuern den Präventionsschritt:
- Durchschlupf: eine abgedeckte Regel in einem
/news/- oder/blog/-Beitrag, der innerhalb von 7 Tagen veröffentlicht wurde. Nur ein neuer Beitrag beweist, dass die Schutzprüfung beim Schreiben ihn durchgelassen hat. - Lücke: eine teilweise oder nicht abgedeckte Regel auf 2 oder mehr Seiten in einem Lauf oder eine, die wiederkehrt. Eine Seite ist ein Fehler; zwei Seiten oder eine Wiederholung sind ein Muster.
Jede Regel bekommt einen Vorschlag; ein offener Vorschlag bekommt eine Notiz, nie eine zweite Idee.
Im Shutterlane-Bericht ist encoding-artifact covered und kehrte trotzdem auf /directory wieder: Die Schutzprüfung leckt über einen älteren Veröffentlichungsweg. Genau dieses Muster haben wir erlebt, und daraus entstand eine zweite Schutzprüfung: post-lint am Veröffentlichungs-Gate zusätzlich zu den Ablehnungen beim Schreiben in den CMS-Tools. Jedes Laufprotokoll landet in Git, der Nachweis, den wir in KI-Agenten-Observability beschreiben.
Was schiefgeht: eine Regel, drei Schreibweisen
Die meisten unserer Fehler lagen in der Verkabelung und den Berechtigungen, nicht im Modell. Der schlimmste sah aus wie ein funktionierender Loop.
Die Deduplizierung arbeitet mit dem Schlüssel (page, rule). Unser Auditor formulierte Regelnamen frei und schrieb eine Prüfung über mehrere Läufe hinweg auf drei Arten. Die Deduplizierung sah drei Regeln und legte drei Bugs für einen Fehler an. Auf Shutterlane-Daten: dead-link, broken-link und dead-internal-link auf /news/corvane-x2-firmware-3 wurden zu demo0081, demo0084 und demo0087.

Die Regel, die daraus entstand, ist eine Zeile in der Karte des Auditors: „rule ist genau einer von encoding-artifact, dead-link, absolute-self-link, counter-sanity, vocab-drift, freshness, reader-error; nie eine Variante.“ Jetzt ist ein Link ein Bug mit einer Wiederholungsnotiz pro Lauf.
| Kleinerer Fehler | Regel, die daraus entstand |
|---|---|
| Ein Lauf erreichte nur seinen eigenen Task und konnte andere Bugs daher weder schließen noch kommentieren | Berechtigungen pro Umgebung: Notizen und Lesezugriffe auf jeden Task, tasks_dispatch und tasks_list an, Schreibzugriffe nur auf den eigenen Task, Dispatch auf 10 begrenzt |
| Eine reine Preisprüfung aktualisierte den allgemeinen Aktualitätsstempel einer Entität nicht | Eine Aktualitätsreparatur braucht eine content- oder status-Prüfung; repariert heißt, last_verified_date wurde aktualisiert |
| Die Deduplizierung erkannte die eigene Protokollzeile des Laufs als Treffer und verwarf jeden Befund | Ein Korpuseintrag, der mit den eingehenden Befunden identisch ist, wird übersprungen, nie als Treffer gewertet |
Bauen Sie Ihren eigenen: die Minimalversion
Beginnen Sie mit der Wartespur und den Tool-Berechtigungen. Legen Sie fest, was der Agent nie anfassen darf, bevor Sie ihn irgendetwas anfassen lassen.

Halten Sie das Lint-Skript vom Netzwerk fern: Unseres beurteilt Links anhand der Routentabelle und der Entitätslisten, sodass sein Urteil exakt reproduzierbar ist. Die Wartespur ist das menschliche Gate aus KI-Systeme mit Human in the Loop bauen. Die Spurtabelle zum Kopieren:
lanes:
  post:       # rewrite through the CMS API, then re-lint
    rules: [absolute-self-link, dead-link, encoding-artifact]
    pages: ["/blog/<slug>", "/news/<slug>"]
  freshness:  # re-verify; healed when the general stamp moves
    rules: [freshness]
    pages: ["/models/<slug>", "/directory/<slug>"]
  reader:     # re-read; healed on HTTP 200 with the page's own content
    rules: [reader-error]
  hold:       # everything else: blocked, a person fixes it
    rules: ["*"]
Die Umgebung zum Kopieren:
environment: shutterlane-qa
repos:
  - repo: shutterlane/site-ops
    receives_work: true
    push_target: ref
mcp_servers:
  shutterlane-cms:
    default: deny
    allow: [post_get, post_list, post_update,
            translations_manage, model_get, tool_get,
            verification_log_manage, verdict_history]
  playwright:
    default: deny
    allow: [browser_navigate, browser_snapshot,
            browser_take_screenshot, browser_console_messages,
            browser_wait_for, browser_close]
convops_tools_any_task: [task_notes_add, task_notes_list, tasks_get]
run_dispatch_limit: 10
run_dispatch_named_environment: false
secrets:
  CMS_API_TOKEN: {kind: gcp-sm, ref: demo-project/cms-token}
Kopieren Sie die Spurtabelle und die Umgebungsdefinition und planen Sie dann Ihren wöchentlichen Prüflauf in ConvOps(wird in einem neuen Tab geöffnet). Soll das auf Ihrer eigenen Website laufen? Buchen Sie eine kostenlose Discovery Session.
Schritte
Regelnamen festlegen
Listen Sie die exakten Regel-Slugs auf, die Ihr Auditor liefern darf, und verbieten Sie jede Variante, damit die Deduplizierung nach Seite und Regel über alle Läufe hinweg funktioniert.
Einen nur berichtenden Auditor ausführen
Lassen Sie ihn Seiten so lesen, wie sie beim Leser ankommen, und pro Fehler einen Befund mit Seite, Regel und Detail liefern. Er schreibt nie Inhalte.
Nach Seite und Regel deduplizieren
Ein neuer Befund wird zu einem Bug mit dem Titel Regel: Seite. Eine Wiederholung fügt dem offenen Bug eine Notiz hinzu, statt einen zweiten Bug anzulegen.
Die Abfrage nach offenen Bugs als Pool speichern
Filtern Sie nach Typ bug (Fehler), Ihrem QA-Tag und dem Status backlog oder todo (zu erledigen), die ältesten zuerst, damit jeder Abruf dieselbe deterministische Abfrage ist.
Die isolierte Umgebung definieren
Ein Repo, das Arbeit erhält, der CMS-MCP-Server mit Tool-Allowlist, ein nur lesender Browser, Schreibzugriffe auf den eigenen Task des Laufs, Credentials als Referenzen und ein Dispatch-Limit.
Den Executor definieren
Wählen Sie den Coding-Agenten und seine Version, das Modell und eine Credential-Referenz und binden Sie ihn dann an den Pool oder nennen Sie ihn im Zeitplan.
Den Reparatur-Workflow mit Wartespur schreiben
Leiten Sie jeden Bug nach Regel und Seitentyp in eine Spur. Alles, was Sie nicht umschreiben und erneut prüfen können, kommt in die Wartespur und wird mit Begründung blockiert.
Einmal geschützt schreiben, dann neu linten
Schreiben Sie einmal mit der gelesenen Version und ändern Sie nie den Status. Schließen Sie den Bug erst, wenn der Re-Lint sauber und das fehlerhafte Ziel verschwunden ist.
Ein Präventionsregister führen
Markieren Sie jede Regel als covered (abgedeckt), partial (teilweise) oder uncovered (nicht abgedeckt) und machen Sie aus Durchschlüpfen und Wiederholungen Ablehnungen beim Schreiben in Ihrem CMS.
Den Prüflauf wöchentlich planen
Lassen Sie ihn an einem festen Tag zu einer festen Uhrzeit laufen und seinen Verteilschritt offene Bugs, die ältesten zuerst, bis zum Dispatch-Limit verschicken.
Häufige Fragen
Was ist eine selbstheilende Website?
Eine selbstheilende Website ist eine Website, auf der ein KI-Agent Seiten so liest, wie sie beim Leser ankommen, jeden Fehler als Bug anlegt, repariert, was er umschreiben und erneut prüfen kann, und den Rest für eine Person zurückhält. ConvOps steuert den wöchentlichen Prüflauf, den Bug-Pool und den Reparatur-Workflow pro Bug. Sie ist keine selbstheilende Testsuite, die Selektoren in automatisierten Tests repariert.
Für wen eignet sich ein Loop für die selbstheilende Website?
Ein Loop für die selbstheilende Website eignet sich für kleine Teams, die eine Content-Website über eine CMS-API betreiben: Gründer, Content- und Marketing-Teams und kleine Entwicklungsteams. ConvOps plant den wöchentlichen Prüflauf, und der Prüflauf startet pro Bug einen Reparaturlauf. So werden kaputte Links, Kodierungsfehler und veraltete Entitätsseiten jede Woche repariert und erneut geprüft. Abweichende Zähler und Begriffsdrift erreichen eine Person als blockierte Bugs mit Begründung.
Worin unterscheidet sich eine selbstheilende Website von selbstheilenden Tests?
Selbstheilende Tests reparieren kaputte Selektoren in einer Testsuite, damit automatisierte Tests weiter bestehen. Ein Loop für die selbstheilende Website in ConvOps repariert die Inhalte, die ein Leser auf Live-Seiten sieht: Links, Kodierung und veraltete Fakten. Er läuft als geplante Workflows, die über die CMS-API schreiben, die gespeicherte Seite erneut prüfen und alles, was sie nicht verifizieren können, für eine Person zurückhalten.
Wie finde und behebe ich kaputte Links auf meiner Website automatisch?
Fügen Sie Ihrem KI-Client den ConvOps-MCP-Server unter https://mcp.convops.app/ hinzu und melden Sie sich einmal an. Legen Sie dann einen wöchentlichen Prüf-Workflow an, dessen Auditor für jeden kaputten Link Seite, Regel und Detail liefert, und legen Sie jeden neuen Befund als Bug an. Schicken Sie jeden Bug in einen Reparaturlauf, der den Link auf seine bekannte Adresse umschreibt oder ihn entfernt und die gespeicherte Seite neu lintet, bevor der Bug geschlossen wird.
Kann ein KI-Agent Website-Bugs ohne menschliche Prüfung beheben?
Ja, bei Fehlern, die er umschreiben und verifizieren kann. In ConvOps schreibt der Reparatur-Workflow drei Link- und Kodierungsregeln in Beiträgen über die CMS-API um und schließt einen Bug erst nach einem sauberen Re-Lint. Der Agent veröffentlicht oder depubliziert nie eine Seite. Abweichende Zähler und Begriffsdrift gehen in eine Wartespur, wo der Bug mit Begründung blockiert wird und auf eine Person wartet.
Wie übernehmen KI-Agenten Bugs aus einer Warteschlange?
In ConvOps ist ein Pool eine gespeicherte Abfrage über Task-Typ, Tags, Projekt, Horizont und Status, die sich bei jeder Abfrage in die passenden Tasks auflöst. Der Aufruf pools_next liefert den einen obersten Task in der Sortierung des Pools und protokolliert den Abruf. Ein isolierter oder lokaler Executor führt jeden verteilten Bug aus, und jeder Reparaturlauf gehört genau einem Bug.
Wie isolieren Sie einen KI-Agenten, der Ihre Website bearbeitet, in einer Sandbox?
ConvOps führt jeden isolierten Dispatch als eigenen Kubernetes Job mit einem Secret pro Lauf aus, das mit dem Job entfernt wird. Die Umgebungsdefinition nennt ein Repo, das Arbeit erhält, MCP-Server mit Tool-Allowlists, Schreibzugriffe nur auf den eigenen Task des Laufs und ein Dispatch-Limit von 10 pro Lauf. Credentials werden als Referenzen gespeichert, nie als Werte.
Was hindert einen KI-Agenten daran, auf meiner Website eine falsche Korrektur vorzunehmen?
ConvOps führt die Reparatur als Workflow mit einem Gate nach jedem Schreibvorgang aus. Der Agent schreibt einmal pro Beitrag, geschützt durch die gelesene Version, und ändert nie den Status des Beitrags. Bei einem Konflikt liest er einmal neu, und eine zweite Ablehnung endet als nicht repariert. Ein toter Link ohne bekannte Adresse wird entfernt statt geraten, und der Bug wird nur bei einem sauberen Re-Lint geschlossen.