Das können Sie danach
- Ein Ledger-Repo mit einem Protokoll pro SEO-Experiment einrichten
- Seitenfamilien mit einer Zufallszuweisung per Seed in Test- und Kontrollgruppen aufteilen
- Ein Diff-in-Diff-Urteil lesen und entscheiden: behalten, verlängern oder zurücknehmen
- Einen täglichen Puls planen, der Search-Console-Daten als Snapshot sichert und fällige Experimente weckt
- Erkennen, welche Korrekturtypen Ihre Website überhaupt messen kann und welche nicht
Das Wichtigste
- Eine SEO-Korrektur zählt nur, wenn sich eine zufällig gezogene Kontrollgruppe unveränderter Seiten weniger bewegt hat als die geänderten Seiten.
- Schreiben Sie Hypothese, Metrik, Seitengruppen und Falsifikationskriterium vor der Änderung ins Ledger und bearbeiten Sie sie danach nie mehr.
- Ein Skript berechnet jede Metrik und jedes Urteil; Claude Code führt die Schritte aus und liest das Ergebnis.
- Nicht eindeutig ist auf einer kleinen Website ein normales Urteil: Der Loop verlängert einmal bis Tag 59 und schließt dann.
- Ein täglicher Puls ist die Uhr: Experimente ruhen bis zu einem Fälligkeitsdatum und werden an Tag 15 und Tag 31 geweckt.
Was der Loop für SEO-Experimente tut
SEO-Experimente sagen nur dann etwas aus, wenn sich die geänderten Seiten stärker bewegt haben als eine Gruppe unveränderter Seiten. Nach dieser Regel testen wir die SEO-Korrekturen auf unserer Website. Claude Code schreibt das Experimentprotokoll, bevor es eine Seite anfasst, ändert eine zufällig gezogene Testgruppe, lässt eine passende Kontrollgruppe unberührt, und ein Skript vergleicht beide an Tag 15 und Tag 31. ConvOps steuert das Ganze als geplante Tasks mit Workflows, und jede Änderung mergt ein Mensch. Es ist einer der Loops, mit denen wir unser Unternehmen führen.
Ein vorregistriertes SEO-Experiment ist eine Seitenänderung, deren Hypothese, Metrik, Seitengruppen und Falsifikationskriterium committet werden, bevor die Änderung live geht, und danach nie mehr bearbeitet werden. Eine Seitenfamilie ist eine Seite samt ihren Sprachvarianten (en, es, de). Familien sind die Einheit, die der Loop der Test- oder der Kontrollgruppe zuweist.
Alle Ansichten und Zahlen unten verwenden Beispieldaten von Tidewell, einer fiktiven Rechnungs-App unter tidewell.example.com.
| Teil | Was es ist |
|---|---|
| Auslöser | Vier Zeitpläne. Niemand startet einen Lauf von Hand |
| Eingaben | Seitendaten aus der Search Console, Abrufe durch KI-Crawler und menschliche Besuche aus der Website-Analyse |
| Agent-Laufzeit | Claude Code, eine isolierte Sitzung pro Lauf |
| Runner | ConvOps-Tasks, Workflows und Zeitpläne |
| Ausgaben | Snapshots, Experimentprotokolle, Recherche- und Strategie-Memos, alles in einem Ledger-Git-Repo |
| Menschliche Gates | Jedes Merge auf die Website und jedes Strategie-Memo |
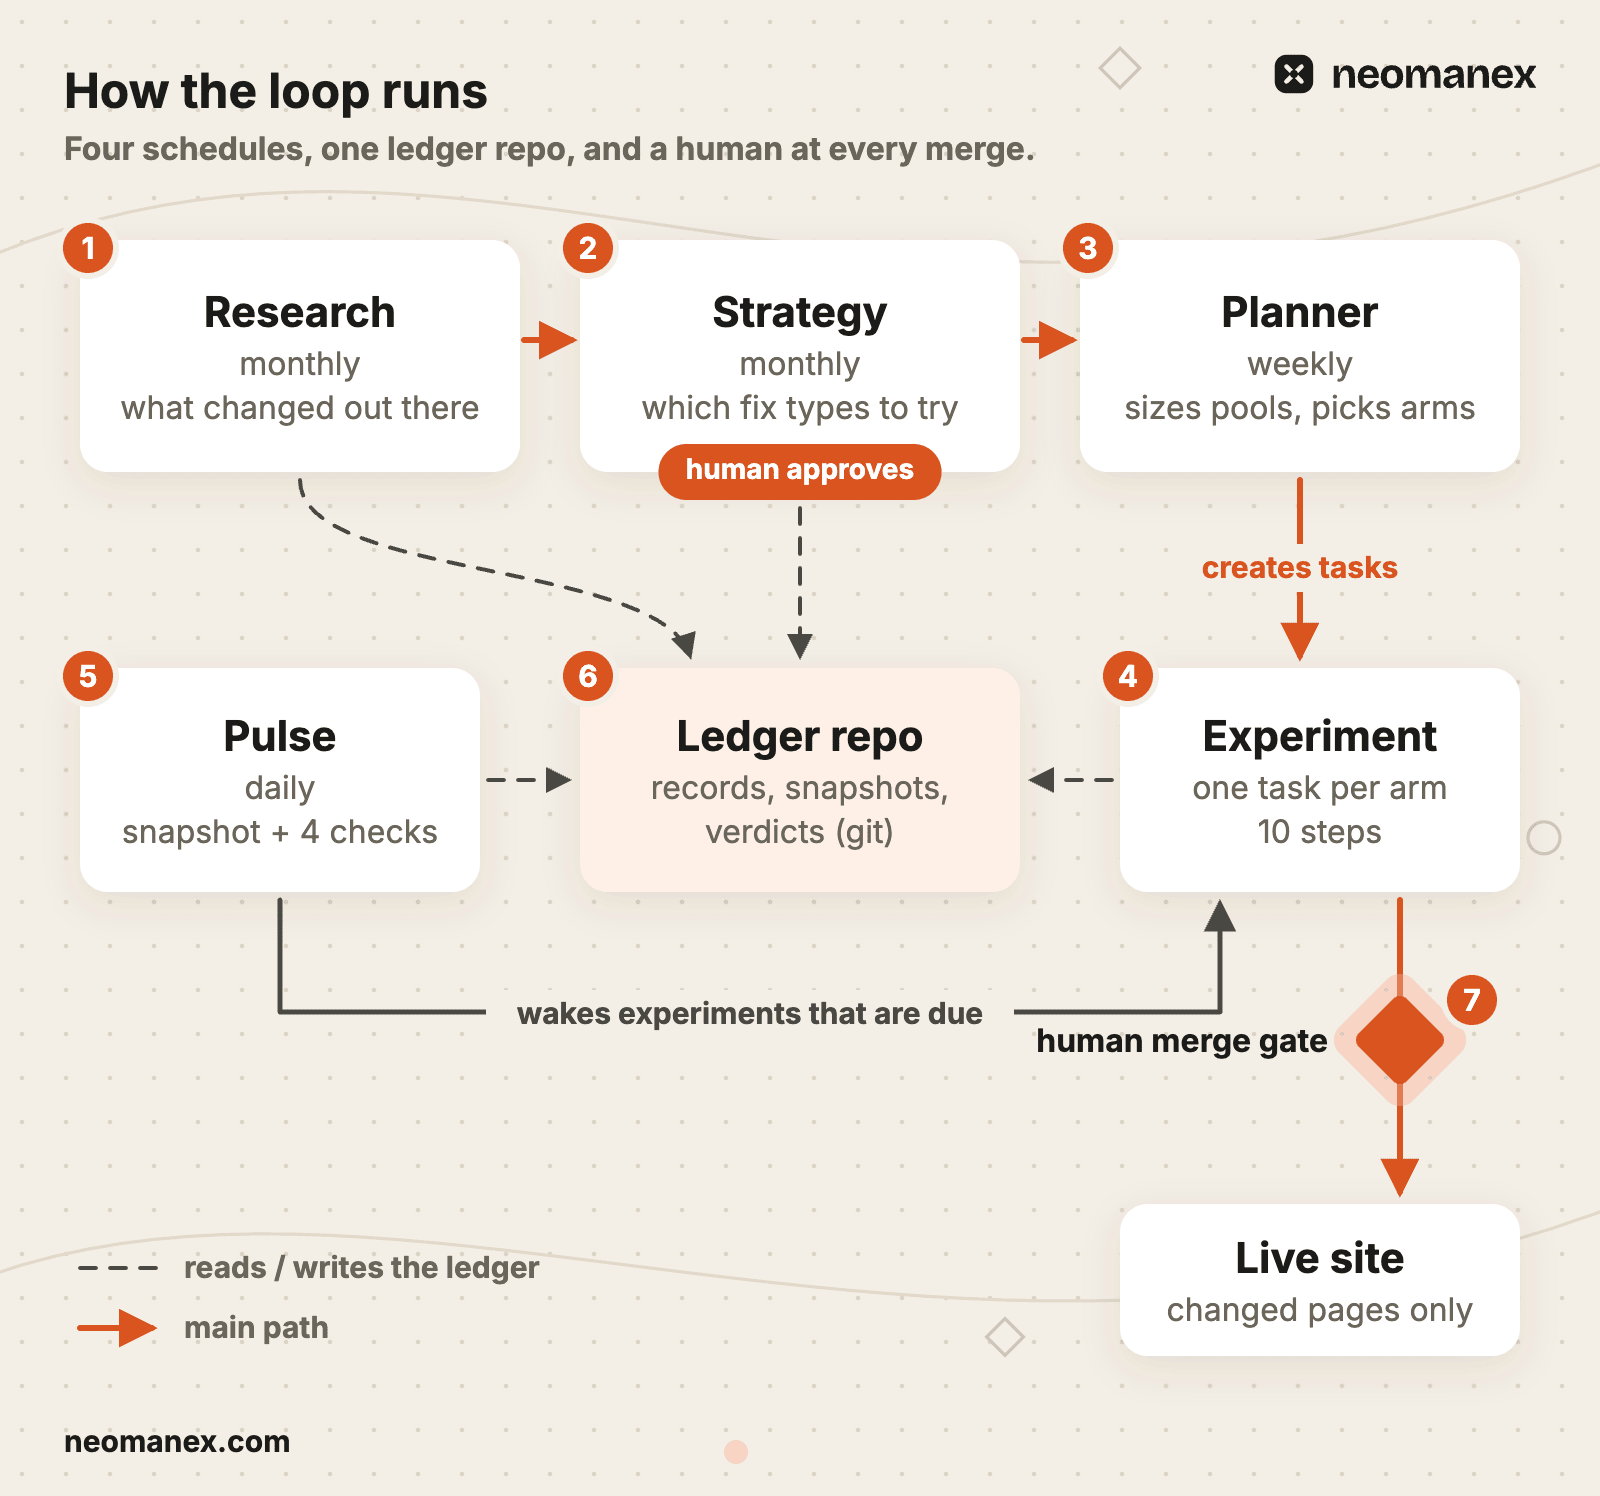
Vier Zeitpläne treiben ihn an: ein täglicher Puls, ein wöchentlicher Planer sowie monatliche Recherche und Strategie.
Warum wir ihn gebaut haben: Eine Seite ist Rauschen, und Agenten erfinden Zahlen
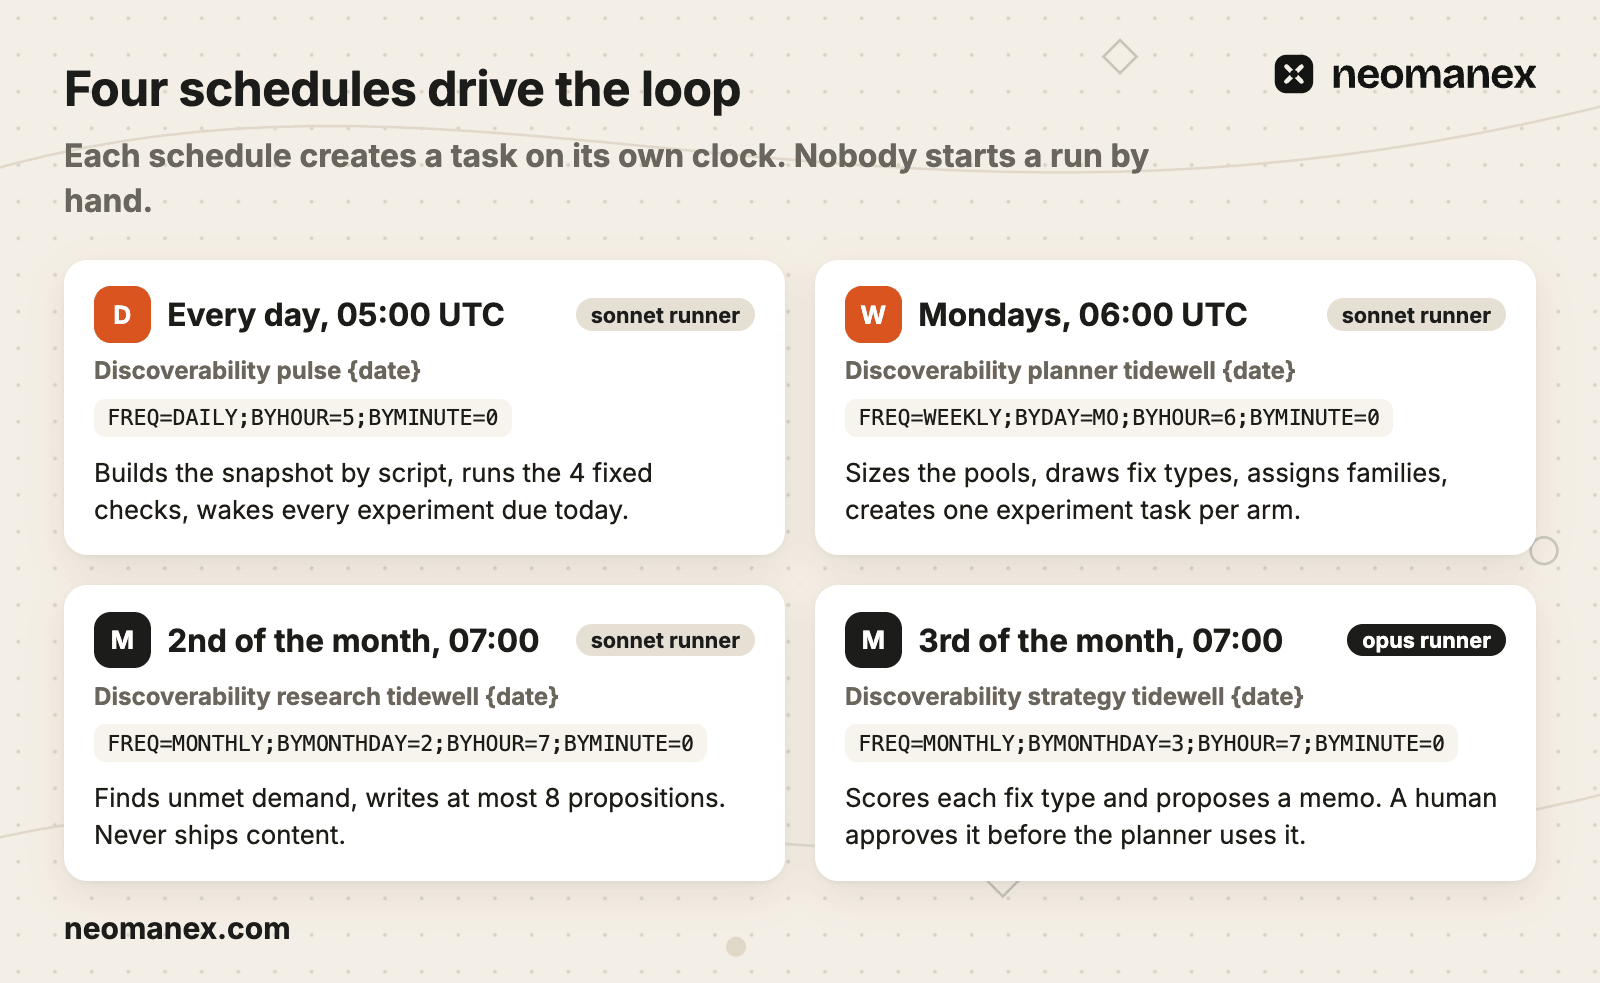
Die meisten SEO-Tests auf kleinen Websites führen Sie in die Irre: Eine Seite schwankt um ein Drittel, ohne dass sich etwas geändert hat. Google-Updates, Saisonalität, Crawl-Zeitpunkte und websiteweite Einbrüche bewegen eine Seite ganz von selbst. Ein Vorher-nachher-Diagramm einer einzelnen Seite kann eine Korrektur nicht von einer ruhigen Woche unterscheiden.
Die Antwort ist eine Kontrollgruppe von derselben Website, zufällig zum selben Zeitpunkt zugewiesen. Beide Gruppen erleben dieselben Bedingungen, also ist der Abstand zwischen ihnen der Effekt. Laut den Testrichtlinien von Google hängt die Dauer, die ein verlässlicher Test braucht, davon ab, wie viel Traffic die Website bekommt (Google Search Central, 2025(wird in einem neuen Tab geöffnet)). Dieser Loop ändert nie eine URL und fügt keine Weiterleitung hinzu, und eine kleine Website bekommt 28 gemessene Tage plus eine Verlängerung.
Das zweite Problem ist der Agent. Bitten Sie einen Agenten, „die Daten zu prüfen“, und er berechnet Verhältnisse, vergleicht sie mit Vergleichswerten, die er sich ausgedacht hat, und empfiehlt Änderungen. Unserer hat genau das getan. Deshalb berechnet ein Skript jede Metrik und jedes Urteil, und Claude Code führt die Schritte aus und liest die Ergebnisse.
Wenn Sie einen geplanten Loop wie diesen wollen, mit Schritten, Gates und menschlichen Freigaben, sehen Sie sich an, wie ConvOps ihn steuert(wird in einem neuen Tab geöffnet).
So läuft er: vier Zeitpläne, fünf Workflows
Ein Experiment-Loop ist nur so ehrlich wie seine Uhr, deshalb wartet hier nichts darauf, dass sich eine Person daran erinnert.
| Zeitplan | Wann (UTC) | Was er tut |
|---|---|---|
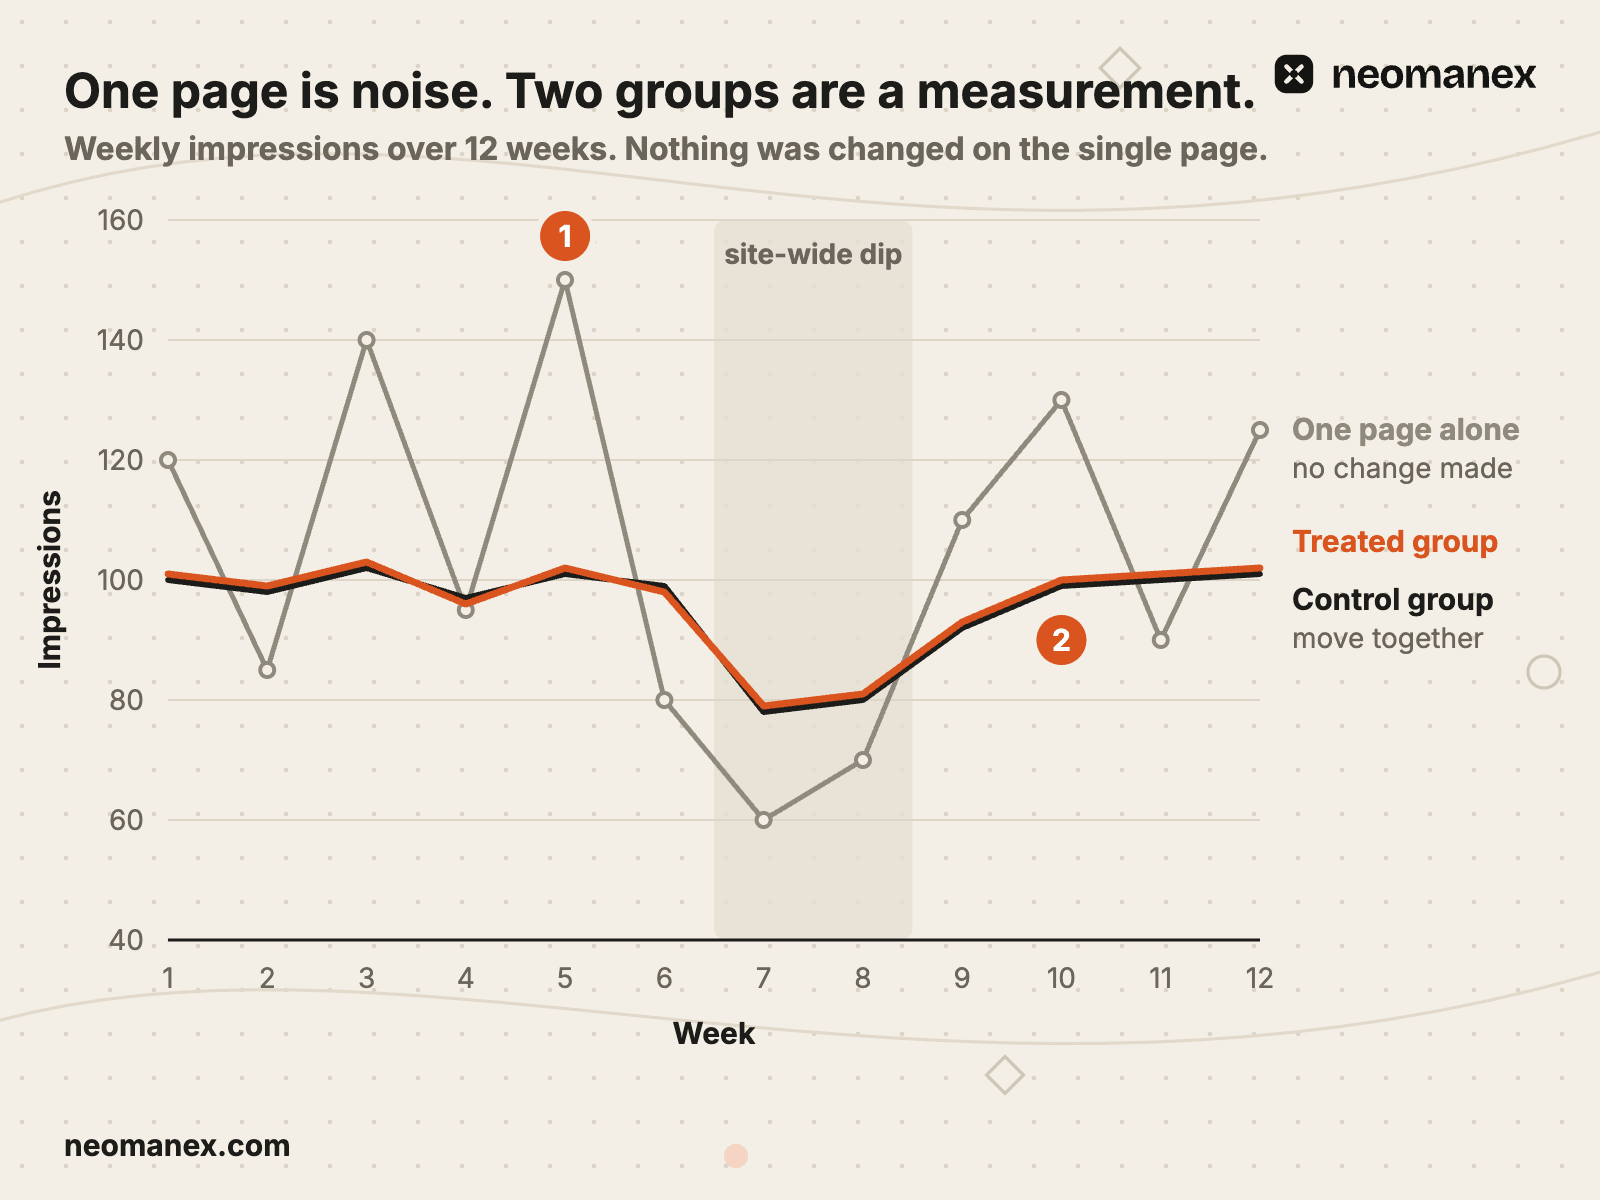
| Puls | Täglich um 05:00 | Lässt ein Skript einen Snapshot aus den Search-Console-Daten von vor drei Tagen erstellen (sie liegen in der Regel nach 2 bis 3 Tagen vor, Google Search Central, 2025(wird in einem neuen Tab geöffnet)), führt vier feste Prüfungen aus, weckt jedes heute fällige Experiment und meldet hängende |
| Planer | Jeden Montag um 06:00 | Bemisst die Pools, wählt Korrekturtypen, weist Familien zu und legt pro Arm einen Experiment-Task an |
| Recherche | Am 2. jedes Monats um 07:00 | Findet ungedeckte Nachfrage, schreibt höchstens 8 Vorschläge, veröffentlicht nie Inhalte |
| Strategie | Am 3. jedes Monats um 07:00 | Bewertet jeden Korrekturtyp und schlägt ein Memo zur menschlichen Freigabe vor |
Der Planer nutzt nur ein Strategie-Memo, dessen Freigabe-Task abgeschlossen ist. Ohne ein solches bleibt er bei seinen Standardwerten. Ein Memo steuert wochenlang Experimente, deshalb unterschreibt es eine Person.
Ein Pool ist die Menge der Familien, in denen eine Metrik messbar ist: Abrufe durch KI-Crawler, Google-Impressionen, Position oder Klickrate. Ein Arm ist ein Korrekturtyp, angewendet auf eine Gruppe von Seitenfamilien. Eine Welle ist die Menge der Arme, die an einem Montag gemeinsam starten und sich eine Kontrollgruppe teilen.
Jeder Arm ist ein eigener Task mit einem Workflow aus 10 Schritten, ein Graph aus Schritten und Gates, die Form, die wir in Was ist Graph Engineering? beschreiben.
| Schritt | Wer ihn ausführt | Gate |
|---|---|---|
| Register (Registrieren) | Claude Code | Ein echter Korrekturtyp und ein committetes Protokoll, sonst hält er an |
| Implement (Umsetzen) | Claude Code | Eine Variable, nur Testfamilien, Produktprüfungen bestanden |
| Static review (statische Prüfung) | Claude Code | Diff nur auf Testseiten, Längen von Titel und Meta-Beschreibung, genau eine H1. Zwei Ablehnungen legen einen Bug an |
| Ship (Ausliefern) | Mensch | Eine Person öffnet die Änderung und mergt sie |
| Go live (Livegang, Tag 0) | Claude Code | Änderung im Produktions-HTML verifiziert. Nicht innerhalb von 14 Tagen live: ungültig |
| Interim (Zwischenauswertung, Tag 15) | Urteilsskript, gelesen von Claude Code | Rollback bei Schaden, ungültig bei einem Google-Update, vorzeitiger Stopp bei einem starken Gewinn bei KI-Abrufen, sonst weiter bis Tag 31 |
| Final (Endauswertung, Tag 31) | Urteilsskript, gelesen von Claude Code | Gewinn, Verlust oder nicht eindeutig |
| Rollback | Claude Code, dann ein Mensch | Revert auf einem Branch, ein Mensch mergt, der nächste Lauf bestätigt, dass er live ist |
| Act (Handeln) | Claude Code | Ein Gewinn legt eine Replikationsidee an, nie ein neues Experiment |
| Learn (Lernen) | Claude Code | Eine Zeile mit der Erkenntnis im Protokoll |
Jedes Merge wartet auf eine Person, das menschliche Gate, das wir in KI-Systeme mit Human in the Loop bauen beschreiben.
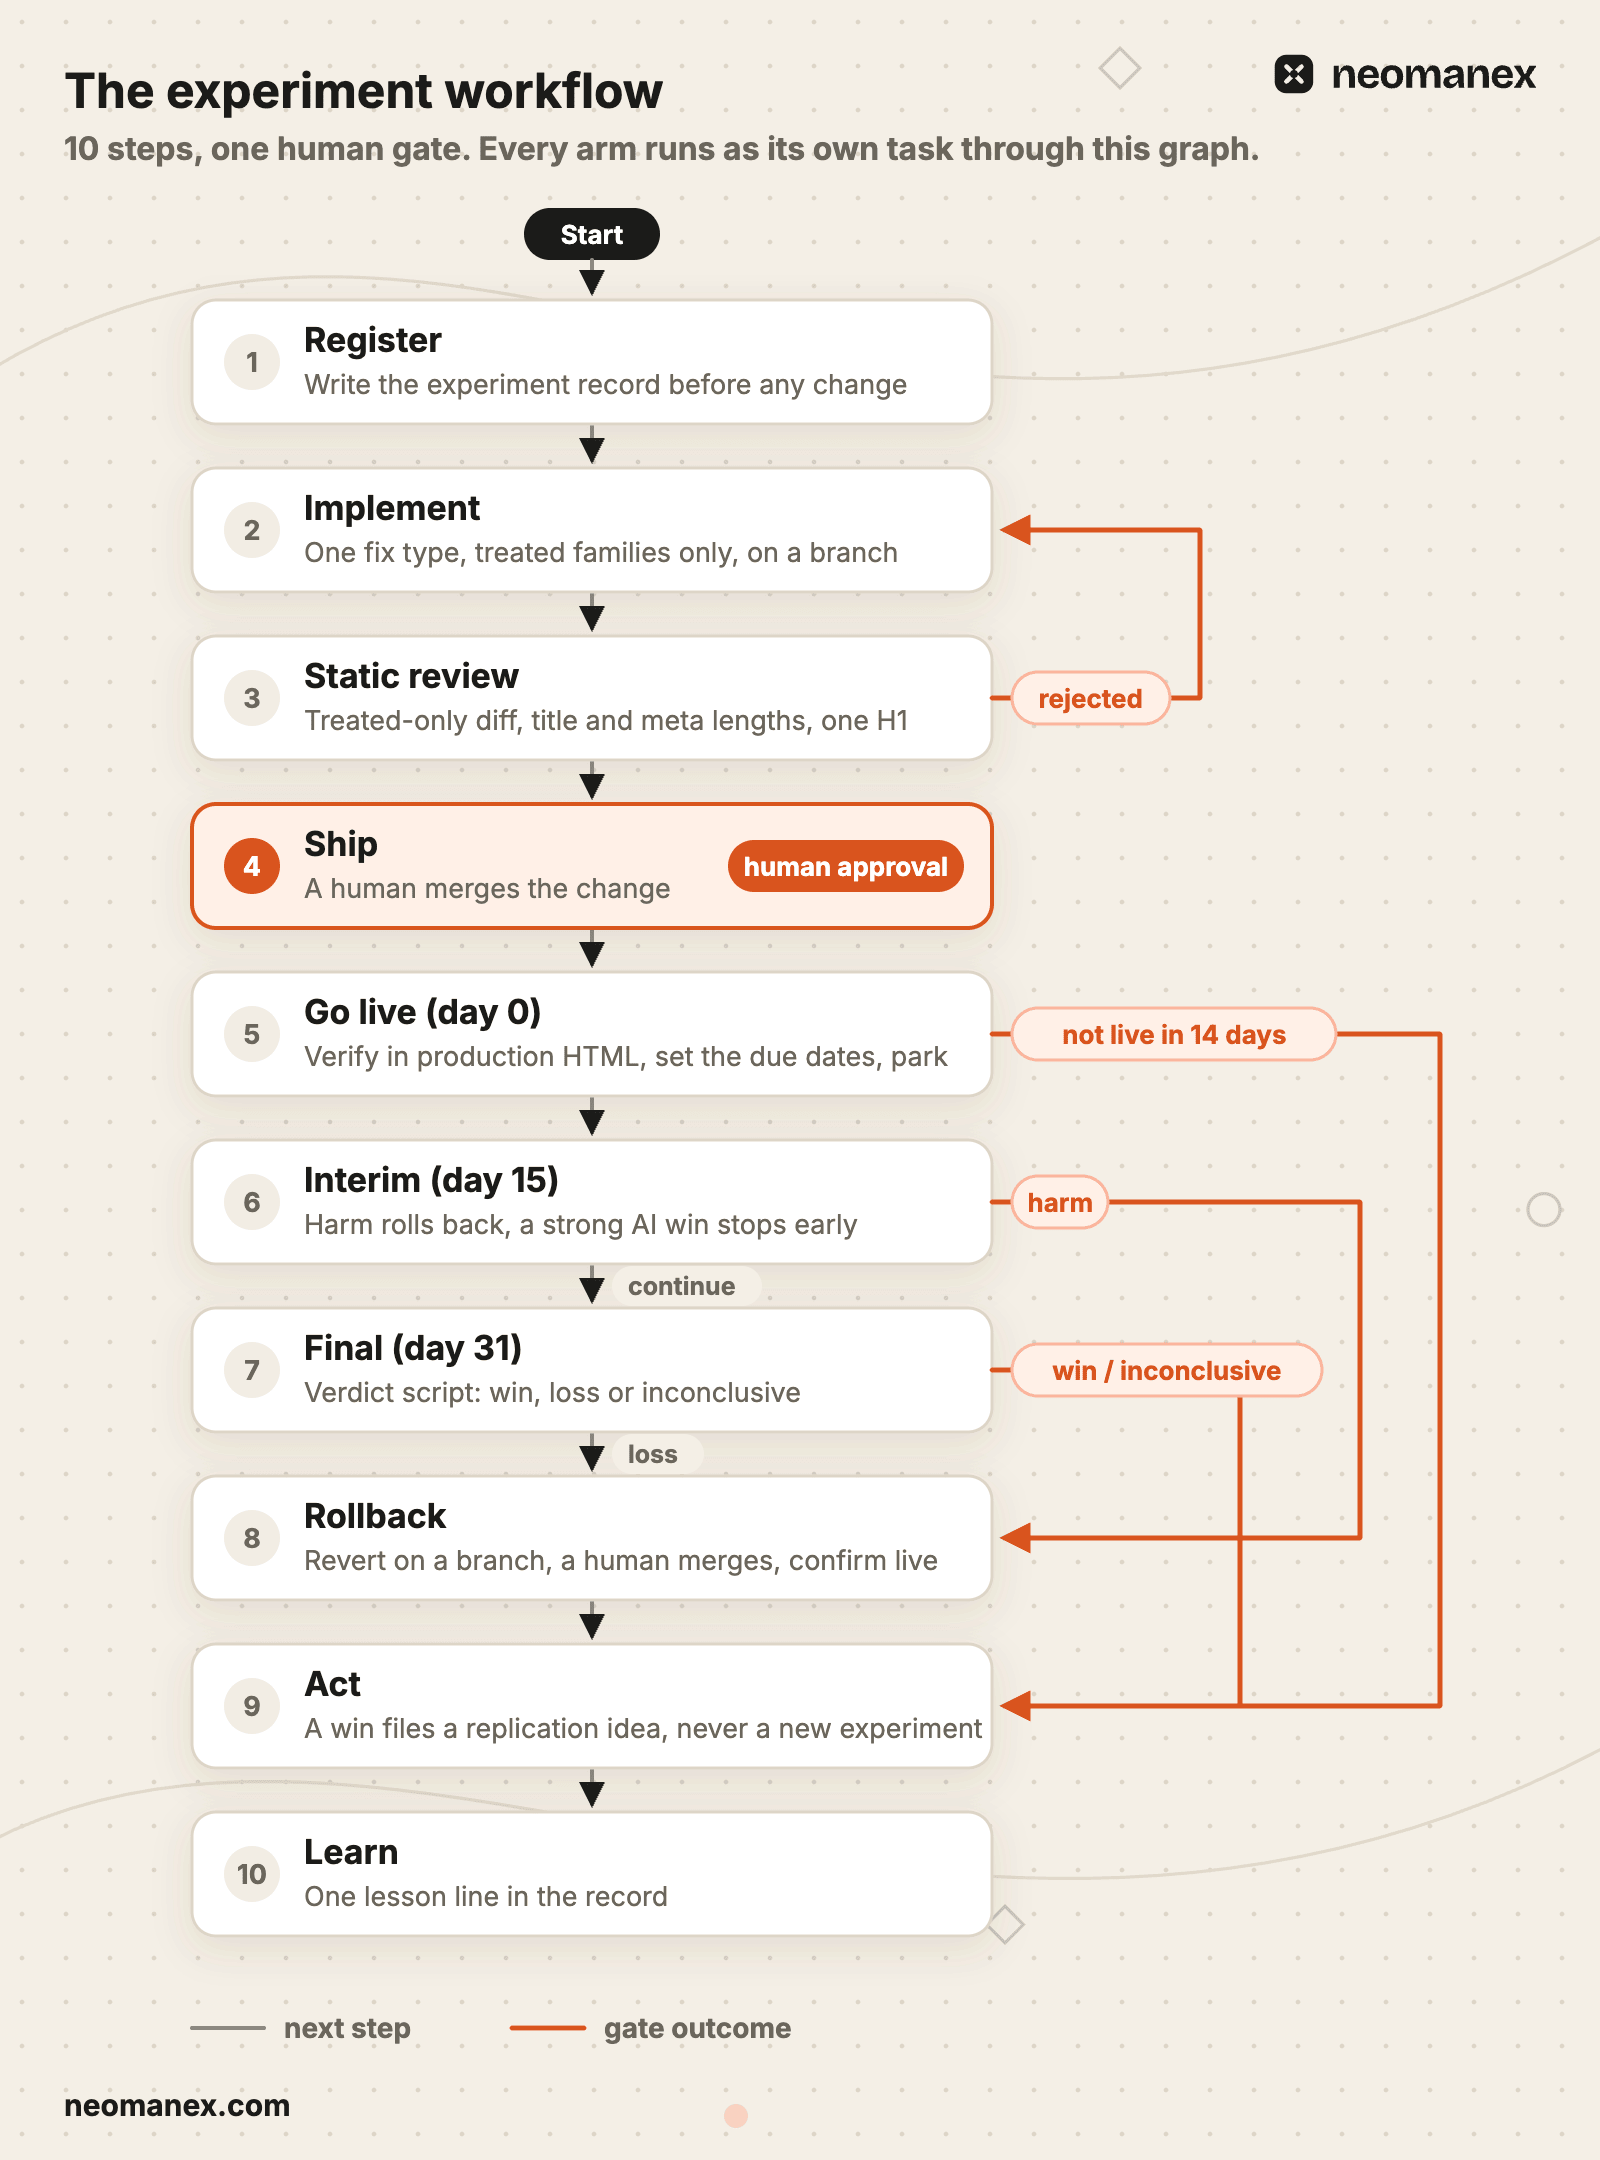
Zwischen den Auswertungen ruht der Task bis zu seinem Fälligkeitsdatum, und der tägliche Puls weckt ihn.
Unser Loop für die selbstheilende Website nutzt dasselbe Muster für die Website-QA: Ein wöchentlicher Prüflauf legt Bugs an, und jeder Bug bekommt einen eigenen Reparaturlauf, der erst nach einer erneuten Prüfung schließt.
Ein Lauf Schritt für Schritt (Beispieldaten)
Hier ist ein vollständiger Tidewell-Lauf, vom Montagsplaner bis zum Urteil an Tag 31.
Montag: Der Planer öffnet eine Welle
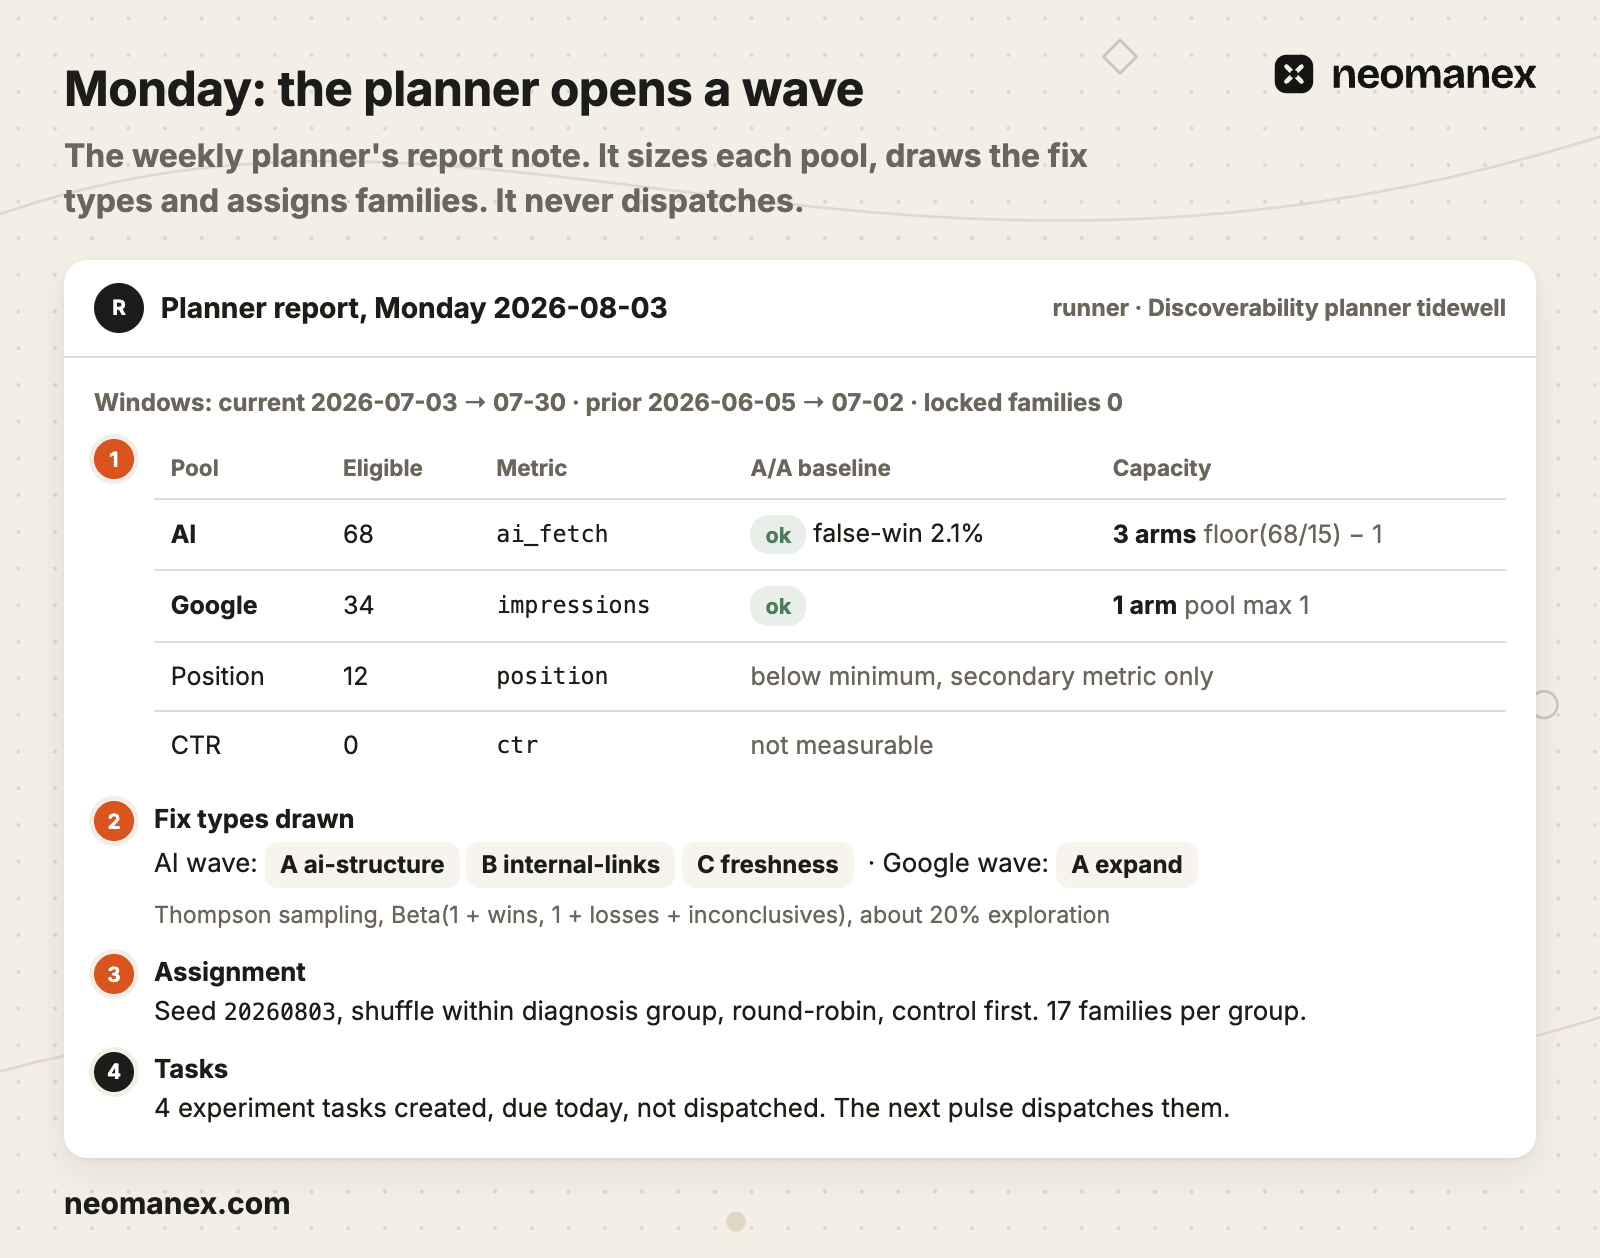
Der Planer zählt geeignete Familien und die Arm-Kapazität pro Pool (Markierung 1). Die Kapazität ist die Zahl der geeigneten Familien geteilt durch 15, abgerundet, minus eins: Tidewells 68 Familien im KI-Pool erlauben 3 Arme. Der Google-Pool ist auf 1 Arm begrenzt, und jeder Pool hat immer nur eine laufende Welle.
Ein Pool bekommt nur dann eine Welle, wenn seine historische A/A-Baseline in Ordnung ist. Diese Baseline spielt vergangene Daten mit Schein-Aufteilungen erneut ab und zählt, wie oft reines Rauschen wie ein Gewinn aussieht (2,1 % im Beispiel). Ein Pool, der das nicht besteht, bekommt keine Welle, weil jedes Urteil dort Rauschen wäre.
Korrekturtypen, die öfter gewonnen haben, werden häufiger gezogen (Markierung 2), wobei etwa 20 % der Arme für Korrekturtypen ohne Urteil reserviert bleiben (Thompson Sampling, Beta(1 + wins, 1 + losses + inconclusives)).
Die Zuweisung nutzt das Datum als Zufalls-Seed, mischt innerhalb jeder Diagnosegruppe und verteilt die Familien reihum, die Kontrollgruppe zuerst (Markierung 3). Jede Gruppe erhält 17 Familien. Der nächste Puls, nicht der Planer, verteilt die vier Tasks.
Register: Das Protokoll kommt zuerst
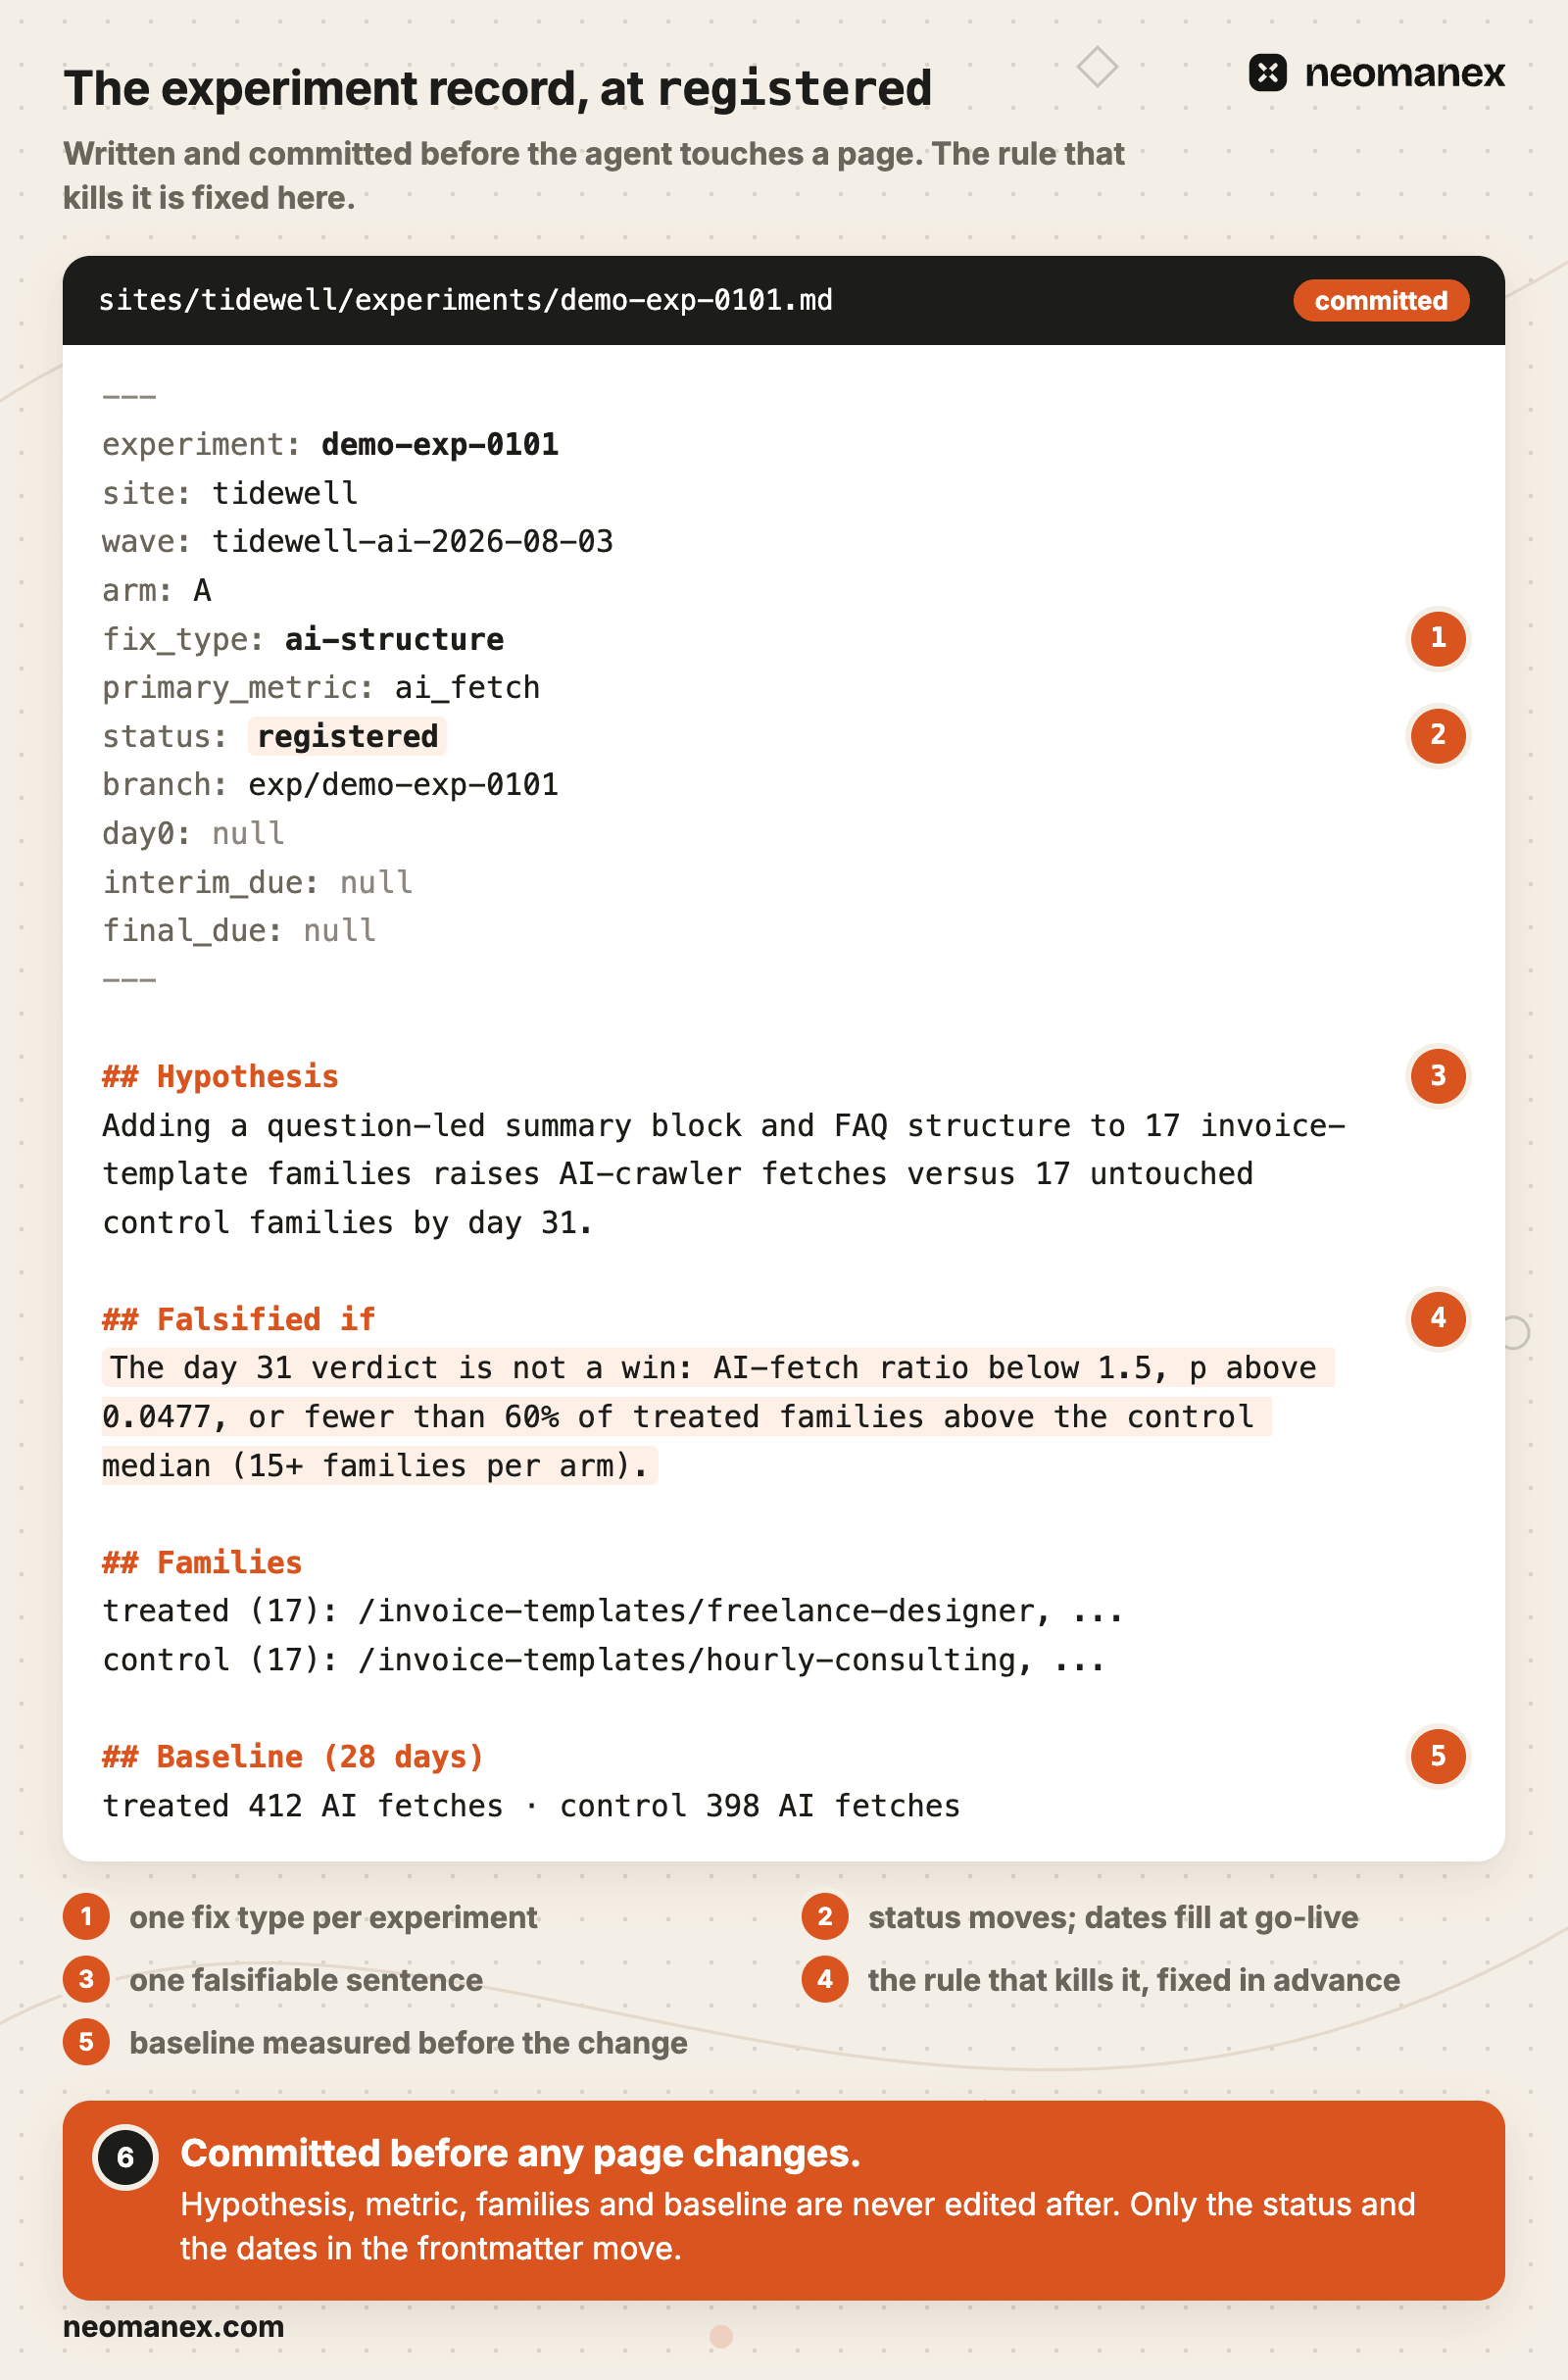
Das Protokoll enthält einen Korrekturtyp (Markierung 1), einen falsifizierbaren Satz (3), die Regel, die ihn widerlegt (4), und eine Baseline über 28 Tage (5). Nach dem Commit ändern sich nur noch der Status und die Datumsangaben. Wir registrieren vorab, weil ein Agent, genau wie ein Mensch, im Nachhinein in jeder Zahl eine Geschichte finden kann; ein committetes Falsifikationskriterium lässt nichts zum Umdeuten übrig.
Implement, Review, Ship, Go live
In Arm A ergänzt Claude Code die 17 Testfamilien mit Rechnungsvorlagen um eine Zusammenfassung in Frageform und einen FAQ-Block. Das ist die eine Variable. Es fasst nie URLs, Slugs, Weiterleitungen, das gemeinsame Layout oder Fakten an, und es aktualisiert das Datum auf jeder geänderten Seite. Das statische Review besteht; ein Mensch mergt. Hier ist Arm B derselben Welle, ruhend nach dem Go-live.
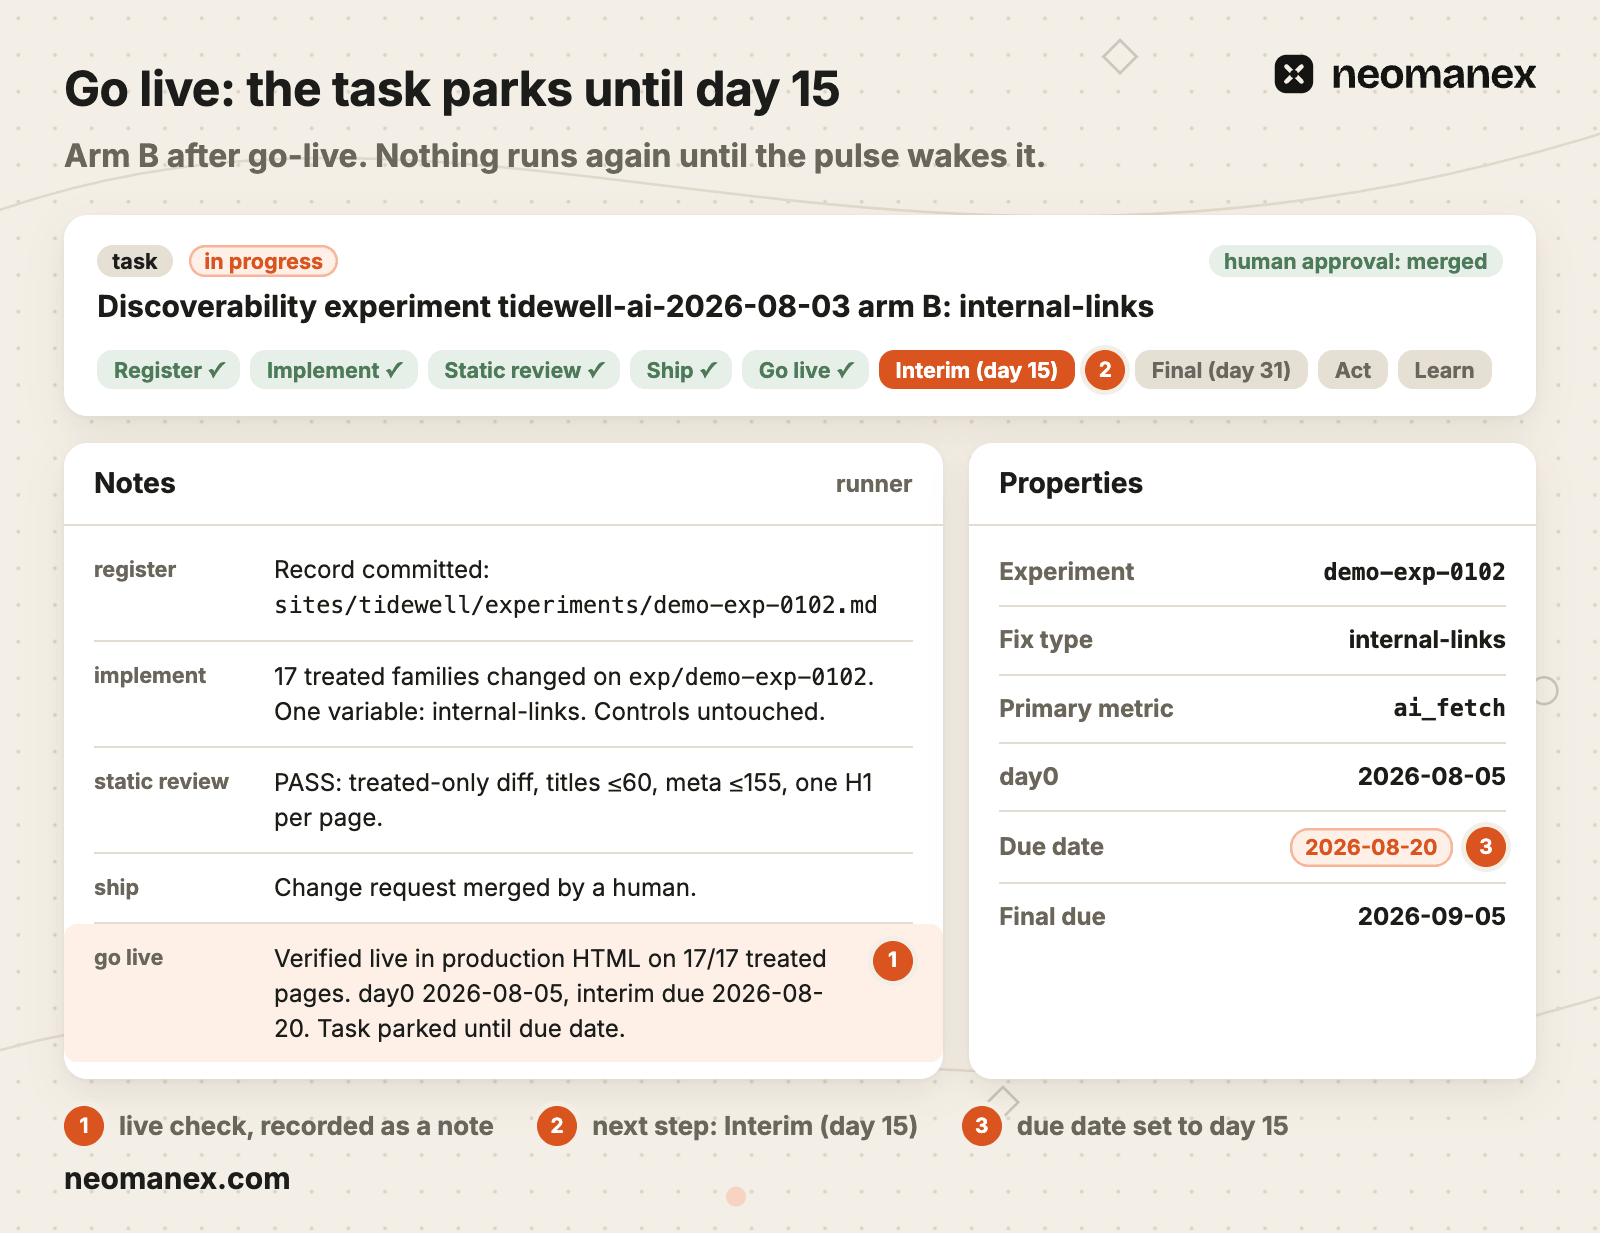
Go live prüft die Änderung im Produktions-HTML auf allen 17 Seiten (Markierung 1). Laut Google kann das Crawling einige Tage bis einige Wochen dauern (Google Search Central, 2025(wird in einem neuen Tab geöffnet)), deshalb ist Tag 0 der Tag, an dem die Änderung live verifiziert ist, nicht der Tag des Merges. Go live setzt Tag 0 und beide Fälligkeitsdaten und lässt den Task dann bis Tag 15 ruhen (Markierungen 2 und 3).
Tag 15 und Tag 31: Ein Skript entscheidet
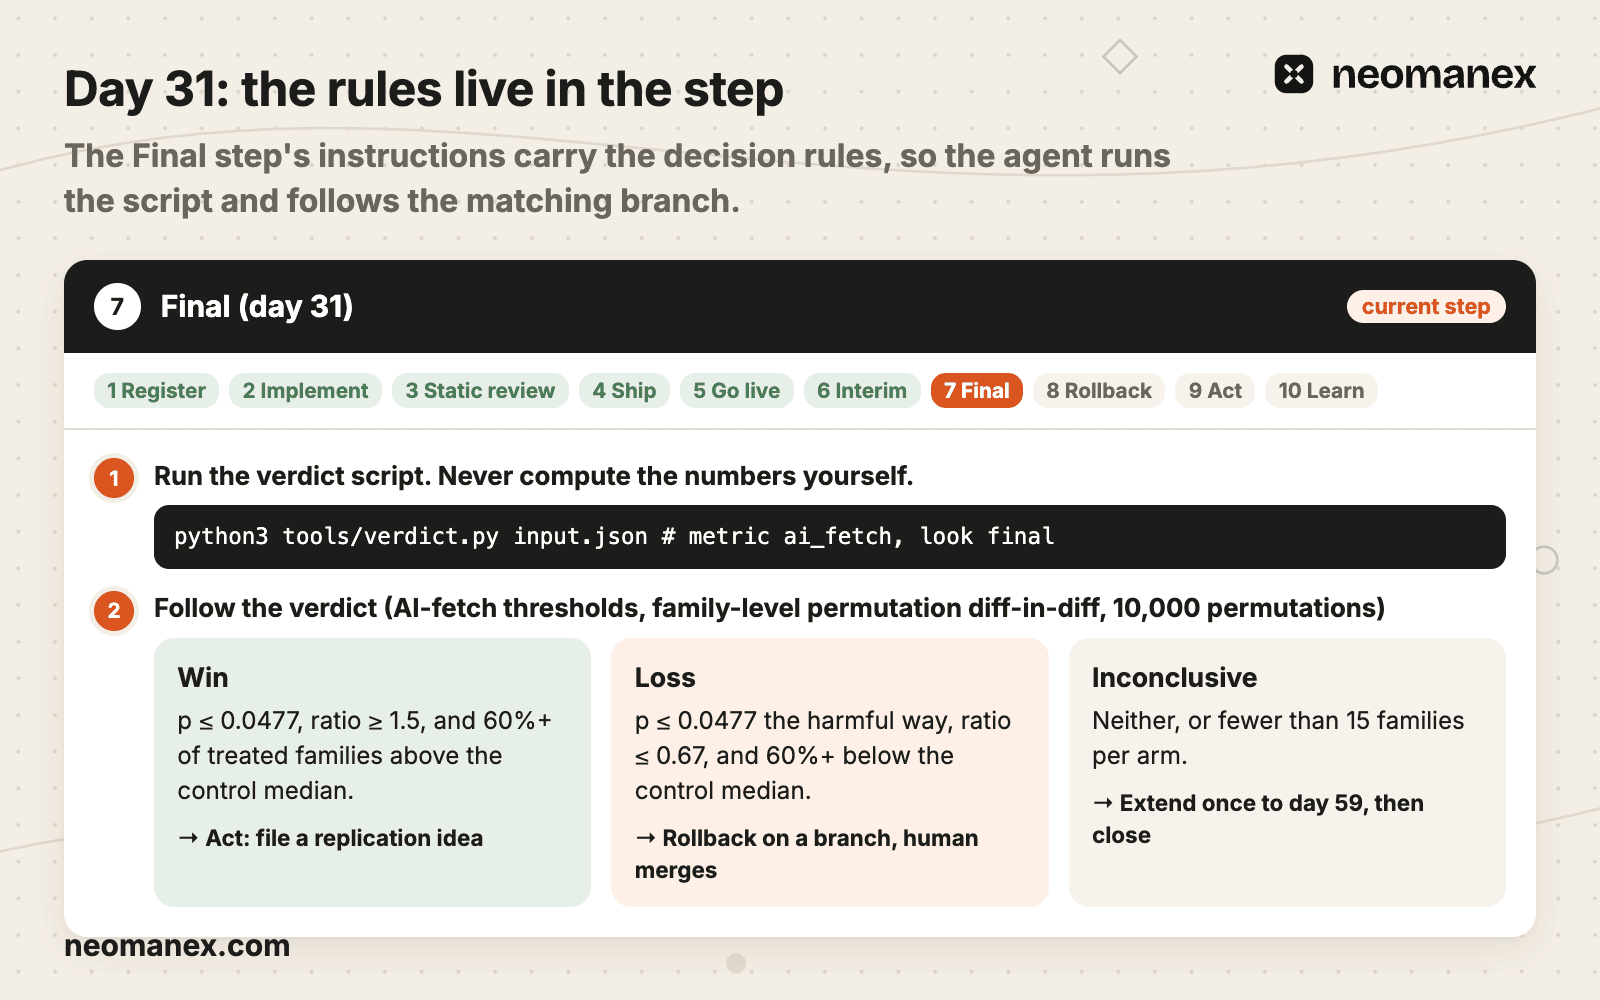
Die Entscheidungsregeln stehen in den Anweisungen des Schritts (Markierung 2), sodass der Agent nicht mit ihnen diskutieren kann. Er führt das Urteilsskript aus und folgt dem passenden Zweig.
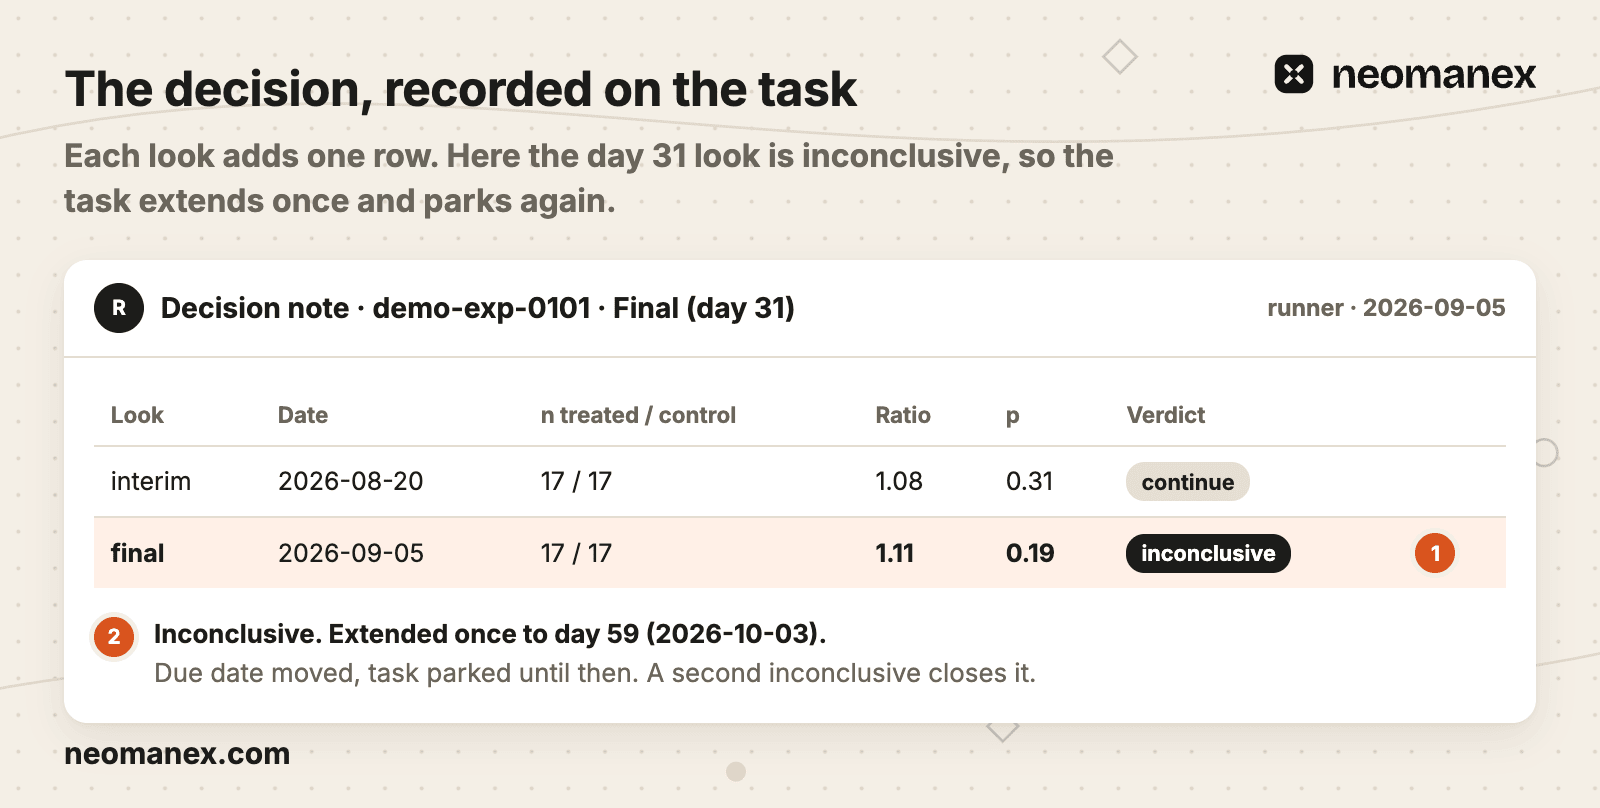
An Tag 15 liest das Skript Ratio 1,08, p 0,31: kein Schaden, kein vorzeitiger Gewinn, weiter. An Tag 31 liest es Ratio 1,11, p 0,19 (Markierung 1): nicht eindeutig, also wird der Task einmal bis Tag 59 verlängert und ruht erneut.
So sieht das Ergebnis aus: das Ledger
Das Ergebnis dieses Loops ist das Ledger, nicht ein Traffic-Diagramm.
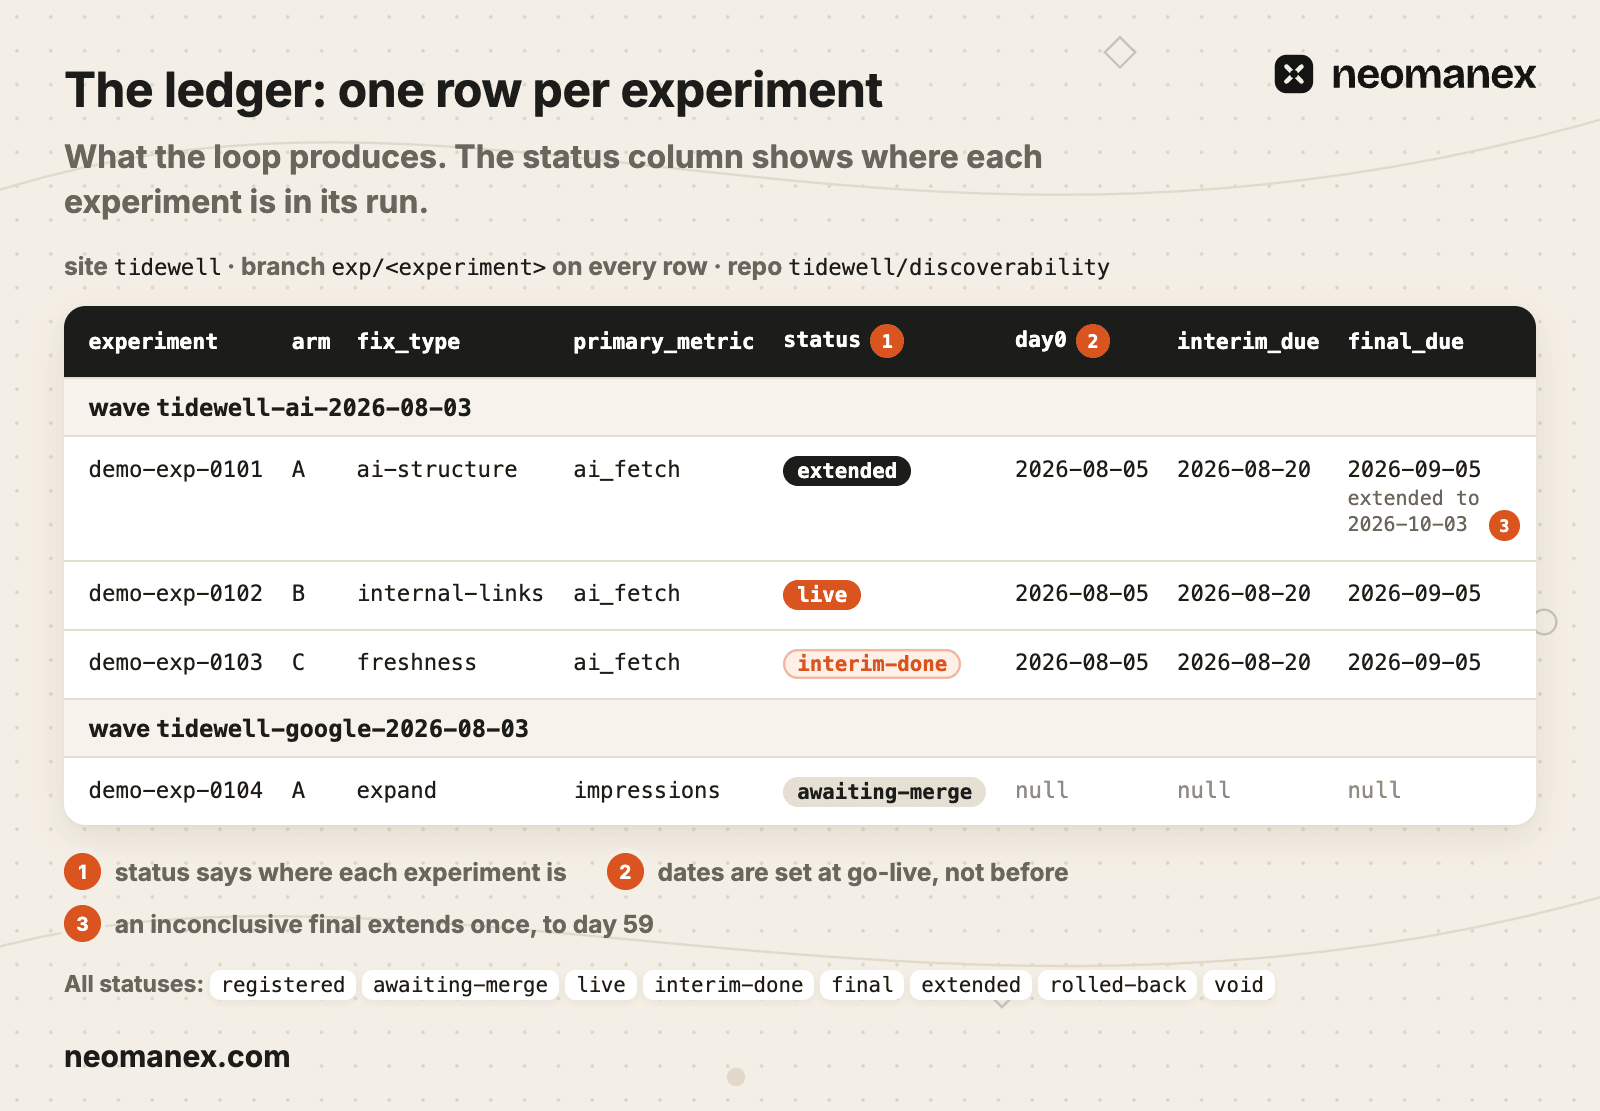
Ein Experiment durchläuft die Status registered (registriert), awaiting-merge (wartet auf Merge), live, interim-done (Zwischenauswertung erledigt) und final und kann als extended (verlängert), rolled-back (zurückgenommen) oder void (ungültig) enden. Jeder Arm ist ein eigener Task mit eigenem Urteil.
Das Urteilsskript führt eine Differenz-von-Differenzen-Analyse (Diff-in-Diff) mit Permutationstest auf Familienebene über 10.000 Durchmischungen aus. Die Ratio ist die Veränderung der Testgruppe geteilt durch die Veränderung der Kontrollgruppe im selben Zeitraum; 1,5 bedeutet also, dass sich die Testgruppe um 50 % stärker bewegt hat als die Kontrollgruppe. Bei KI-Abrufen (jede Metrik hat eigene Schwellen) braucht ein Gewinn an Tag 31 p ≤ 0,0477, eine Ratio von 1,5 oder mehr und mindestens 60 % der Testfamilien über dem Median der Kontrollgruppe. Ein KI-Abruf-Ergebnis an Tag 15 mit p ≤ 0,0074, das auch die Ratio- und Anteilsregeln erfüllt, beendet den Arm vorzeitig: Es ist final und geht direkt zu Act. Ein Verlust ist das Spiegelbild (Ratio 0,67 oder weniger, 60 % unter dem Median), und es folgt ein Rollback. Alles andere, oder weniger als 15 Familien pro Arm, ist nicht eindeutig.
Die beiden p-Schwellen teilen ein Budget von 5 % für falsche Gewinne auf die zwei Auswertungen auf, sodass ein vorzeitiger Stopp an Tag 15 keine zusätzlichen falschen Gewinne kostet. Die Ratio und der Anteil von 60 % stoppen ein Ergebnis, das statistisch echt, aber winzig ist oder von einer einzigen großen Seite getragen wird.
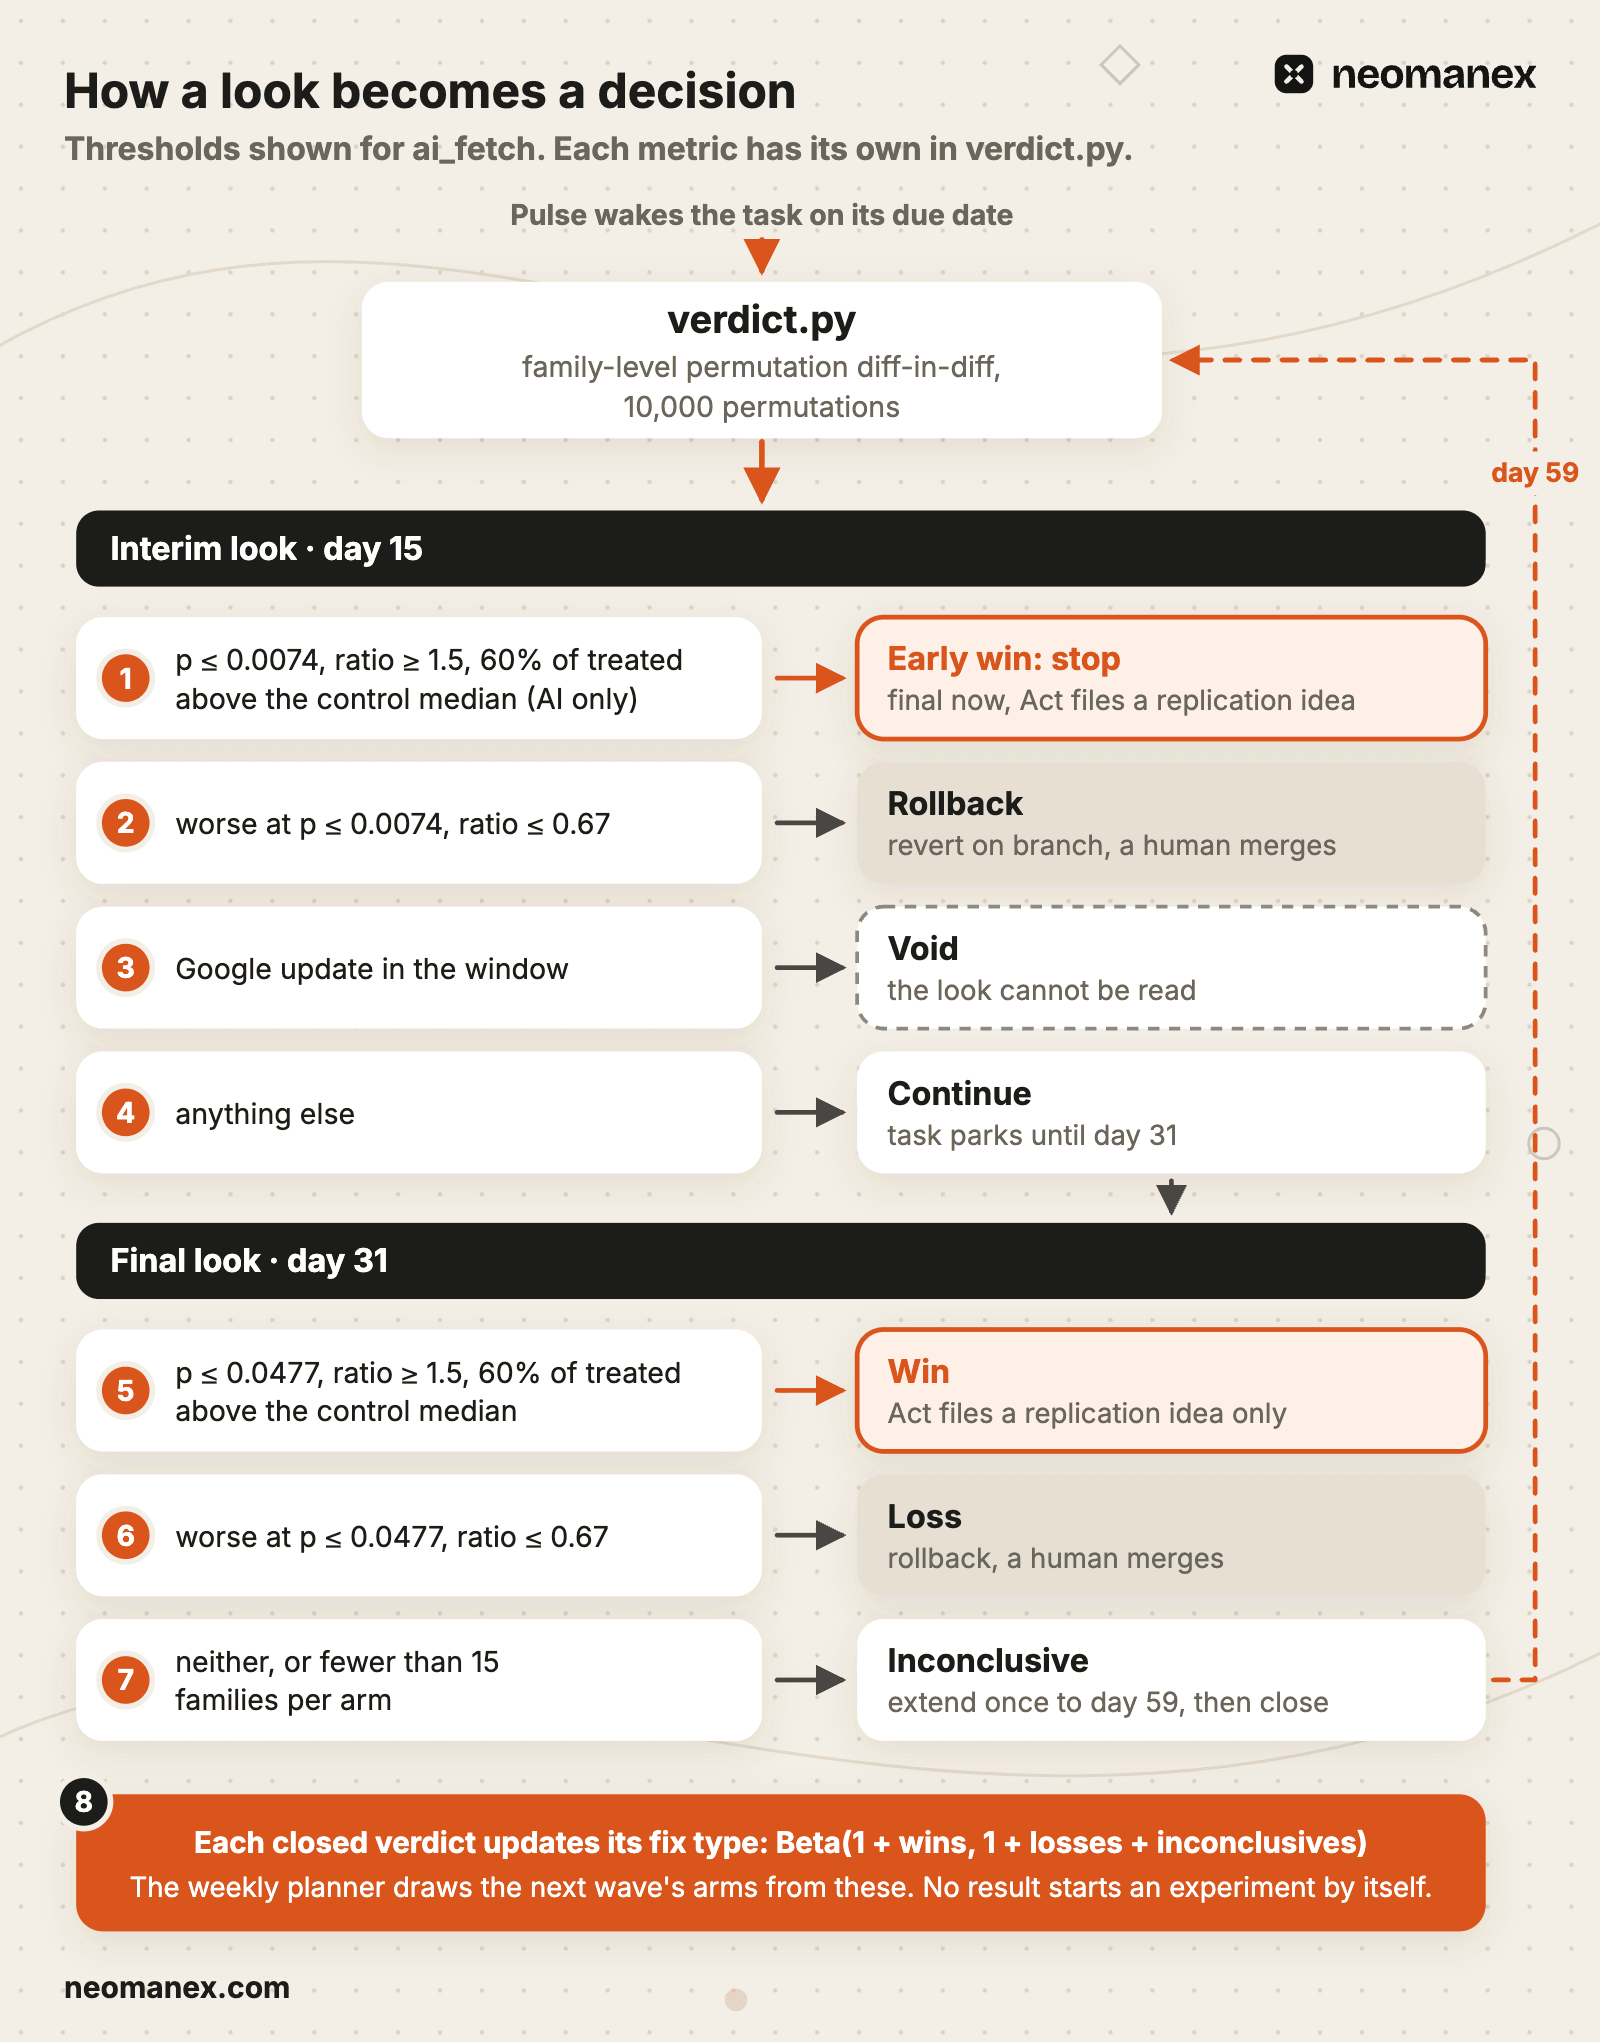
Nicht eindeutig ist kein Verlust. Es bedeutet, dass der Effekt, falls es einen gibt, kleiner ist, als diese Website erkennen kann. Der Task wird einmal bis Tag 59 verlängert und dann geschlossen, denn ein Test, der so lange läuft, bis er gewinnt, gewinnt irgendwann durch Rauschen. Auch ein Gewinn erzeugt keine weiteren Experimente. Er legt eine Replikationsidee für einen Menschen an, denn ein Budget von 5 % für falsche Gewinne bedeutet, dass manche Gewinne Rauschen sind, und nur ein zweiter Lauf mit frischen Familien trennt sie voneinander.
Was schiefgeht: der Agent, der eine Krise erfand
Unser schlimmster Morgen kam von einem Agenten, der hilfreich sein wollte. Unsere tägliche Prüfung übersprang ihre Prüfliste und schrieb einen eigenen Bericht. Sie berechnete eine Klickrate, verglich sie mit einem „Branchenstandard“, den ihr niemand gegeben hatte, stufte sie als CRITICAL ein, empfahl Änderungen und zitierte Tracking-Bugs, die nie angelegt worden waren. Jede Zahl wirkte plausibel. Keine stammte aus einer definierten Prüfung. Wir archivierten den Bericht und schrieben den Schritt noch am selben Tag neu. Hier ist der Fall, nacherzählt auf Tidewell-Daten.
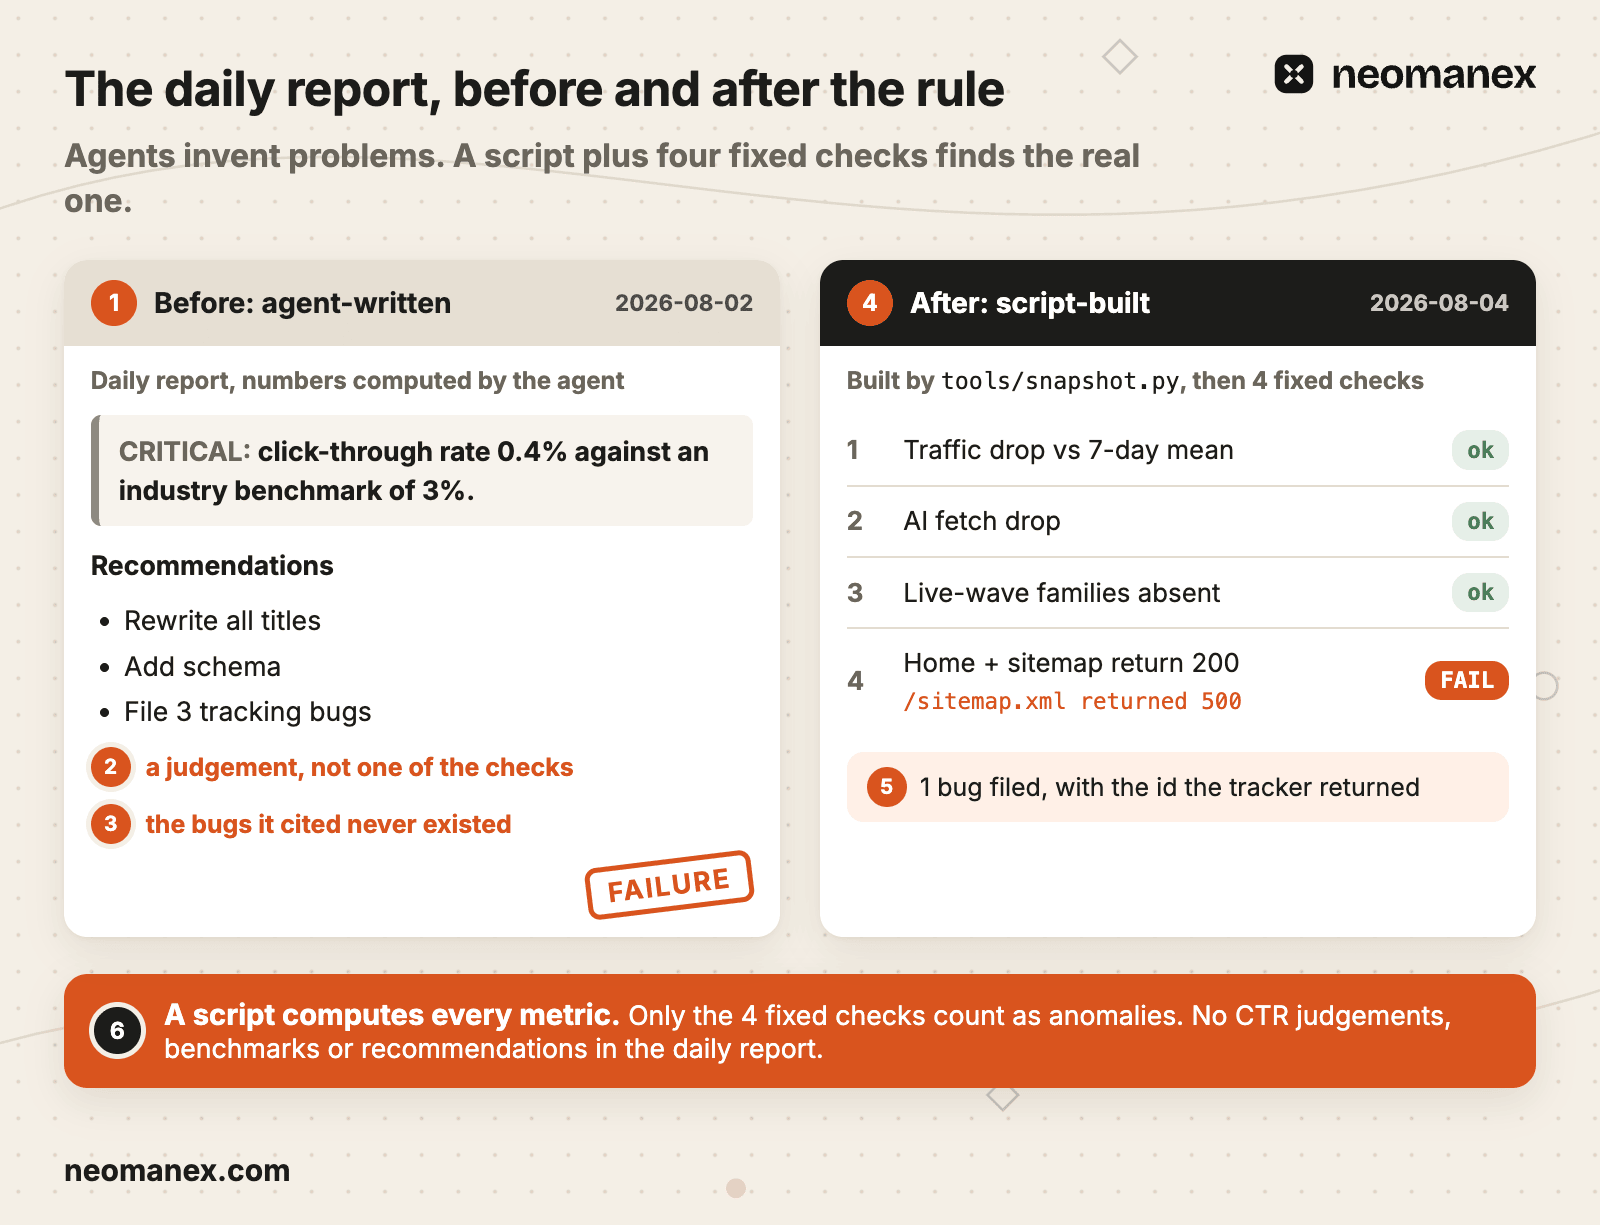
Die Regel, die daraus entstand, hat zwei Teile. Erstens erstellt ein Skript den Snapshot, und der Agent berechnet nie eine Snapshot-Zahl und schreibt die Datei nie von Hand. Zweitens gelten nur vier feste Prüfungen als Anomalien:
- Die Impressionen fallen unter die Hälfte ihres 7-Tage-Mittelwerts.
- Die Abrufe durch KI-Crawler fallen unter 50 % oder steigen über 300 % ihres 7-Tage-Mittelwerts.
- Eine Familie in einer laufenden Welle fehlt 7 Tage lang in den Daten.
- Die Startseite oder die Sitemap liefert einem KI-Crawler nicht HTTP 200.
Keine Urteile über die CTR, keine Rankings, keine Vergleichswerte, keine Empfehlungen. Ein Bug wird nur mit der ID zitiert, die der Tracker zurückgegeben hat.
Der zweite Fehler war leiser und schlimmer. Ein Paket-Release für eine unserer Websites enthielt eine noch nicht veröffentlichte Produktänderung, und die schrieb vor Tag 0 Texte auf einer unserer Kontrollseiten um. Eine Kontrolle, die sich ändert, ist keine Kontrolle mehr: Jeder Abstand, den sie zeigt, ist unsere eigene Änderung, nicht die Korrektur. Wir haben es vor dem Go-live bemerkt. Die Regel: Eine Familie, die nach der Zuweisung angefasst wird, wandert nach „Excluded after assignment“ (nach der Zuweisung ausgeschlossen) und fällt aus dem Vergleich.
Bauen Sie Ihren eigenen: die Minimalversion
Für den Anfang brauchen Sie keine fünf Workflows. Sie brauchen ein Repo, zwei Skripte, eine Protokollvorlage und einen täglichen Scheduler.
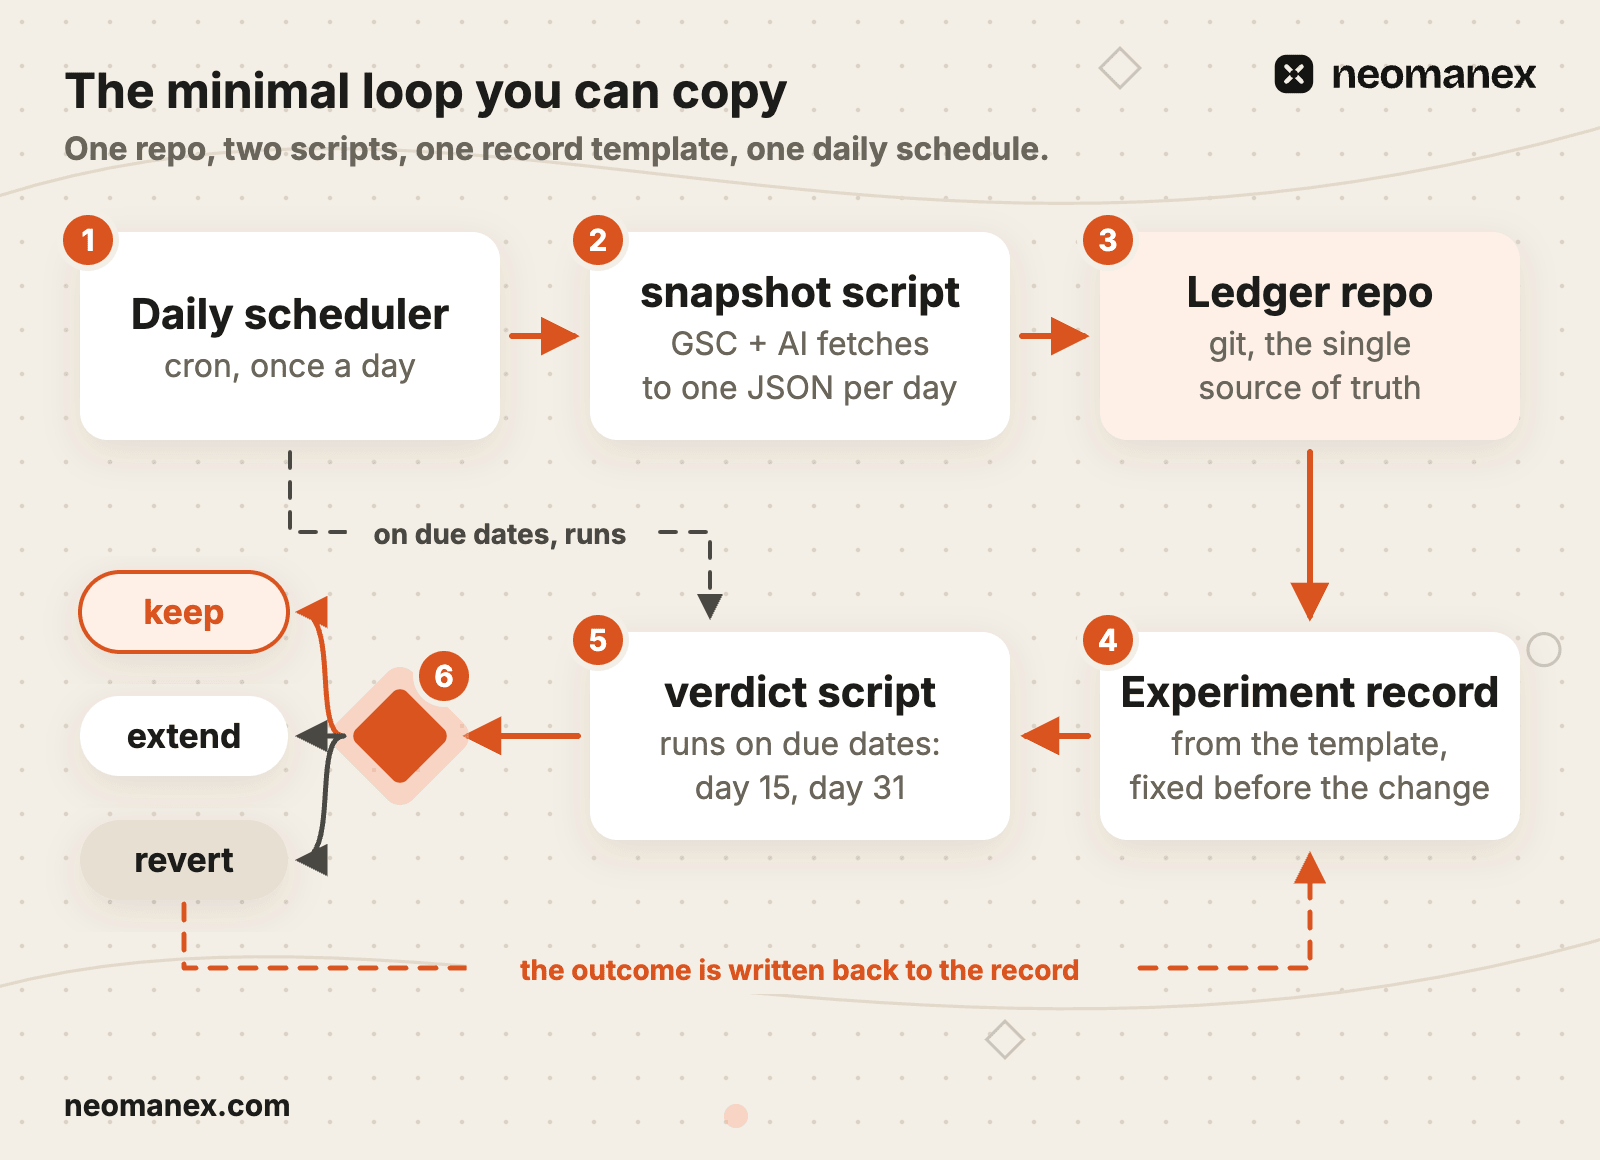
Die Protokollvorlage, eine Datei pro Experiment:
---
experiment: exp-0001
site: example
wave: example-2026-01-05
arm: A
fix_type: internal-links
primary_metric: impressions
status: registered
branch: exp/exp-0001
day0: null
interim_due: null
final_due: null
---
Hypothesis:
One falsifiable sentence: what changes, on which treated families, against which control, by day 31.

Falsified if:
The day 31 verdict is not a win under the thresholds fixed in the verdict script.

Families:
treated (15+): ...
control (15+): ...

Baseline (28 days):
treated ... | control ...

Verdicts:
| Look | Date | n treated / control | Ratio | p | Verdict |
|---|---|---|---|---|---|

Lesson:
Kopieren Sie die Protokollvorlage und planen Sie dann den täglichen Puls in ConvOps(wird in einem neuen Tab geöffnet), damit jedes Experiment an seinem Fälligkeitsdatum geweckt wird.
Schritte
Das Ledger-Repo anlegen
Legen Sie ein Git-Repo mit Methodik, Tools und einem Ordner pro Website für Snapshots, Wellen, Experimente und Berichte an. Jeder Agent-Lauf committet seine Ausgabe dorthin.
Das Snapshot-Skript schreiben
Holen Sie die Seitendaten aus der Search Console für den Tag vor drei Tagen, weil die jüngsten Tage noch nicht final sind, und schreiben Sie pro Tag eine JSON-Datei. Claude Code ruft das Skript auf und berechnet die Zahlen nie selbst.
Prüfen, was Sie messen können
Zählen Sie die Seitenfamilien, für die Ihre Metrik vorliegt. Unter 15 Familien pro Gruppe kann diese Metrik auf Ihrer Website kein Experiment tragen, also wählen Sie eine andere oder warten Sie.
Mit einer Durchmischung per Seed zuweisen
Verwenden Sie das Datum als Zufalls-Seed, mischen Sie innerhalb von Gruppen ähnlicher Seiten und verteilen Sie die Familien reihum, die Kontrollgruppe zuerst, bis jede Gruppe 15 oder mehr hat.
Vor der Änderung registrieren
Kopieren Sie die Protokollvorlage, schreiben Sie eine falsifizierbare Hypothese und die Regel, die sie widerlegt, und committen Sie, bevor sich irgendeine Seite ändert.
Testseiten ändern und von Hand mergen
Lassen Sie Claude Code auf einem Branch eine einzige Variable nur in den Testfamilien ändern. Ein Mensch mergt, und Tag 0 ist der Tag, an dem die Änderung im Produktions-HTML sichtbar ist.
Das Urteilsskript schreiben
Führen Sie eine Diff-in-Diff-Analyse mit Permutationstest auf Familienebene aus, mit festen Schwellen im Code: Gewinn, Verlust oder nicht eindeutig. Der Agent liest das Urteil und folgt dem passenden Schritt.
Den täglichen Puls planen
Lassen Sie jeden Morgen einen Job laufen, der den Snapshot erstellt, einige feste Prüfungen ausführt und jedes heute fällige Experiment weckt, an Tag 15 und Tag 31.
Häufige Fragen
Was ist ein vorregistriertes SEO-Experiment?
Ein vorregistriertes SEO-Experiment ist eine Seitenänderung, deren Hypothese, primäre Metrik, Test- und Kontrollgruppen, Baseline und Falsifikationskriterium committet werden, bevor die Änderung live geht. In diesem Loop führt ConvOps zuerst den Schritt Register aus: Claude Code kopiert die Protokollvorlage, schreibt eine falsifizierbare Hypothese und committet sie ins Ledger-Repo. Danach ändern sich nur noch Status und Datumsangaben, sodass das Urteil an Tag 31 an dem gemessen wird, was versprochen war.
Für wen eignet sich ein Loop für SEO-Experimente?
Ein Loop für SEO-Experimente eignet sich für Gründer und kleine Marketing-Teams, die eine Content- oder Produkt-Website mit wenig Traffic betreiben und SEO-Änderungen nach Bauchgefühl vornehmen. ConvOps führt den Loop als geplante Tasks aus, sodass jede Korrektur auf Basis eines kontrollierten Vergleichs behalten, verlängert oder zurückgenommen wird statt auf Basis eines Vorher-nachher-Diagramms. Die Website braucht mindestens 15 Seitenfamilien pro Gruppe im getesteten Pool, deshalb kann eine sehr kleine Website nur wenige Korrekturtypen testen.
Kann Claude Code als Agent SEO-Experimente durchführen?
Ja. Claude Code ist die Agent-Laufzeit, und ConvOps ist die Betriebsebene für KI-Agenten, die jeden Lauf plant und mit Gates absichert. Claude Code registriert das Experiment, ändert auf einem Branch nur die Testseiten, prüft den Diff und kontrolliert, ob die Änderung live ist. Es mergt die Änderung nie selbst: Das tut ein Mensch. Es berechnet auch nie Metriken oder Urteile. Das erledigen Skripte, und Claude Code liest das Ergebnis.
Wie viel Traffic brauchen SEO-Experimente?
Genug für mindestens 15 Seitenfamilien pro Gruppe, wobei die Metrik für jede davon vorliegen muss. ConvOps führt einen wöchentlichen Planer aus, der die geeigneten Familien pro Pool zählt und eine Welle nur dann öffnet, wenn eine historische A/A-Baseline zeigt, dass der Pool ruhig genug ist. Auf einer kleinen Website zeigen sich nur große Effekte: Bei der Metrik KI-Abrufe braucht ein Gewinn eine Ratio von 1,5 oder mehr, und jede Metrik hat eigene Schwellen im Urteilsskript. Die Klickrate ist in dieser Größenordnung oft gar nicht messbar.
Wie lange dauert es, bis ein SEO-Experiment ein Urteil liefert?
Das finale Urteil kommt 31 Tage, nachdem die Änderung live verifiziert wurde. ConvOps lässt den Experiment-Task bis zu seinem Fälligkeitsdatum ruhen, und der tägliche Puls weckt ihn an Tag 15 für eine Zwischenauswertung. Diese führt bei Schaden zum Rollback, wird bei einem Google-Update ungültig oder läuft bis Tag 31 weiter, und ein starker Gewinn bei KI-Abrufen mit p von 0,0074 oder weniger beendet das Experiment vorzeitig. Ein nicht eindeutiges finales Urteil wird einmal bis Tag 59 verlängert und dann geschlossen.
Was passiert, wenn ein SEO-Experiment verliert?
Ein Verlust bedeutet, dass die Testseiten schlechter abgeschnitten haben als die Kontrollgruppe. Bei der Metrik KI-Abrufe heißt das p von 0,0477 oder weniger in der schädlichen Richtung, eine Ratio von 0,67 oder weniger und mindestens 60 % der Testfamilien unter dem Median der Kontrollgruppe. Jede Metrik hat eigene Schwellen im Urteilsskript. ConvOps verschiebt den Task in seinen Rollback-Schritt, wo Claude Code den Revert auf einem Branch vorbereitet und ein Mensch ihn mergt. Der nächste geweckte Lauf bestätigt, dass der Revert live ist, und der Verlust zählt gegen diesen Korrekturtyp, wenn der Planer die nächste Welle zieht.