O que vai conseguir fazer
- Escrever critérios de aceitação observáveis e congelá-los antes de a construção começar.
- Transformar cada critério num percurso com pré-condições e passos observáveis.
- Preparar e provar o ambiente de teste num passo separado, antes de o testador entrar em ação.
- Executar os percursos com o Playwright MCP e ler o relatório pelos vereditos.
- Montar um ciclo de correção e nova execução em que ninguém certifica a sua própria correção.
Pontos-chave
- Nos testes de aceitação conduzidos por agentes, um agente de IA conduz cada percurso do utilizador contra a aplicação em execução e emite um veredito por cada critério de aceitação congelado.
- Congele os critérios antes de existir código e dê a cada um exatamente um percurso que o cite palavra por palavra.
- O agente que testa nunca corrige: uma falha volta à construção e só uma nova execução completa conta como prova.
- BLOCKED é um veredito, não uma lacuna a esconder; leia-o antes de FAIL.
- Esta camada não substitui o CI; apanha os defeitos que vivem entre camadas que passaram cada uma por si.
O que fazem aqui os testes de aceitação com Playwright MCP
Testes de aceitação conduzidos por agentes são um ciclo de verificação em que um agente de IA conduz cada percurso do utilizador num browser real e indica se passa ou falha face a critérios de aceitação congelados. Os percursos de API e MCP correm da mesma forma, como chamadas reais à aplicação em execução.
Um teste que quem constrói escreve para si próprio não prova nada. Queremos o veredito de um agente que apenas lê os critérios e conduz o produto. Depois de o Claude Code construir uma funcionalidade, um segundo agente percorre cada percurso com o Playwright MCP e tira uma captura de ecrã de cada observação decisiva. O ConvOps executa os passos, os pontos de controlo e o ciclo de correção. É um dos ciclos com que gerimos a nossa empresa.
Todos os exemplos usam a Quillbay, uma aplicação fictícia de reserva de aulas para estúdios de cerâmica, e a sua nova lista de espera para aulas lotadas.
| Não é | Porque |
|---|---|
| Testes de aceitação do utilizador | Aí são os utilizadores de negócio que dão o aval; aqui um agente verifica critérios aprovados |
| Testar um agente de IA | O agente é o testador, não o objeto do teste |
| Critérios convertidos em código de teste | Isso acaba num ficheiro .spec.ts. Isto acaba num veredito por percurso, com provas |
| Parte | O que é |
|---|---|
| Gatilho | Terminam os passos de construção de um plano. Sem agendamento |
| Entradas | Critérios de aceitação congelados, o plano de percursos, a aplicação em execução no ambiente da sua própria branch |
| Saídas | Um relatório com um veredito por percurso, capturas de ecrã e uma recomendação: PROCEED ou FIX REQUIRED |
Porque o construímos: camadas verdes, percursos partidos
Testes unitários verdes dizem que as peças funcionam. Não dizem nada sobre se uma pessoa consegue concluir a tarefa no ecrã.
Antes deste ciclo, todas as camadas inferiores passavam: testes unitários, revisões de fase, a suíte de regressão no pipeline de merge. Depois, a primeira execução dos percursos conduzida por um agente contra a aplicação real chumbou mesmo assim uma grande parte deles. Os defeitos viviam entre camadas: um link gerado por um serviço e lido por outro, um redirecionamento que perdia um parâmetro. Nenhuma camada era dona da junção, por isso nenhuma a apanhou.
Daí saíram duas convicções. Quem constrói não pode ser o juiz, por isso o testador nunca escreve nem corrige código. E só uma execução contra a aplicação real prova um critério.
Se as funcionalidades dos seus agentes passam em todas as verificações e mesmo assim falham no ecrã, veja como o ConvOps conduz um plano desde os critérios congelados até uma build verificada(abre num novo separador).
Como funciona: seis passos e quatro agentes
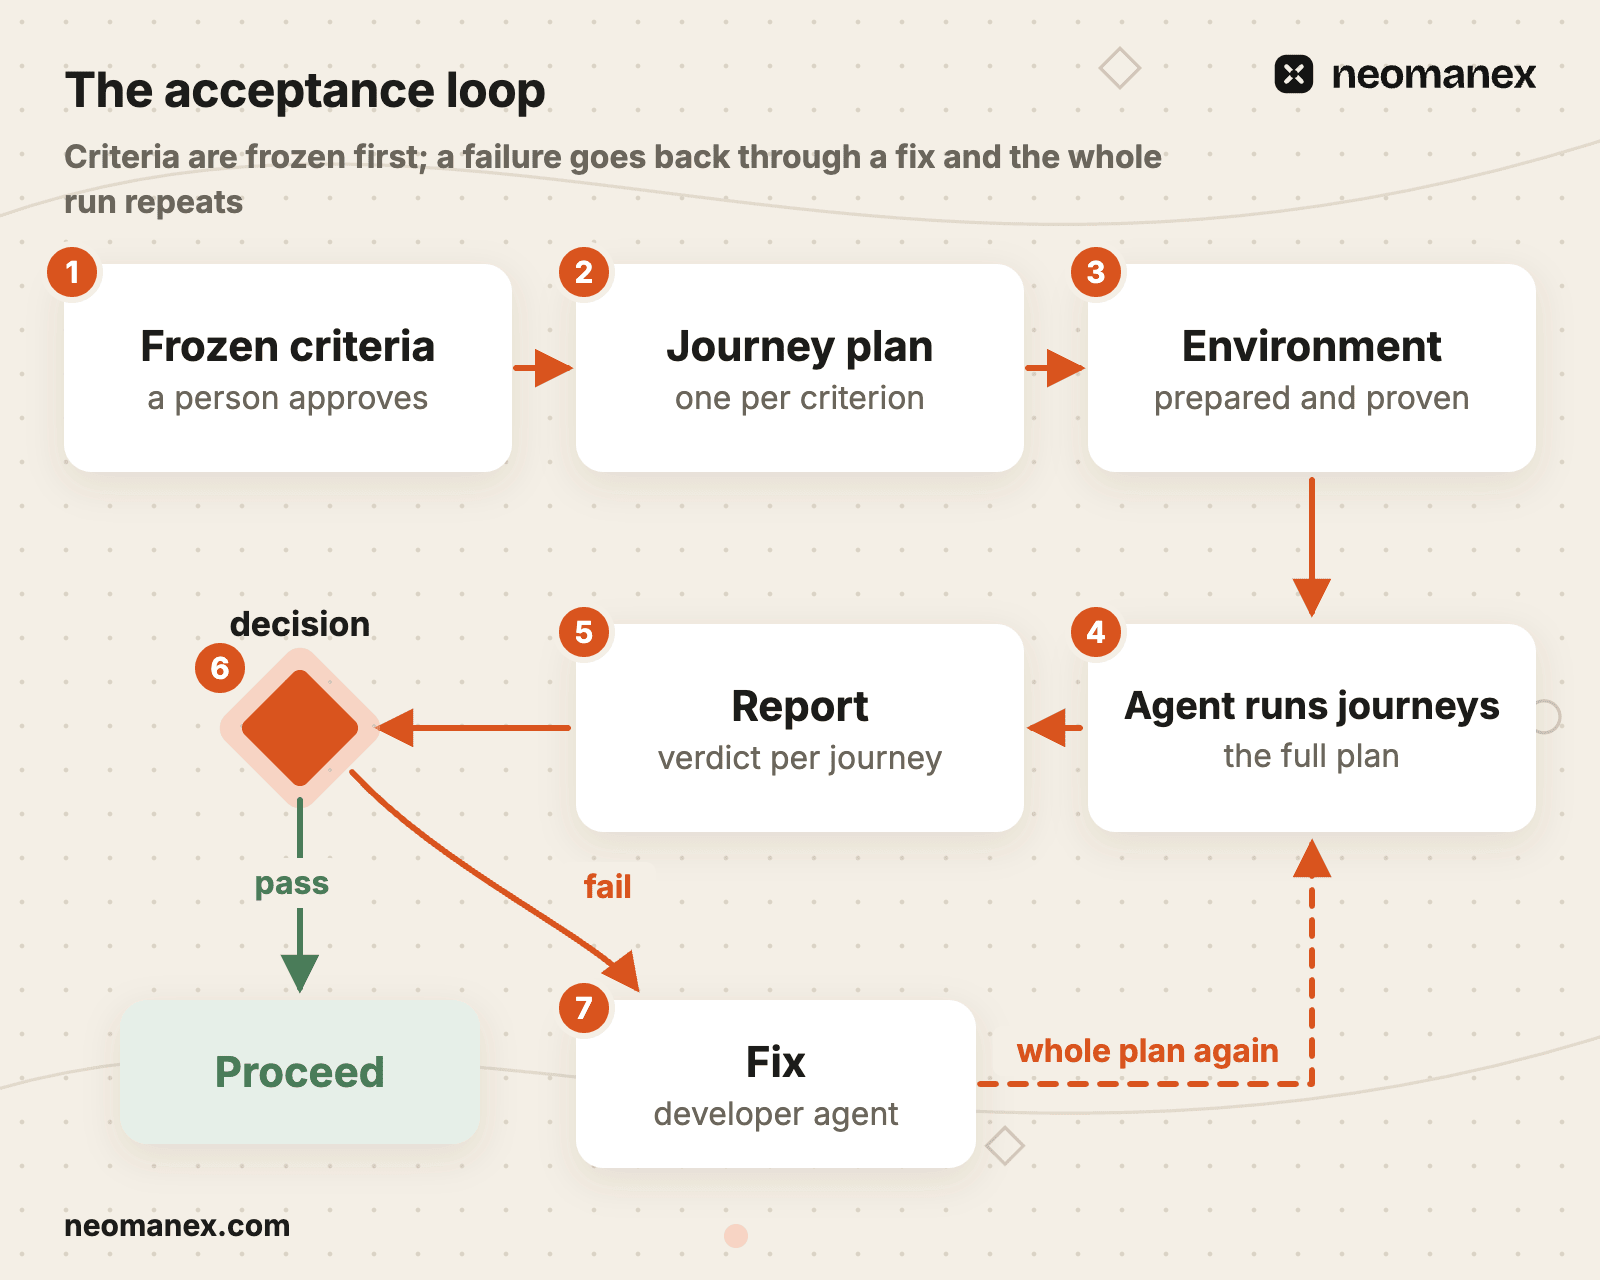
A segurança está na ordem dos passos. Os critérios são congelados antes de existir código, o ambiente é provado antes de o testador chegar e a decisão é tomada por alguém que não escreveu a correção.
| # | Passo | Quem o executa | Ponto de controlo |
|---|---|---|---|
| 1 | Escrever os critérios | Redigidos com o plano, aprovados por uma pessoa | A aprovação congela a lista |
| 2 | Planear os percursos | Planeador de testes | Nenhum |
| 3 | Preparar o ambiente | Agente de infraestrutura | Só com tudo verde, depois uma pessoa aprova |
| 4 | Executar os percursos | Testador de aceitação | Uma pessoa aprova o relatório |
| 5 | Decidir | Passo de decisão | Passa, ou falha e segue para a correção |
| 6 | Corrigir as falhas | Agente de desenvolvimento | Nenhum |
O Claude Code constrói a funcionalidade entre os passos 2 e 3.
Escrever os critérios. Cada um indica um ator, um comportamento e algo que se possa observar: um ecrã, uma mensagem, uma resposta. «O código existe» nunca é um critério, porque o que não se pode observar não pode ser aceite. A aprovação congela a lista: os passos seguintes nunca acrescentam, retiram nem reinterpretam um critério.
Planear os percursos. Um percurso por critério, citado palavra por palavra e com o respetivo id, para que cada critério tenha exatamente um sítio onde é provado.
Preparar o ambiente. Um agente de infraestrutura dedicado levanta o ambiente da branch do próprio plano, provisiona dados e credenciais pelo mecanismo do plano e regista-os. O ponto de controlo exige verde, não esforço. O testador não prepara nada, por isso não pode passar à custa de um caso fácil feito à sua medida.
Executar, decidir, corrigir. O testador de aceitação conduz os percursos e nunca corrige. Uma falha envia o relatório ao agente de desenvolvimento, que faz commit das correções na mesma branch, e o plano inteiro volta a correr.
O ciclo não tem temporizador: corre depois da construção de cada plano e, numa tarefa, sempre que um percurso mudou. Uma execução ao nível da tarefa deriva 3 a 8 percursos: o caminho feliz mais o caminho de erro de maior risco por cada comportamento alterado. Só se pode dispensar a execução quando não há percurso a conduzir (uma refatoração pura, ferramentas, documentação, configuração ou alterações só de testes), com a razão declarada. Na dúvida, execute.
Os Playwright Test Agents(abre num novo separador) da Microsoft (planner, generator, healer) produzem e reparam código de teste. Os nossos produzem um plano a partir de requisitos congelados e um relatório de vereditos. Os pontos de controlo funcionam como em como construímos um sistema de IA que se melhora a si próprio, e as aprovações são pontos de controlo com intervenção humana.

Uma execução, passo a passo: a lista de espera da Quillbay
O momento interessante não é o primeiro FAIL. É a nova execução depois da correção, porque o passo de decisão não aceita outra prova.
Gatilho. Terminam os passos de construção de plan/waitlist. Os critérios FR-1 a FR-4 foram congelados antes de existir qualquer código.
O plano. O percurso U2 cita o FR-2 e transcreve-o: «Quando um lugar fica livre, o primeiro aluno da fila recebe um email cujo link abre a aula com o lugar reservado durante 2 horas.» Cada pré-condição diz como confirmá-la: a aula acc-wl-r7-class-wheel-basics está lotada com 8 de 8 (a página mostra «Full», ou seja, lotada, e o botão Join waitlist, para entrar na lista de espera), os dois alunos conseguem iniciar sessão e o correio enviado chega à caixa de captura.

Preparar. O agente de infraestrutura prova que wl-waitlist.app.quillbay.example.com e a respetiva API estão verdes, e regista as fixtures dos alunos e a chave do dono do estúdio para reutilização.
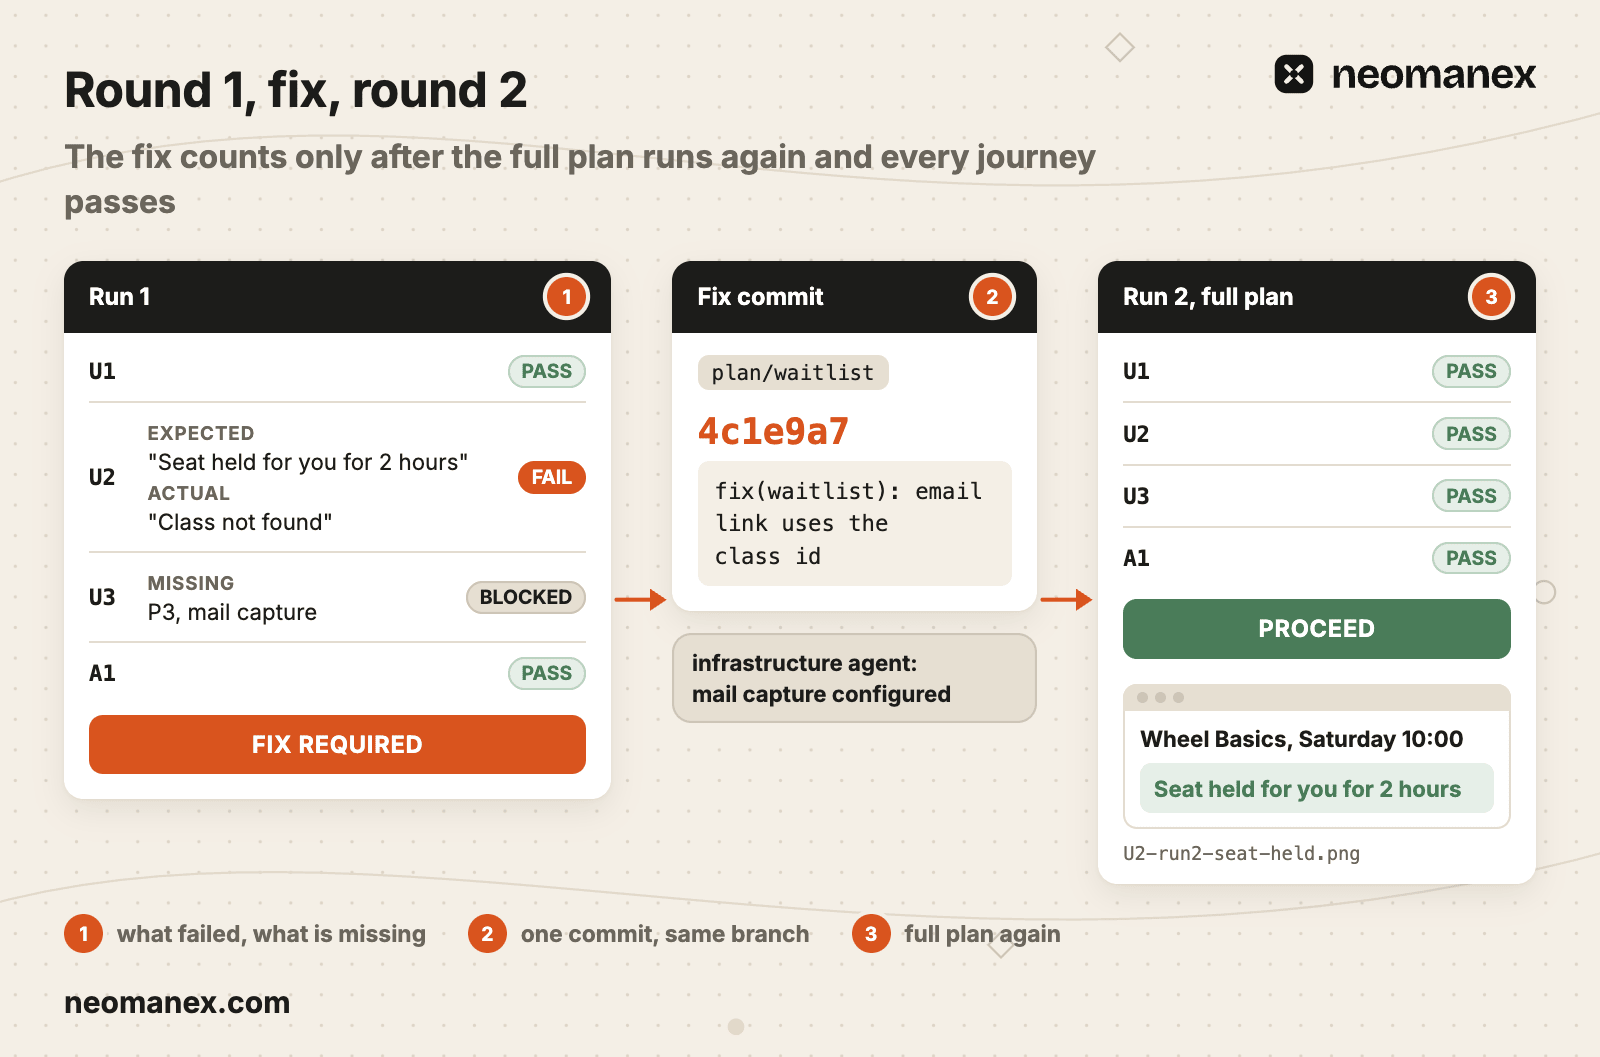
Execução 1. O testador de aceitação conduz quatro percursos a 1440x900 e volta a verificar a 390x844 os ecrãs que dependem do layout.
| Percurso | Veredito | O que observou |
|---|---|---|
| U1 | PASS | «You are #1 on the waitlist» (é o n.º 1 da lista de espera) |
| U2 | FAIL | O link do email abre «Class not found» (aula não encontrada): leva o id da entrada na lista de espera, não o id da aula |
| U3 | BLOCKED | Falta a P3: não há captura de correio no ambiente da branch, como indica o cabeçalho |
| A1 | PASS | GET /v1/classes/{id}/waitlist como dono devolve 200 com o aluno A na posição 1 |
Recomendação: FIX REQUIRED. O U2 é uma junção: a API e a aplicação passam cada uma nos seus testes unitários, e só o percurso atravessa as duas.
Decidir. Uma pessoa aprova o relatório e decide que o plano falhou. O U2 é código que este plano entregou, por isso é corrigido na branch e não registado como ticket.
Corrigir. O agente de desenvolvimento reproduz o U2 no mesmo ambiente, altera o link, corre o teste unitário do ficheiro alterado e faz commit de fix(waitlist): email link uses the class id (4c1e9a7) em plan/waitlist. O agente de infraestrutura configura a captura de correio.
Execução 2. O plano inteiro volta a correr: os quatro percursos, não só o U2 e o U3. Todos passam, e a captura de ecrã do U2 mostra «Seat held for you for 2 hours» (lugar reservado para si durante 2 horas). Recomendação: PROCEED. A decisão é aprovar, e o relatório alimenta a secção de verificação do merge request.
Como é o relatório e como o ler
Leia BLOCKED antes de FAIL. Um percurso que ninguém conseguiu conduzir é o que mais provavelmente esconde um defeito real.
| Parte | O que contém |
|---|---|
| Cabeçalho | Execução, execução anterior com contagens, branch e head, hosts, viewports, veredito |
| Declarações obrigatórias do cabeçalho | Tudo o que a execução não conseguiu testar, cada item identificado. Execução 1: «Captura de correio P3 não configurada: U2 e U3 dependem dela» |
| Resultados dos percursos | Uma linha por percurso, execução anterior ao lado da atual, imagens de prova |
| Falhas em detalhe | Passo, esperado, obtido, prova, correção recomendada |
| Checklist de regressão | Reservar uma aula sem lotação esgotada continua a funcionar. Cancelar uma reserva continua a libertar o lugar |
| Recomendação | PROCEED ou FIX REQUIRED |
| Veredito | Significado |
|---|---|
| PASS | Cada passo observado tal como o critério indica |
| PARTIAL PASS | O percurso funciona, mas uma observação declarada não se verifica por completo |
| FAIL | O resultado real de um passo difere do esperado |
| BLOCKED | Não foi possível conduzir o percurso; o item em falta é identificado |
| COVERED BY SUITE | Provado por um teste de regressão automatizado que o relatório cita, sem ser conduzido de novo |
Os nossos planos têm mais uma regra: um passo que precisou de um pré-requisito não documentado, de uma nova tentativa ou de uma correção manual é FAIL, mesmo que o comportamento tenha funcionado no fim. Um PASS que precisou de ajuda não vai passar para um utilizador. E um PASS cuja captura de ecrã não mostra o elemento verificado não é prova: quem aceita o veredito abre as imagens.

O que corre mal: junções que nenhuma camada assumia
A maioria das nossas falhas de aceitação não foram bugs que escaparam ao modelo. Foram junções entre camadas que nenhuma camada assumia.
A principal tem a forma do U2 da Quillbay: uma primeira execução de aceitação chumba uma grande parte dos percursos enquanto todas as camadas inferiores estão verdes, e cada defeito fica entre camadas. A regra que daí saiu: correr a aceitação num ambiente real antes de os passos de revisão deixarem de ser baratos, e reservar uma segunda execução completa para qualquer plano com superfície de UI, API e MCP.

| Falha | Regra que produziu |
|---|---|
| Rondas de correção introduziram regressões que a execução seguinte apanhou. Na Quillbay, uma correção do U2 que também arrumasse a página da aula partiria o U1 | Corrigir só as falhas reportadas, sem arrumações. A nova execução completa apanha o que uma correção partiu, e uma pessoa decide quando parar o ciclo |
| Duas sessões partilharam um único browser do Playwright MCP. Outra sessão navegou no separador a meio do percurso e o estado observado desapareceu | Cada sessão conduz o seu próprio contexto de browser ou um script Playwright autónomo, volta a encontrar a sua página em cada chamada e verifica o URL antes de ler |
| Um percurso passou no servidor de desenvolvimento e mostrou conteúdo desatualizado depois da build | Os percursos que dependem de prerender ou do modo de cache correm numa imagem construída ou num ambiente implementado: um servidor de desenvolvimento renderiza cada pedido de raiz |
| Uma configuração em falta deixou um percurso BLOCKED durante várias execuções e escondeu outro defeito atrás dele | BLOCKED é um veredito que identifica o item em falta no cabeçalho. A execução nunca finge um PASS |
| Um plano continha verificações que o ambiente nunca podia satisfazer: uma regra já partida em main, um início de sessão que o ambiente não tinha | O planeador de testes verifica cada percurso face ao que o ambiente consegue realmente fazer |
Separar a deteção da correção em trabalhos distintos é também a espinha dorsal do nosso ciclo de autorreparação do website.
Construa o seu: as instruções que cada agente recebe
Comece pelos critérios e pela regra «nunca corrigir». O Playwright MCP é a parte fácil. O testador serve para verificar, não para investigar: depure primeiro e execute a aceitação quando acreditar que a build funciona. Os passos abaixo dão a ordem; estas são as instruções, prontas a copiar.
Planeador de testes: o modelo de percurso.
Para cada critério congelado, escreva UM percurso:
  ID: U<n> (UI) ou A<n> (API/MCP)
  Critério: <FR id>, citado palavra por palavra
  Pré-condições: cada uma com «Como confirmar».
    Uma pré-condição em falta é um bloqueio,
    não algo a contornar.
  Passos: numerados; cada um indica o que vai observar.
  Viewports: 1440x900; volte a verificar a 390x844
    todos os ecrãs que dependem do layout.
  Fixtures: prefixo acc-<plan>-<run>-; varrimento no fim.
Confirme cada percurso face ao que o ambiente
consegue realmente fazer.
Agente de infraestrutura: preparar e verificar.
Prepare o ambiente da branch do plano e prove que está verde.
1. Inicie todos os serviços que o plano toca. Todos têm de
   estar ativos.
2. Provisione dados e credenciais APENAS pelo mecanismo
   do plano. Sem mecanismo: pare e pergunte. Registe as
   credenciais para o testador.
3. Verifique:
   - o endpoint de health devolve 200
   - um endpoint de dados REAL devolve 2xx, não só o health
   - chamada sem autenticação: 401/403; autenticada: 2xx
     (MCP: tools/list E uma chamada autenticada a uma ferramenta)
   - 3-5 páginas principais via Playwright: sem erros na
     consola, sem pedidos falhados, sem ecrãs em branco
   - o fluxo principal funciona de ponta a ponta uma vez
4. Corrija o que está vermelho, volte a verificar e avance
   só com verde. Reporte defeitos do produto com localização
   e provas.
Não execute os percursos. Não desmonte nada.
Testador de aceitação: executar e reportar.
O ambiente está preparado e em execução. Reutilize as
credenciais registadas. Não inicie nem desmonte nada.
Execute cada percurso de UI com o Playwright MCP, cada
percurso de API/MCP com chamadas reais e, depois, a
checklist de regressão.
Siga o plano por ordem. Nunca corrija código. Nunca ignore
uma falha. Nada de testes improvisados.
Tire uma captura de ecrã de cada observação que decide
um passo. Registe os corpos das respostas da API.
Veredito por percurso: PASS, PARTIAL PASS, FAIL, BLOCKED,
COVERED BY SUITE.
Relatório: Cabeçalho; Declarações obrigatórias do
cabeçalho (o que não conseguiu testar, cada item
identificado); Resultados dos percursos; Falhas em detalhe
(passo, esperado, obtido, prova, correção recomendada);
Checklist de regressão; Recomendação: PROCEED ou
FIX REQUIRED.
Regra de decisão.
PASS só quando cada percurso é PASS ou uma exceção
aceite: uma falha em código que esta alteração não
entregou, registada no seu próprio ticket e citada pelo id.
Tudo o resto é FAIL: envie o relatório para a correção e,
depois, execute o plano INTEIRO de novo.
Uma falha em código que esta alteração entregou é
corrigida na branch, nunca registada num ticket à parte.
Não é claro se um comportamento é intencional? Decide
uma pessoa.
Agente de desenvolvimento: corrigir.
Para cada percurso falhado: reproduza-o no mesmo
ambiente, encontre a causa, corrija-a e volte a conduzir
o percurso ao vivo.
Corrija só o que as falhas exigem. Sem minúcias, sem
arrumações.
Corra verificações unitárias e de lint só nos ficheiros
alterados.
Faça commit na mesma branch. Registe o que mudou e porquê.
Nunca certifique a sua própria correção: a nova execução
é a prova.
Esta camada não substitui o CI: os testes unitários, de integração e de regressão continuam a ser o ponto de controlo determinístico no pipeline de merge.
Passos
Escrever critérios observáveis e congelá-los
Dê a cada critério um ator, um comportamento e algo que se possa observar no ecrã ou numa resposta. A aprovação de uma pessoa congela a lista; uma alteração de âmbito volta a este passo.
Escrever um percurso por critério
Cite o critério palavra por palavra, indique o respetivo id, enumere as pré-condições com a forma de confirmar cada uma e declare uma observação para cada passo.
Preparar o ambiente num passo próprio
Um agente de infraestrutura provisiona dados e credenciais pelo mecanismo do plano e prova que o health, um endpoint de dados real, a autenticação nos dois sentidos e as páginas principais estão verdes antes de alguém testar.
Executar os percursos com um testador separado
Dê ao testador de aceitação o Playwright MCP no seu próprio contexto de browser, chamadas reais para os percursos de API e duas regras: nunca corrigir, nunca ignorar uma falha.
Ler o relatório e decidir
Leia primeiro as linhas BLOCKED. Só passa quando cada percurso é PASS ou uma exceção aceite registada no seu próprio ticket.
Corrigir na branch e voltar a executar tudo
O agente de desenvolvimento corrige só as falhas reportadas e faz commit na mesma branch. O plano inteiro volta a correr; ninguém certifica a sua própria correção.
Perguntas frequentes
O que são testes de aceitação conduzidos por agentes?
Testes de aceitação conduzidos por agentes são um ciclo de verificação em que um agente de IA conduz cada percurso do utilizador num browser real e indica se passa ou falha face a critérios de aceitação congelados. O ConvOps executa-os como passos de um fluxo de trabalho: uma pessoa congela os critérios, um planeador de testes escreve um percurso por critério, um testador de aceitação separado conduz os percursos com o Playwright MCP e qualquer falha é corrigida na branch antes de o plano inteiro voltar a correr.
A quem se destinam os testes de aceitação conduzidos por agentes?
Os testes de aceitação conduzidos por agentes destinam-se a responsáveis de engenharia e fundadores que lançam funcionalidades com agentes de programação como o Claude Code. O ConvOps executa-os depois da construção de cada plano, para que cada critério aprovado por uma pessoa fique provado na aplicação em execução, com uma captura de ecrã por cada observação decisiva, antes da revisão do merge request.
É possível usar agentes de IA em testes de QA?
Sim, como camada de percursos. No ConvOps, um agente testador de aceitação conduz cada percurso do utilizador com o Playwright MCP e cada percurso de API com chamadas reais, e depois reporta um veredito por percurso, com provas. Nunca corrige código e nunca ignora uma falha. A suíte de regressão no CI continua a ser o ponto de controlo determinístico, e uma pessoa lê o relatório antes da decisão.
O Playwright MCP é fiável para testes de aceitação?
Sim, como veículo, em duas condições. O ConvOps prova que o ambiente está verde antes de o testador chegar, e cada sessão conduz o seu próprio contexto de browser, volta a encontrar a sua página em cada chamada e verifica o URL antes de ler. Um browser partilhado perde o estado quando outra sessão navega no separador. Cada observação decisiva tem uma captura de ecrã que mostra o elemento verificado.
Como ponho um agente de programação com IA a testar o seu próprio código num browser real?
Adicione o servidor MCP do ConvOps em https://mcp.convops.app/ ao seu cliente de IA e inicie sessão uma vez. Depois escreva critérios de aceitação observáveis e congele-os, peça a um planeador de testes um percurso por critério e dê a um segundo agente o Playwright MCP para os conduzir. Quem constrói nunca avalia o próprio trabalho: as falhas são corrigidas na branch e o plano inteiro volta a correr.
Os testes de aceitação conduzidos por agentes substituem o UAT humano?
Não. No ConvOps, o agente verifica face a critérios que uma pessoa aprovou antes da construção, e uma pessoa lê e aprova cada relatório. Uma constatação em que ninguém sabe se o comportamento é intencional vai para uma pessoa antes da decisão de aprovar ou reprovar. O agente pronuncia-se sobre o que observou, nunca sobre a intenção.
Os testes de aceitação com um agente de IA substituem os testes de CI?
Não. Nos planos do ConvOps, os testes unitários, os testes de integração e a suíte de regressão correm no pipeline de merge como ponto de controlo determinístico. A aceitação conduzida por agentes é uma quarta camada: conduz percursos na aplicação em execução e apanha defeitos que vivem entre camadas que passaram cada uma por si. Não decide o merge sozinha.
O que acontece quando o agente não consegue testar um percurso?
O percurso fica BLOCKED e o cabeçalho do relatório identifica o que falta, como uma caixa de captura de correio que o ambiente não tinha. O ConvOps nunca conta BLOCKED como aprovação. O agente de infraestrutura fornece o que faltava e o plano inteiro volta a correr. Leia primeiro as linhas BLOCKED: um percurso que ninguém conseguiu conduzir pode esconder um defeito real.