
O que vai conseguir fazer
- Desenhar as seis camadas de aprendizagem na sua própria stack de agentes.
- Dar um tipo às suas memórias por categoria e decidir o que cada categoria alimenta.
- Acrescentar a um fluxo de trabalho a recuperação no início, o Learning Capture (captura de aprendizagens) no fim e passos que encontram lacunas.
- Montar um registo central de falhas com limite e uma passagem de consolidação mensal.
- Escolher o primeiro ponto de aprovação a entregar a uma verificação registada, e os que nunca mudam.
Pontos-chave
- Um sistema de IA que se melhora a si próprio melhora os seus ficheiros, memórias e passos de fluxo de trabalho, nunca o modelo: as lições de cada trabalho concluído passam a regras que o trabalho seguinte lê.
- Aprende em seis camadas, e cada uma é um ciclo: memória, Learning Capture (captura de aprendizagens), edições ao fluxo de trabalho, passos que encontram lacunas, atrito registado no momento em que surge e um pipeline que revê o sistema inteiro.
- As memórias têm tipo, dado pela categoria, e cada categoria alimenta um sítio diferente: as correções passam a regras candidatas, as decisões são recuperadas, os procedimentos passam a passos de fluxo de trabalho.
- Um teste de classe ou caso isolado, um registo central de falhas limitado a 15 entradas por secção e uma consolidação mensal mantêm as regras pequenas o suficiente para serem lidas.
- A autonomia é o resultado: os pontos de aprovação passam a verificações registadas à medida que as camadas os tornam previsíveis, enquanto os merges, a publicação e as ações irreversíveis ficam com uma pessoa.
Para construir um sistema de IA que se melhora a si próprio, deixe o modelo em paz e melhore tudo o que está à volta dele. Um sistema de IA que se melhora a si próprio é um repositório de normas, um armazém de memória e fluxos de trabalho com pontos de aprovação que transformam as lições de cada trabalho concluído em regras que o trabalho seguinte lê. Os pesos do modelo nunca mudam. O sistema aprende em seis camadas, e cada uma é um ciclo que escreve uma lição no sítio onde o trabalho seguinte a lê.
Corremos as seis camadas no ConvOps, onde vivem as nossas tarefas, fluxos de trabalho, pontos de aprovação e memória, e continuamos a fazê-las evoluir todas as semanas. Este guia é a construção, escrito para líderes de engenharia, engenheiros de plataforma e fundadores técnicos que põem agentes de programação ou de conteúdo a fazer trabalho recorrente. Para ver como é uma semana normal, em linguagem simples, leia o guia central desta série, como gerimos a nossa empresa com agentes de IA. Comece pelas camadas 1 e 2 num fluxo de trabalho que corre todas as semanas; o resto assenta no que elas escrevem.
Aqui, «melhorar-se a si próprio» é processual. Não é autoaperfeiçoamento recursivo, e nada é retreinado. Cada lição fica numa memória, num passo de fluxo de trabalho ou numa norma escrita que uma pessoa pode ler, rever e reverter. É essa a força do desenho: vê exatamente o que o sistema aprendeu, onde o escreveu e quem o aprovou.
Todos os exemplos usam a Copperfern, uma loja online fictícia de artigos para a casa que vende utensílios de cozinha e roupa de mesa, em inglês e em espanhol, em copperfern.example.com. Os nomes dos passos, os pontos de aprovação, as categorias e os limiares são os nossos. A empresa, as pessoas e todos os valores são inventados. A Maya é a pessoa que aprova no ponto de aprovação Merge (integração do código).
O que faz um sistema de IA que se melhora a si próprio
Um sistema de IA que se melhora a si próprio transforma um erro numa regra uma única vez, para que nenhum trabalho posterior o repita. Assenta em três partes: um repositório de normas e ficheiros de instruções que os agentes leem, um armazém de memória que cada trabalho consulta primeiro e onde escreve enquanto trabalha, e fluxos de trabalho com pontos de aprovação que fixam o que corre, por que ordem e onde uma pessoa aprova.
Sobre essas três partes assentam seis camadas de aprendizagem, da mais básica à mais avançada. Cada camada é um ciclo: algo acontece num trabalho, uma lição fica escrita num sítio e um trabalho posterior lê-a aí.

| Camada | O ciclo | O que escreve | Onde o trabalho seguinte a lê | Quem aprova |
|---|---|---|---|---|
| 1 Memória | Recuperar antes do trabalho, guardar durante e depois | Uma memória com tipo: uma decisão, uma correção, uma armadilha | O primeiro passo de cada trabalho relacionado | Ninguém: guardar é o comportamento por omissão |
| 2 Learning Capture (captura de aprendizagens) | O último passo de cada fluxo de trabalho guarda o que a execução ensinou | Memórias e rotas | A recuperação, e todas as camadas acima | Ninguém: o agente decide o que vale a pena guardar |
| 3 Edições ao fluxo de trabalho | Uma lição repetida passa a ser uma linha num passo, ou um passo novo | O próprio fluxo de trabalho | Cada execução desse fluxo de trabalho, sem precisar de recuperação | Uma pessoa aprova a edição |
| 4 Passos que encontram lacunas | Passos dentro do fluxo de trabalho verificam o trabalho face às normas e escrevem a regra em falta | Normas, ficheiros de regras, ficheiros de instruções, candidatos ao registo central de falhas | O passo de descoberta de cada tarefa posterior, e cada revisão de plano | O agente avalia uma lacuna de classe e regista-a; uma pessoa aprova o merge |
| 5 Registado quando surge | O atrito passa a tarefa no momento em que aparece; as regras que nunca podem falhar passam a hooks | Tarefas e hooks | O backlog, e o harness em cada chamada a uma ferramenta | Registar não precisa de ninguém; uma pessoa define o horizonte |
| 6 Pipeline de memória | Lê todas as categorias em todos os espaços de trabalho, funde, promove, retira e sugere | Entradas do registo central, propostas de regras, alterações a agentes e a instruções | Tudo o que está acima | As pequenas edições entram diretamente; as regras novas precisam de uma pessoa |
As camadas de baixo são baratas e veem um trabalho. As de cima são mais lentas e veem o sistema inteiro. Construa-as por ordem, porque cada camada de cima lê o que as de baixo escrevem. Em termos de consultoria, é uma etapa do percurso do modelo operacional de IA; este guia fica-se pela mecânica.
Camada 1: memória recuperada antes de cada trabalho e guardada depois
Um agente que começa cada sessão do zero repete todos os erros que já cometeu. A memória é o primeiro ciclo, e só funciona quando cada trabalho lê antes de escrever.
O que é a memória de um agente de IA num sistema que se melhora a si próprio? A memória de um agente de IA é um armazém de notas curtas com tipo (decisões, correções, armadilhas, procedimentos e mais) que cada trabalho consulta no primeiro passo e onde escreve enquanto trabalha. Temos um único armazém para todos os espaços de trabalho e todos os agentes ligados, tanto o Claude Code como o OpenCode, por isso uma lição guardada no espaço do apoio ao cliente é encontrada por uma tarefa do site.
Recuperar primeiro, guardar pelo caminho
O primeiro passo dos nossos fluxos de trabalho começa pela recuperação. Uma chamada, context_query, devolve duas coisas de uma vez: rotas, que registam onde as coisas estão (módulos, ficheiros, documentação), e memórias, que registam o que sabemos. Uma chamada mais restrita, memory_recall, filtra por categoria, etiquetas e importância mínima quando um passo só precisa de um tipo de nota.
Guardar é memory_store com uma categoria, uma importância de 1 a 10 e etiquetas. A recuperação ordena por significado, importância e recência, por isso o agente define a importância consoante o que um trabalho posterior perde se não vir a nota. Uma nota nova que repete uma existente substitui-a, em vez de ficar ao lado dela como duplicado.
A tarefa de checkout da Copperfern começa por recuperar a decisão «Todas as datas guardadas em UTC, mostradas no fuso horário do cliente (março)» e a armadilha «O email da encomenda formata as datas no seu próprio modelo». Antes de o agente escrever uma linha de código, já conhece a regra e a armadilha.
As memórias têm tipo, e cada tipo alimenta um sítio diferente
A categoria é o campo mais importante de uma memória, porque decide para onde vai a lição a seguir. Uma correção é uma regra candidata. Uma decisão é para recuperar, não para reabrir. Uma preferência pertence a um ficheiro de instruções, onde cada sessão a lê sem consulta.
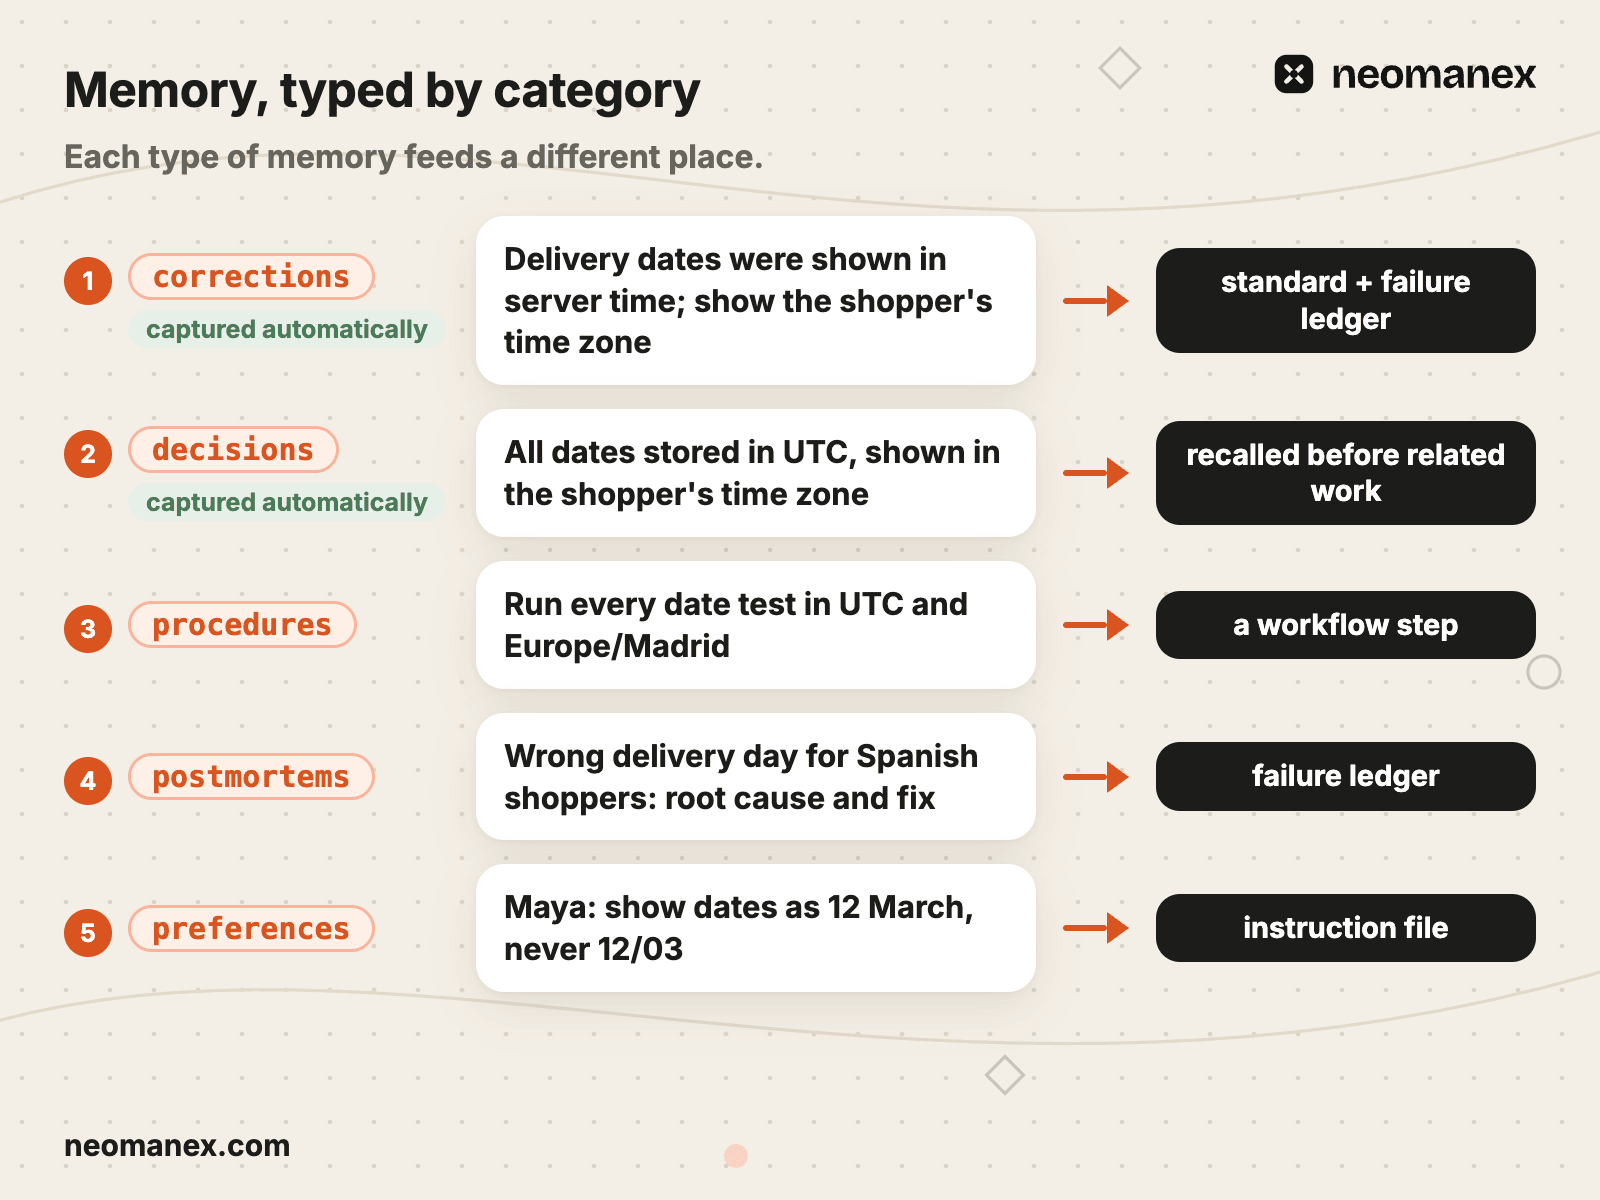
| Categoria | Memória da Copperfern | O que alimenta a seguir |
|---|---|---|
corrections | «As datas de entrega eram mostradas na hora do servidor; mostrar o fuso horário do cliente» | Uma regra candidata para uma norma e para o registo central de falhas |
gotchas | «O email da encomenda formata as datas no seu próprio modelo» | Uma regra candidata; recuperada antes de qualquer alteração a datas |
decisions | «Todas as datas guardadas em UTC, mostradas no fuso horário do cliente (março)» | Recuperada antes de trabalho relacionado |
context | A nota de merge da Maya: «Aprovado depois de passar o teste de Madrid» | Fica na sua tarefa, recuperada quando esse trabalho é retomado |
procedures, patterns | «Correr cada teste de datas em UTC e em Europe/Madrid» | Passos de fluxo de trabalho e normas |
postmortems | «Dia de entrega errado para clientes espanhóis: causa raiz e correção» | O registo central de falhas |
preferences | «Maya: mostrar as datas como 12 de março, nunca 12/03» | Ficheiros de instruções |
progress | «Tarefa da data de entrega com merge feito, branch limpo» | Fica na sua tarefa |
reference, customers, marketing, posts | Conhecimento de domínio guardado para o seu próprio trabalho | Recuperado por domínio |
A camada 6 lê todas estas categorias de uma vez. É aí que uma correção num espaço e uma armadilha noutro se revelam a mesma lição.
Algumas memórias guardam-se sozinhas
Três canais automáticos guardam sem que ninguém o peça, à medida que os eventos do ciclo de vida acontecem. Cada um fica desligado até ser ativado por espaço de trabalho, e nós temos os três ligados:
decisions: quando um passo de decisão fica resolvido, uma tarefa é cancelada ou alguém escreve uma nota DECISION (decisão).progress: em cada avanço de passo e em cada conclusão.corrections: quando alguém escreve uma nota BLOCKER (bloqueio), como uma rejeição num ponto de aprovação.
Além destes, as notas context= são escritas sempre que são passadas. O parâmetro context= nas chamadas de tarefas e de fluxos de trabalho guarda a nota como memória context na mesma chamada da ação. Uma definição do espaço de trabalho controla-o, e vem ligada por omissão.
Tudo o resto é guardado de propósito. Uma nota context= tem 2 a 3 linhas, uma decisão e o porquê, nunca um relatório de estado. Uma nota com menos de 40 caracteres não chega a ser guardada, porque as notas vazias envenenam a recuperação, e esse mínimo vive no armazém, não na disciplina de alguém.
As notas de acompanhamento das tarefas (context e progress) ficam na sua tarefa. São marcadas e mantidas fora da recuperação de outras tarefas por omissão, para que uma linha de estado do mês passado nunca passe à frente de uma decisão.
Quem aprova uma memória
Ninguém. Guardar é o comportamento por omissão, e o agente define a importância. Uma memória fraca é substituída ou fundida mais tarde, na camada 6, nunca aprovada à entrada. Um passo de aprovação aqui faz os agentes guardarem menos, e uma lição em falta custa muito mais do que uma ruidosa que o pipeline funde.
O que correu mal com a memória, e a regra que daí saiu
O nosso primeiro desenho de memória tinha uma categoria para tudo, learnings. Tudo acabava lá, e a recuperação devolvia um monte de notas misturadas para qualquer consulta. A regra: learnings está descontinuada na nossa norma de memória para memórias novas, e as memórias vão para categorias específicas, cada uma com a sua função. Na Copperfern, esse mesmo monte tinha datas, emails e preços lado a lado; agora cada nota tem um tipo e um destino.
A segunda falha veio depois de ligarmos os canais automáticos. As notas de acompanhamento das tarefas eram mais numerosas do que o conhecimento deliberado e passavam-lhe à frente na recuperação. A regra: as notas de acompanhamento são marcadas e ficam fora, por omissão, da recuperação entre tarefas, e cada canal de captura novo chega com um peso de recuperação, uma classe de elegibilidade e uma importância configurável.
Se os seus agentes começam cada sessão do zero, construa esta camada primeiro. O ConvOps é onde a corremos: fluxos de trabalho com um passo de recuperação no início e Learning Capture no fim, e um único armazém de memória que todos os agentes ligados leem. Veja como funciona o ConvOps(abre num novo separador).
Camada 2: Learning Capture, o último passo de cada fluxo de trabalho
Se guardar uma lição depende de o agente se lembrar de o fazer, não acontece. Por isso, no nosso sistema, é um passo, e é o último de cada fluxo de trabalho.
Learning Capture é um passo global. Definimo-lo uma vez, e o motor de fluxos de trabalho acrescenta-o, seguido de Complete (concluir), a todos os fluxos de trabalho abrangidos. Ninguém o acrescenta à mão a um fluxo de trabalho novo, e ninguém se pode esquecer dele. Os fluxos de trabalho de correção, e os que correm fases isoladas de um plano maior, ficam fora do seu âmbito.
O passo diz ao agente:
Capture as aprendizagens desta execução do fluxo de trabalho. Guarde decisões, armadilhas e padrões com memory_store(). Indexe os novos caminhos de código como rotas se tiverem sido criadas áreas de código relevantes: route_create para uma área nova, ou route_update para alargar uma existente. Consulte primeiro a rota existente e junte os caminhos manualmente, porque route_update substitui cada campo que enviar. Se não aconteceu nada digno de nota, salte com «no learnings to store» (sem aprendizagens a guardar).
Esse texto tem três escolhas de desenho:
- Indica as categorias. Decisões, armadilhas, padrões: o agente guarda memórias com tipo, não um diário da execução.
- Indexa o código novo como rotas. A recuperação do trabalho seguinte diz onde está o código, além do que sabemos sobre ele.
- Permite saltar. Uma execução sem nada de novo não guarda nada, de propósito. Uma nota forçada em cada execução é a inundação de notas de acompanhamento da camada 1 a voltar.
Os fluxos de trabalho com um passo de aprendizagem próprio correm os dois. O nosso ciclo de melhoria (camada 3) tem um passo Learn (aprender) que guarda o que cada ciclo ensinou, e o Learning Capture global continua a correr antes do Complete.
O Learning Capture alimenta três sítios: o armazém que a camada 1 recupera, as edições ao fluxo de trabalho da camada 3 e o pipeline da camada 6. Ninguém o aprova; o agente decide o que vale a pena guardar.
A tarefa da data de entrega da Copperfern termina com o Learning Capture a guardar a armadilha «O fuso horário do servidor passa para as datas de entrega; testar em Europe/Madrid» e uma rota para o novo módulo de formatação de datas. A tarefa de datas seguinte encontra as duas no primeiro passo: o que testar e onde está o código.
O que correu mal. Havia sessões que editavam ficheiros e terminavam sem nada guardado. Um passo no fim de um fluxo de trabalho não apanha trabalho feito fora de um fluxo de trabalho, nem uma sessão que para antes do último passo. A regra: um hook Stop (de paragem) no harness de agente (no Claude Code, um script que corre sempre que o agente para) verifica a cada 2 turnos do assistente se a sessão guardou alguma coisa. Uma sessão que editou ficheiros sem nada guardado é assinalada de imediato, sem esperar pela contagem de turnos. O protocolo nunca depende da memória de ninguém, incluindo a do agente.
Camada 3: fluxos de trabalho que se editam a si próprios
Uma lição que só vive na memória depende de a recuperação a encontrar. Uma lição escrita no passo é lida sempre que o trabalho chega a esse passo. Por isso, a terceira camada transforma o que o Learning Capture encontrou numa edição do próprio fluxo de trabalho: uma instrução mais precisa, um passo novo, um ponto de aprovação novo, um ciclo com limite.
É por isso que guardamos os procedimentos em fluxos de trabalho e não num ficheiro de instruções comprido. Um fluxo de trabalho é um grafo de passos, por isso uma lição vai para o único passo que precisa dela, não para um ficheiro que todos os passos têm de ler (a ideia por trás do graph engineering (engenharia de grafos)).
Como muda um passo
As edições são cirúrgicas: um passo de cada vez, nunca a reconstrução de um fluxo de trabalho em produção. Cada edição só entra com zero avisos de validação, e depois é lida de volta a partir do motor para confirmar que o passo diz o que se pretendia. Antes de uma alteração estrutural, como mover ou remover um passo, verificam-se as execuções em curso, para que nenhuma tarefa ativa descubra que o seu passo seguinte desapareceu.
O texto de um passo contém só procedimento: o que o executor faz nesse passo. O motivo de uma alteração vai para uma memória, nunca para o passo. Um passo cheio de histórico é um passo que os agentes leem na diagonal.
O fluxo de trabalho de desenvolvimento da Copperfern aprende a lição da data de entrega numa linha:
Implement
  (existing instructions unchanged)
+ Run every date test in UTC and Europe/Madrid.
A partir daí, cada tarefa que chega ao Implement (implementar) lê a linha. Nenhuma recuperação tem de a classificar, e nenhum agente tem de se lembrar dela.
Uma pessoa aprova as edições ao fluxo de trabalho. O agente propõe a alteração e, depois de aprovada, faz a edição cirúrgica. Uma correção de uma linha numa norma ou num ficheiro de instruções para onde um passo aponta entra diretamente, ao abrigo da nossa norma de ficheiros de instruções (a camada 5 explica onde fica essa fronteira).
O ciclo de melhoria: uma melhoria por ciclo
Há trabalho que melhora um entregável em vez de concluir uma tarefa: uma página, um texto, uma auditoria recorrente. Para isso corremos o fluxo de trabalho Autonomous Cycle (ciclo autónomo), um ciclo que edita o seu próprio resultado, uma alteração de cada vez.
| Passo | O que faz |
|---|---|
| Analyze (analisar) | Recupera lições anteriores sobre este entregável (importância mínima 5, no máximo 10) e escreve uma análise |
| Validate (validar) | Recupera decisões passadas (até 10) e armadilhas (até 5). Se a análise tiver falhas ou repetir uma decisão passada, escreve porquê e devolve o ciclo ao Analyze |
| Plan (planear) | Escolhe a melhoria de maior impacto. Uma por ciclo, bem feita |
| Execute (executar) | Faz essa única alteração |
| Learn | Guarda o que o ciclo ensinou |
| Continue? (continuar?) | improve-more agenda o ciclo seguinte para daqui a um minuto; done fecha a execução. Um limite de ciclos, quando a execução o define, trava-o |
Seguem-se o Learning Capture e o Complete, como em todos os fluxos de trabalho. Uma melhoria por ciclo mantém cada passo pequeno e verificável: um ciclo que muda cinco coisas não consegue dizer qual delas ajudou. O regresso do Validate ao Analyze impede o ciclo de propor o que já foi decidido em contrário.
O que correu mal com os fluxos de trabalho, e as regras que daí saíram
Os nossos guias foram publicados só em inglês depois de uma tarefa de tradução separada ter deixado de correr, e nada no fluxo de trabalho dos guias deu por isso. A regra: a tradução passou a ser um passo dentro do fluxo de trabalho dos guias, seguido de um juiz de tradução que tem de devolver zero problemas em cada idioma. Na Copperfern, as páginas em espanhol ficavam atrás das inglesas pelo mesmo motivo; agora o fluxo de trabalho das páginas traduz e avalia antes de poder publicar.
Os passos de revisão também andavam em ciclo sem convergir, e cada ronda encontrava algo novo. A regra: cada revisão rejeita para um passo de correção, e ao fim de 2 rondas regista um bug e para, em vez de correr uma terceira. Uma revisão em ciclo gasta execuções; um bug traz uma pessoa, com as provas.
Camada 4: passos que encontram lacunas e corrigem as normas
O melhor sítio para encontrar uma regra em falta é o fluxo de trabalho que acabou de precisar dela. Por isso, o nosso fluxo de trabalho de desenvolvimento traz os seus próprios passos de deteção de lacunas. Verificam o trabalho face às normas, descobrem onde uma norma falta ou é fraca e escrevem a correção antes de a tarefa seguinte começar.
O fluxo de trabalho é o Development Task (MR flow) (tarefa de desenvolvimento, fluxo de MR). Estes são os passos que importam para esta camada, por ordem, com os cinco passos de deteção de lacunas numerados como na imagem abaixo. Outros passos, como a documentação de casos de uso, o push e as verificações de CI, correm entre eles:
Functional Analysis (análise funcional; uma pessoa aprova e a lista de requisitos fica congelada) → 1 Discover Standards & Flag Gaps → Technical Analysis (análise técnica) → 2 Traceability Check (one pass) → Implement → 3 Check Standards Compliance e Compliance Decision → 4 Terminal Gap Check → Update Documentation → Merge (Verification Review + CI Green + Operator) (merge: revisão de verificação, CI verde e operador) → Standards Check? → 5 Standards Capture → Learning Capture → Complete.

1. Discover Standards & Flag Gaps
Antes de qualquer desenho, este passo (descobrir normas e assinalar lacunas) põe um agente de descoberta de normas a ler os nossos ficheiros de encaminhamento (um por equipa, a fonte única de verdade sobre que normas se aplicam a que trabalho) e a produzir a lista de normas que regem esta tarefa. A mesma passagem abre cada norma e assinala uma lacuna quando:
- nenhuma norma cobre a área
- existe uma norma, mas falta-lhe o padrão de que este trabalho precisa
- uma norma está desatualizada ou contradiz a prática
- o trabalho introduz um padrão novo que nenhuma norma trata
- existe um ficheiro de normas a que nenhum ficheiro de encaminhamento chega
Com zero lacunas, o passo di-lo e avança sem esperar. Com qualquer lacuna, para, e uma pessoa decide lacuna a lacuna: criar uma tarefa, alargar uma norma existente ou aceitar o risco. Ao avançar, a lista fica bloqueada para este trabalho. Todas as verificações posteriores correm face à lista bloqueada, para que ninguém mude as regras a meio do jogo.
2. Traceability Check (one pass)
Depois da Technical Analysis, o Traceability Check (verificação de rastreabilidade) põe um analisador de lacunas a fazer uma passagem sobre uma checklist fechada de quatro pontos. Uma passagem, nunca um ciclo. Os bloqueios dos três primeiros pontos são corrigidos no momento, o quarto ponto para à espera de uma pessoa, e tudo o resto vai para a lista de vigilância de riscos conhecidos da tarefa, em vez de dar origem a outra ronda de revisão.
3. Check Standards Compliance e Compliance Decision
Depois do Implement, o Check Standards Compliance (verificar a conformidade com as normas) põe um revisor de normas a verificar a alteração face à lista bloqueada. O Compliance Decision (decisão de conformidade) lê o relatório:
| Problema | O que acontece |
|---|---|
| HIGH (alta) ou MEDIUM (média) | O fluxo de trabalho de correção corre uma vez. O revisor não volta a correr: a prova é a que apresenta quem fez a correção (lint, verificação de tipos e os testes unitários afetados a verde), citada nas notas da tarefa |
| LOW (baixa), uma linha | Corrigido no momento |
| LOW, mais de uma linha | Procura-se uma tarefa existente; se não houver, regista-se uma tarefa com a etiqueta discovered-during-execution, a citar ficheiro, linha e norma |
| Pré-existente | Nunca é corrigido aqui |
O passo passa com zero problemas HIGH e zero MEDIUM em aberto.
4. Terminal Gap Check
Antes da documentação e do merge, o Terminal Gap Check (verificação final de lacunas) faz três coisas. Cada ponto da lista de vigilância do passo 2 é fechado: um risco que se concretizou é corrigido agora, um que não se concretizou fica encerrado com uma justificação de uma linha. Cada requisito é associado à sua prova entregue, e um requisito sem prova recebe agora um teste ou para à espera de uma pessoa. E cada falha de execução que nada previu é guardada como memória failure-pattern com importância 7: são esses os candidatos ao registo central de falhas.
Segue-se o Update Documentation (atualizar documentação), escrito por um agente de documentação a partir do diff. Depois do push e das verificações de CI vem o ponto de aprovação Merge: precisa de um pipeline verde e da aprovação de uma pessoa, as duas coisas. É o único ponto de controlo do operador entre a análise aprovada e o merge, e um pipeline vermelho significa corrigir a causa, nunca fazer o merge por cima dele.
5. Standards Check? e Standards Capture
Depois do merge, o Standards Check? (verificação de normas) decide se a correção ensina alguma coisa às normas. Sim quando foi corrigido um bug que pode representar uma classe de erros, quando uma norma em falta ou fraca podia ter evitado o problema, ou quando a alteração revelou uma lacuna nas normas. Não para uma funcionalidade simples, uma refatoração sem mudança de comportamento ou uma alteração só de documentação.
O sim corre o Standards Capture (captura de normas), em três passos:
- Assess Standards Gap (avaliar a lacuna nas normas) lê as normas, os ficheiros de regras dos agentes e os ficheiros de instruções. Devolve «No gap» (sem lacuna) com um motivo de uma linha, ou «Gap found» (lacuna encontrada) com o ficheiro exato, a regra, o porquê e uma proposta de redação. Só recomenda uma regra quando o bug representa uma classe de erros que uma regra apanharia, nunca para um caso isolado.
- Standards Judgment (decisão sobre as normas) é a decisão do próprio agente, sem aprovação do operador. Antes de avançar, tem de registar o resultado como atividade. Essa atividade substituiu a assinatura de uma pessoa, e é a pista de auditoria.
- Apply Standard (aplicar a norma) só corre quando a lacuna foi considerada justificada. Um agente de documentação escreve a regra e depois relê o ficheiro para verificar que a edição ficou feita.
O teste de classe é o que mantém as normas legíveis. Uma regra para cada bug isolado incha uma norma até nenhum agente a ler com atenção.
A correção da data de entrega da Copperfern passa por aqui assim:
Standards Check?   yes
Assess             Gap found. Class: any date shown to a shopper can leak server time
Judgment (logged)  Standards judgment: applied dates-and-times.md, shopper time zone
Apply              dates-and-times.md v1.2
                   Store UTC; render in the shopper's time zone;
                   every date test runs in two time zones
O Standards Capture edita normas, ficheiros de regras e ficheiros de instruções. As correções a fluxos de trabalho chegam pela camada 3. As alterações às definições dos agentes vêm do que estes passos encontram e das sugestões da camada 6.
O registo central de falhas: a grelha das revisões de planos
O que é um registo central de falhas? Um registo central de falhas é uma lista selecionada de padrões de falha falsificáveis, cada um tirado de um incidente real, face à qual as revisões de planos fazem a auditoria. Cada entrada tem quatro campos: ID, padrão, verificação e incidente. Um revisor devolve PASS (passa), FAIL (falha) ou N/A (não aplicável) por entrada, e lê apenas a secção Global e a secção do seu próprio projeto.
| ID | Padrão | Verificação | Incidente |
|---|---|---|---|
FL-P1 | Data mostrada sem o fuso horário do cliente | Cada data no plano indica o seu fuso horário | Data de entrega nas páginas de produto |
| Regra do registo central | Valor | Porquê |
|---|---|---|
| Admissão | Só incidentes reais; os candidatos são promovidos na consolidação, nunca a meio de uma revisão | Um registo central de riscos imaginados é uma lista de desejos |
| Limite por secção | 15 entradas; no limite, as entradas sobrepostas fundem-se antes de entrar uma nova | «O limite é o que obriga a escolher» |
| Retirada | Só PASS ou N/A em 5 planos consecutivos: passa para Retired (retiradas) na consolidação | Uma verificação que nunca dispara custa em todas as revisões |
| Onde é verificado | Na revisão do plano seguinte | O fluxo de trabalho de desenvolvimento fornece candidatos; as revisões de planos leem o registo central |
O que correu mal. Uma revisão de plano correu ronda após ronda, cada uma a encontrar algo novo, e nunca convergiu. A regra: as revisões fazem a auditoria face a um registo central selecionado de padrões falsificáveis, tirados de incidentes reais, com cada problema apoiado no seu incidente, um limite por secção e um número limitado de rondas.
Camada 5: melhorias registadas enquanto o trabalho acontece
O momento mais barato para registar um atrito é o momento em que ele aparece. Uma lição lembrada no fim da semana já está meio perdida. Por isso, qualquer sugestão para melhorar um ciclo, um passo, uma norma ou uma ferramenta é registada como tarefa no momento em que é encontrada, e o trabalho continua.
A regra vive no nosso ficheiro de instruções raiz. Uma ação que não saiu à primeira (um teste que falha na primeira vez, um pré-requisito escondido, uma configuração em falta, um passo não documentado) é comunicada a uma pessoa, procura-se uma tarefa existente e, só se nenhuma corresponder, regista-se uma com a etiqueta discovered-during-execution. Todas essas tarefas ficam sob um único objetivo de saúde da engenharia, seja qual for o projeto de onde vieram, para que o atrito tenha uma só casa e um só backlog.
O Compliance Decision aplica a mesma regra dentro de um fluxo de trabalho: um problema LOW com mais de uma linha passa a tarefa, nunca a motivo para travar o merge.
Ao corrigir a data de entrega, o agente da Copperfern descobre que o email da encomenda formata as datas no seu próprio modelo. Regista «O email da encomenda ignora o fuso horário do cliente», com a etiqueta discovered-during-execution, e termina a tarefa em que estava. O email recebe a sua própria tarefa, a sua própria revisão e o seu próprio merge.
Registar não precisa de aprovação. Uma pessoa define o horizonte: agora, a seguir ou mais tarde. Quando a correção é uma pequena edição num ficheiro de instruções, numa norma ou num protocolo (uma linha, um valor desatualizado, uma gralha, sem regra nova nem escolha de desenho), o agente fá-la diretamente ao abrigo da nossa norma de ficheiros de instruções e depois faz commit e push. Uma regra nova, uma reestruturação ou qualquer coisa que mude o comportamento dos agentes é proposta primeiro e aprovada por uma pessoa. Essa divisão mantém os ficheiros de instruções curtos: encaminham para as normas, nunca as contêm (porque é que um CLAUDE.md longo é um sintoma).
Hooks: as regras que nunca dependem da memória
Algumas regras são importantes demais para viverem num prompt. Os hooks do seu harness de agente correm antes ou depois das chamadas a ferramentas e quando o agente para, por isso impõem uma regra quer o agente se lembre dela, quer não. Três dos hooks que corremos no Claude Code:
| Hook | Quando corre | O que impõe |
|---|---|---|
| Bloqueio de comandos destrutivos | Antes de cada comando de shell | A eliminação é bloqueada antes de correr, e os ficheiros são arquivados em vez disso (como impedimos eliminações) |
| Verificação de desvio no git | Quando a sessão para | Trabalho sem commit ou sem push impede a sessão de terminar |
| Verificação de memória | Quando a sessão para, a cada 2 turnos do assistente | Ficheiros editados sem nada guardado são assinalados de imediato |
As tarefas registadas alimentam o backlog, onde cada uma é corrigida como tarefa própria. Alimentam a camada 6, que lê os problemas registados ao lado das memórias. E quando a correção é um passo ou uma norma, alimentam as camadas 3 e 4.
O que correu mal. Um ciclo de normas de verificar, corrigir e voltar a verificar continuava a encontrar problemas LOW novos, ronda após ronda, até uma pessoa o parar, enquanto a tarefa real esperava. A regra: os problemas HIGH e MEDIUM são corrigidos uma vez, sem nova revisão. Um problema LOW é corrigido no momento quando é de uma linha e, caso contrário, é registado como tarefa. Na Copperfern, o mesmo ciclo teria deixado a correção da data de entrega à espera por causa da redação de um comentário; com a regra, a redação vai para uma tarefa e a correção segue para merge.
Camada 6: o pipeline de memória que revê o sistema inteiro
Cada camada abaixo vê um trabalho. Esta vê todos, e é aí que aparecem os padrões que nenhum trabalho sozinho consegue ver.
O pipeline de memória lê todas as categorias de memória, todas as decisões e todos os problemas registados em todos os espaços de trabalho. Funde o que se repete, mantém o registo central honesto e sugere melhorias ao sistema inteiro: normas, fluxos de trabalho, definições de agentes e ficheiros de instruções.
A mecânica:
- A consolidação corre
memory_consolidatetodos os meses em cada categoria ativa: primeiro uma simulação, para que uma pessoa possa ler o que vai ser fundido, depois a fusão das memórias com semelhança de 0,85 ou mais. Esse limiar funde os quase duplicados e mantém separadas as lições distintas. - As cadeias de substituição trocam uma memória antiga pela sua versão mais recente, em vez de manterem as duas.
- O
expires_atremove o contexto com prazo quando deixa de ser verdade. - A manutenção do registo central promove os candidatos
failure-patterna entradas do registo central, nunca a meio de uma revisão, e passa para Retired as entradas com 5 planos consecutivos sem falhas.
Cada sugestão vai para onde pertence, com quem a aprova:
| Sugestão | Fica como | Quem aprova |
|---|---|---|
| Um candidato a padrão de falha | Uma entrada do registo central | Promovido na consolidação |
| Uma entrada do registo central que nunca dispara | Uma entrada em Retired | Movida na consolidação pela regra do registo central |
| Uma pequena correção a um ficheiro de instruções, norma ou protocolo | Uma edição direta | O agente, ao abrigo da norma de ficheiros de instruções |
| Uma regra nova ou uma reestruturação | Uma proposta | Uma pessoa |
| Uma alteração a um fluxo de trabalho | Uma edição da camada 3 | Uma pessoa |
| Uma linha para a definição de um agente | Uma proposta | Uma pessoa |
A consolidação da Copperfern lê corrections e gotchas dos espaços do site e do apoio ao cliente. Encontra três correções sobre datas e fusos horários, funde-as e promove a entrada FL-P1 do registo central. Propõe também uma linha para a definição do agente de implementação, «Nunca mostrar uma data sem o fuso horário do cliente», e a Maya aprova-a.
O que correu mal. As duas falhas da camada 1, a categoria para tudo e a inundação de notas de acompanhamento, apareceram primeiro aqui, como recuperação que devolvia ruído. Vista de um só trabalho, esse ruído parece azar; no armazém inteiro, é um padrão com uma causa, e só esta camada vê o armazém inteiro.
Agentes de IA que aprendem com os erros: uma lição a subir seis camadas
Os agentes de IA que aprendem com os erros fazem-no ao escrever a lição em mais do que um sítio. Eis uma lição da Copperfern, de um merge rejeitado até a tarefa seguinte passar. A tarefa é «Mostrar a data de entrega nas páginas de produto», no fluxo de trabalho Development Task (MR flow).

- Gatilho. No ponto de aprovação Merge, a Maya rejeita com uma nota BLOCKER: «Os clientes espanhóis veem a data de amanhã como a de hoje.»
- Camada 1, memória. A nota BLOCKER é captada automaticamente como memória
corrections: «As datas de entrega eram mostradas na hora do servidor; mostrar o fuso horário do cliente.» - Camada 2, Learning Capture. A tarefa corrigida termina a guardar a armadilha «O fuso horário do servidor passa para as datas de entrega; testar em Europe/Madrid», mais uma rota para o módulo de formatação de datas.
- Camada 3, edição ao fluxo de trabalho. O passo Implement ganha «Correr cada teste de datas em UTC e em Europe/Madrid».
- Camada 4, passos de lacunas. O Standards Check? diz que sim. O Assess encontra uma classe: qualquer data mostrada a um cliente pode trazer a hora do servidor. A decisão fica registada, e o
dates-and-times.mdv1.2 recebe a regra «Guardar em UTC; mostrar no fuso horário do cliente; cada teste de datas corre em dois fusos horários», relida depois de escrita. O Terminal Gap Check guardou o candidatofailure-pattern. - Camada 5, registado. «O email da encomenda ignora o fuso horário do cliente» é registado, com a etiqueta
discovered-during-execution. - Camada 6, pipeline. A consolidação funde três correções sobre fusos horários do site e do apoio ao cliente, promove a
FL-P1e propõe «Nunca mostrar uma data sem o fuso horário do cliente» para o agente de implementação. A Maya aprova a linha. - Tarefa seguinte. Começa «Mostrar os horários de recolha». O primeiro passo recupera a decisão sobre UTC. O Discover Standards & Flag Gaps inclui o
dates-and-times.mdna lista. O Check Standards Compliance passa. A revisão do plano a que pertence verifica aFL-P1: PASS. A Maya aprova no Merge.
A tarefa seguinte passa porque seis camadas escreveram a lição em seis sítios, não porque o modelo mudou. Se a recuperação falhar a memória, a linha do passo está lá. Se um agente novo saltar o passo, a norma está na sua lista bloqueada. Se o plano se desviar, o registo central apanha-o.
Como fica a autonomia depois das camadas
A autonomia não é um parâmetro que se aumenta. É o que sobra quando as camadas de baixo tornaram previsível a decisão de um ponto de aprovação. Um ponto de aprovação passa da assinatura de uma pessoa para uma verificação registada só quando isso é verdade, e a decisão continua registada para que uma pessoa a possa ler (como lemos as decisões dos agentes).

| Passou da assinatura de uma pessoa para uma verificação registada | Nunca muda |
|---|---|
| Standards Judgment sobre uma lacuna de classe: o agente decide e regista uma atividade que uma pessoa lê | O ponto de aprovação Merge para código: pipeline verde e aprovação de uma pessoa |
| Conformidade com as normas: HIGH e MEDIUM corrigidos uma vez com as provas de quem corrigiu, sem segunda revisão | Publicar um guia |
| Rondas de revisão: uma revisão que falha vai para um passo de correção e, ao fim de 2 rondas, para um bug | Force-push, reescrita do histórico e tags públicas de release |
| Pontos de aprovação pré-aprovados para uma execução quando uma pessoa diz «go autonomous» (avançar em autonomia) | Eliminação de ficheiros: bloqueada por um hook, com os ficheiros arquivados em vez disso |
| Pequenas correções em páginas publicadas, voltadas a verificar no site publicado, com tudo o resto à espera de uma pessoa (o ciclo de autorreparação) | Regras novas e reestruturações de ficheiros de instruções e protocolos |
O Standards Judgment é o caso mais claro. Antes esperava por uma pessoa. O teste de classe no Assess, as normas que lê e a releitura no Apply tornaram o seu resultado previsível o suficiente para que uma decisão registada substitua agora a assinatura. A atividade da Copperfern diz «Standards judgment: applied dates-and-times.md, shopper time zone» (norma aplicada a dates-and-times.md, fuso horário do cliente), e a Maya lê-a quando quiser. O merge continua à espera dela.
A coluna da direita é uma escolha de desenho, não uma falta de maturidade. Essas ações são irreversíveis ou públicas, e uma decisão registada a posteriori não as consegue desfazer. Onde uma pessoa fica no ciclo, é porque o risco está lá (construir sistemas de IA com uma pessoa no ciclo).
O que corre mal quando constrói agentes de IA que se melhoram a si próprios
Cada regra deste sistema veio de uma falha que tivemos. Aqui estão todas num só sítio, com a camada que cada uma mudou.
| Falha | Regra que produziu | Camada |
|---|---|---|
| Uma categoria de memória para tudo; a recuperação devolvia ruído | Categorias específicas; learnings descontinuada para memórias novas | 1, 6 |
| As notas de acompanhamento das tarefas eram mais numerosas do que o conhecimento deliberado na recuperação | As notas de acompanhamento ficam na sua tarefa, fora da recuperação entre tarefas | 1, 6 |
| Sessões editavam ficheiros e não guardavam nada | Um hook Stop assinala de imediato edições sem memória | 2, 5 |
| Guias publicados só em inglês | Tradução como passo do fluxo de trabalho, com um juiz | 3 |
| Revisões em ciclo sem convergir | Registo central de falhas, passos de correção, um bug ao fim de 2 rondas | 3, 4 |
| Um ciclo de normas continuava a encontrar problemas LOW novos | HIGH e MEDIUM corrigidos uma vez; LOW no momento ou registado | 5 |
| Um briefing planeava uma imagem para cada parágrafo | Um orçamento de imagens na norma dos guias | 4 |
A última linha mostra o mesmo ciclo a funcionar com conteúdo, não com código. O briefing de um guia planeava muito mais imagens do que qualquer leitor precisa, e nenhuma regra definia um teto. Uma pessoa rejeitou-o no ponto de aprovação Brief (briefing) e, como todos os briefings planeiam imagens, a correção foi para a norma e não para aquele briefing: a norma dos guias ganhou um orçamento de imagens de, no máximo, 8 imagens para um guia de ciclo e 6 para qualquer outro guia, incluindo a imagem principal. Na Copperfern, a mesma regra teria cortado o briefing de um guia de compras que planeava uma imagem para cada parágrafo e teria deixado só as poucas que explicam algo que o texto não consegue.
O padrão por trás de cada linha é o mesmo. A falha aconteceu uma vez, alguém escreveu a regra na camada que a teria apanhado, e o trabalho seguinte leu a regra em vez de redescobrir a falha. O nosso ciclo de experiências de SEO ganhou as suas regras da mesma forma.
Construa o seu próprio sistema operativo de IA, uma camada de cada vez
Não precisa das seis camadas no primeiro dia. As camadas 1 e 2 vêm primeiro, porque todas as camadas de cima leem o que elas escrevem. Acrescente os passos de deteção de lacunas quando tiver normas que valha a pena verificar, e o pipeline quando o seu armazém tiver memórias suficientes para se repetir.
Os seis passos abaixo seguem as camadas por ordem. Cada um funciona com qualquer harness de agente; o ConvOps é o exemplo, porque é onde corremos os nossos. Crie uma conta gratuita no ConvOps(abre num novo separador) e ligue o seu agente(abre num novo separador) para acompanhar.
Passos
Dê memória a cada trabalho
Ponha um passo de recuperação no início de cada fluxo de trabalho e guarde memórias com tipo enquanto o trabalho corre: decisões, correções, armadilhas, procedimentos. Decida o que cada categoria alimenta. Ative a captura automática de decisões, progresso e correções, que fica desligada até a ativar no seu espaço de trabalho.
Faça do Learning Capture (captura de aprendizagens) o último passo
Acrescente a cada fluxo de trabalho um último passo global que guarda decisões, armadilhas e padrões e regista onde fica o código novo. Deixe-o saltar com «no learnings to store» (sem aprendizagens a guardar) quando uma execução não ensinou nada de novo.
Edite o fluxo de trabalho, não o prompt
Transforme cada lição repetida numa linha no passo que precisava dela, ou num passo novo. Faça uma edição cirúrgica de cada vez, valide-a, leia-a de volta e guarde o motivo numa memória, não no passo.
Acrescente passos que encontram lacunas
Descubra as normas que regem o trabalho antes de o fazer e assinale lacunas, verifique a conformidade depois e corra uma verificação final de lacunas que guarda candidatos a padrões de falha. Avalie cada correção como classe ou caso isolado, e mantenha um registo central de falhas com incidentes reais, limitado a 15 entradas por secção, para as revisões de planos.
Registe o atrito no momento em que aparece
Quando algo não sai à primeira, avise uma pessoa, procure uma tarefa existente e registe uma com a etiqueta discovered-during-execution; depois termine a tarefa em que está. Passe as regras que nunca podem falhar, como bloquear a eliminação de ficheiros, para os hooks do harness do seu agente.
Corra o pipeline de memória e mude um ponto de aprovação
Consolide as memórias todos os meses, por categoria, com uma simulação primeiro, promova os candidatos ao registo central, retire as entradas que nunca disparam e proponha alterações a normas, fluxos de trabalho, agentes e ficheiros de instruções. Depois entregue um ponto de aprovação previsível a uma decisão registada do agente, e mantenha os merges e a publicação com uma pessoa. Crie uma conta gratuita no ConvOps em https://my.convops.app/register e ligue o seu agente em https://convops.app/connect. Quer construí-lo com a sua equipa? Marque uma sessão de descoberta gratuita em https://neomanex.com/pt/services.
Perguntas frequentes
O que é um sistema de IA que se melhora a si próprio?
Um sistema de IA que se melhora a si próprio é um repositório de normas, um armazém de memória e fluxos de trabalho com pontos de aprovação que transformam as lições de cada trabalho concluído em regras que o trabalho seguinte lê. O ConvOps guarda os fluxos de trabalho, os pontos de aprovação e o armazém de memória em que corremos o nosso. Aprende em seis camadas, da memória recuperada antes de cada trabalho a um pipeline que revê o sistema inteiro. O modelo nunca muda; mudam os ficheiros, os passos e as memórias à volta dele.
Para quem é um sistema de IA que se melhora a si próprio?
Um sistema de IA que se melhora a si próprio é para líderes de engenharia, engenheiros de plataforma e de operações e fundadores técnicos que põem agentes de IA a fazer trabalho recorrente em desenvolvimento, conteúdo ou operações. O ConvOps corre esse trabalho como tarefas em fluxos de trabalho com pontos de aprovação, por isso um erro repetido passa a regra escrita, com a indicação de quem a aprovou, e o trabalho seguinte lê essa regra antes de começar.
É possível uma IA que se melhora a si própria sem retreinar o modelo?
Sim. No ConvOps as lições ficam como memórias com tipo, passos de fluxo de trabalho e normas escritas, e os pesos do modelo nunca são tocados, por isso cada lição continua legível e reversível. O sistema não edita o modelo nem as suas próprias salvaguardas: uma pessoa aprova os merges, a publicação, as regras novas e as reestruturações de ficheiros de instruções, e um hook bloqueia a eliminação de ficheiros.
Como construo um sistema de IA que se melhora a si próprio?
Crie uma conta gratuita no ConvOps em my.convops.app/register e ligue o agente que já usa. Depois ponha um passo de recuperação no início e um passo Learning Capture (captura de aprendizagens) no fim de um fluxo de trabalho, e ative a captura automática de decisões e correções. Acrescente passos que verificam o trabalho face às suas normas, registe o atrito como tarefas no momento em que aparece e corra uma consolidação mensal sobre as suas memórias.
Como se impede que as regras e as memórias cresçam sem limite?
O ConvOps guarda as memórias em categorias específicas, substitui as repetições quando são guardadas e funde os quase duplicados numa consolidação mensal com semelhança de 0,85. As notas de acompanhamento das tarefas ficam fora da recuperação entre tarefas. Uma norma só ganha uma regra para uma classe de erros, nunca para um caso isolado. O registo central de falhas tem no máximo 15 entradas por secção, e uma entrada que só devolve PASS (passa) ou N/A (não aplicável) em 5 planos consecutivos é retirada.
Quem aprova uma alteração às regras?
No ConvOps depende da camada. Os agentes guardam memórias sem aprovação. Uma lacuna de classe nas normas é avaliada pelo agente e registada como atividade que uma pessoa pode ler. As pequenas edições a ficheiros de instruções e normas, como uma linha ou um valor desatualizado, entram diretamente ao abrigo de uma norma. As regras novas, as reestruturações e as alterações a fluxos de trabalho precisam de uma pessoa, e os merges e a publicação esperam sempre por uma.
Em que é que um sistema de IA que se melhora a si próprio difere de um ficheiro de aprendizagens?
Um ficheiro de aprendizagens é um saco onde cabe tudo e que cresce sem limite, e foi por isso que descontinuámos a nossa própria categoria de memória learnings para memórias novas. No ConvOps cada lição tem tipo e fica na camada que a usa: uma decisão recuperada, um passo de fluxo de trabalho, uma norma ou uma entrada do registo central de falhas. Tem limite e é consolidado, e a recuperação devolve só as memórias que correspondem ao trabalho.