Ce que vous saurez faire
- Rédiger des critères d'acceptation observables et les figer avant le début de la construction.
- Transformer chaque critère en un parcours avec ses préconditions et des étapes observables.
- Préparer et prouver l'environnement de test dans une étape distincte, avant l'arrivée du testeur.
- Dérouler les parcours avec Playwright MCP et lire le rapport à travers ses verdicts.
- Mettre en place une boucle de correction et de nouveau passage où personne ne certifie sa propre correction.
Points clés
- Dans le test d'acceptation piloté par agent, un agent IA déroule chaque parcours utilisateur sur l'application en cours d'exécution et rend un verdict pour chaque critère d'acceptation figé.
- Figez les critères avant que le code n'existe et donnez à chacun exactement un parcours qui le cite mot pour mot.
- L'agent qui teste ne corrige jamais : un échec repart vers la construction, et seul un nouveau passage complet fait office de preuve.
- BLOCKED est un verdict, pas un trou à cacher ; lisez-le avant FAIL.
- Cette couche ne remplace pas la CI ; elle détecte les défauts qui se logent entre des couches qui passaient chacune de leur côté.
Ce que font ici les tests d'acceptation avec Playwright MCP
Le test d'acceptation piloté par agent est une boucle de vérification dans laquelle un agent IA déroule chaque parcours utilisateur dans un vrai navigateur et rend un verdict de réussite ou d'échec au regard de critères d'acceptation figés. Les parcours API et MCP suivent le même principe, sous forme de vrais appels à l'application en cours d'exécution.
Un test que le développeur écrit pour lui-même ne prouve rien. Nous voulons le verdict d'un agent qui ne lit que les critères et qui pilote le produit. Une fois que Claude Code a construit une fonctionnalité, un second agent parcourt chaque parcours avec Playwright MCP et fait une capture d'écran de chaque observation décisive. ConvOps exécute les étapes, les points de validation et la boucle de correction. C'est l'une des boucles sur lesquelles tourne notre entreprise.
Tous les exemples utilisent Quillbay, une application fictive de réservation de cours pour ateliers de poterie, et sa nouvelle liste d'attente pour les cours complets.
| Ce n'est pas | Pourquoi |
|---|---|
| De la recette utilisateur (UAT) | Là, ce sont les métiers qui valident ; ici, un agent vérifie des critères déjà approuvés |
| Le test d'un agent IA | L'agent est le testeur, pas l'objet du test |
| Des critères transformés en code de test | Cela aboutit à un fichier .spec.ts. Ici, on aboutit à un verdict par parcours, preuves à l'appui |
| Élément | Ce que c'est |
|---|---|
| Déclencheur | La fin des étapes de construction d'un plan. Aucune planification horaire |
| Entrées | Les critères d'acceptation figés, le plan de parcours, l'application qui tourne dans son propre environnement de branche |
| Sorties | Un rapport avec un verdict par parcours, des captures d'écran et une recommandation : PROCEED ou FIX REQUIRED |
Pourquoi nous l'avons construit : des couches au vert, des parcours cassés
Des tests unitaires au vert vous disent que les pièces fonctionnent. Ils ne disent rien sur la capacité d'une personne à aller au bout de sa tâche à l'écran.
Avant cette boucle, toutes les couches inférieures passaient : tests unitaires, revues de phase, suite de régression dans le pipeline de merge. Puis le premier passage piloté par agent des parcours sur la vraie application en a quand même fait échouer une bonne partie. Les défauts se logeaient entre les couches : un lien construit par un service et lu par un autre, une redirection qui perdait un paramètre. Aucune couche n'était responsable de la jonction, donc aucune ne l'a détectée.
Nous en avons tiré deux convictions. Celui qui construit ne peut pas être juge : le testeur n'écrit donc jamais de code et n'en corrige jamais. Et seul un passage sur la vraie application prouve un critère.
Si les fonctionnalités de vos agents passent tous les contrôles et cassent quand même à l'écran, découvrez comment ConvOps mène un plan des critères figés jusqu'à une construction vérifiée(s’ouvre dans un nouvel onglet).
Comment ça tourne : six étapes et quatre agents
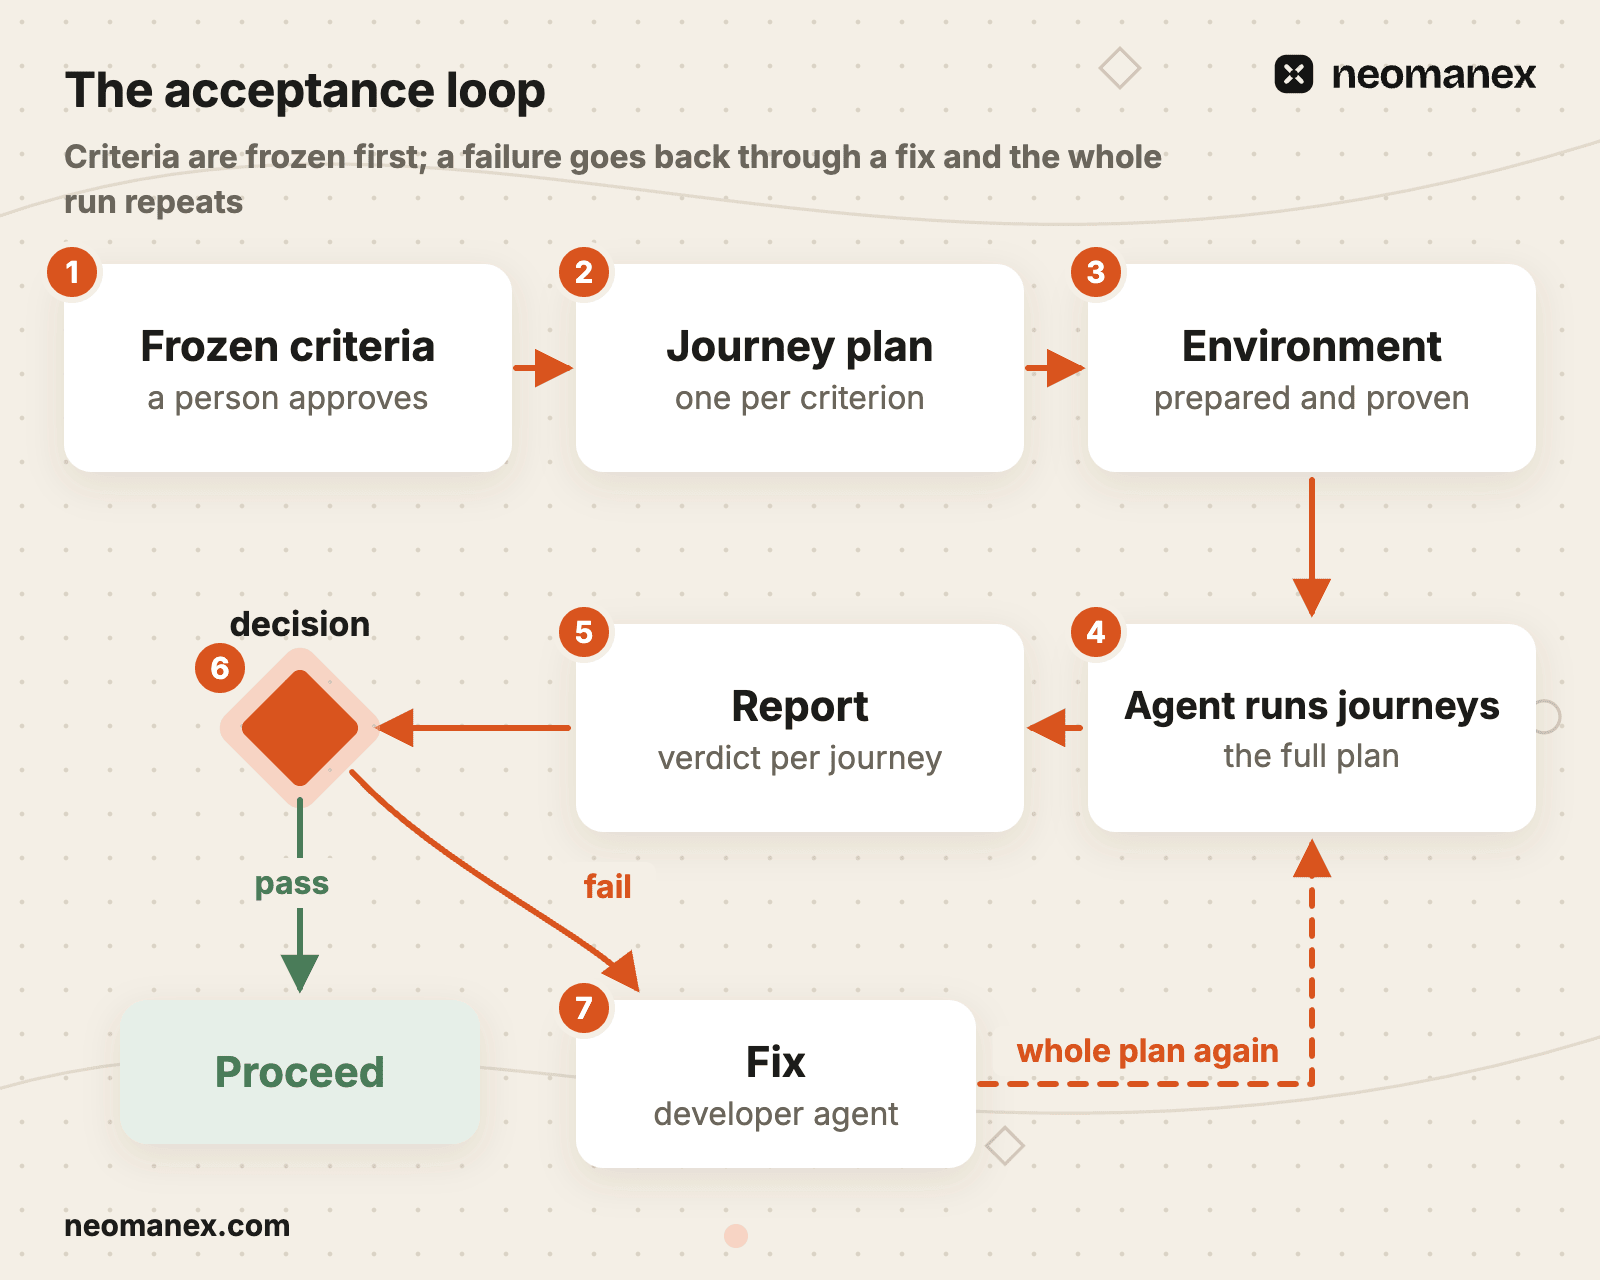
C'est l'ordre des étapes qui fait la sécurité. Les critères sont figés avant que le code n'existe, l'environnement est prouvé avant l'arrivée du testeur, et la décision est prise par quelqu'un qui n'a pas écrit la correction.
| # | Étape | Qui l'exécute | Point de validation |
|---|---|---|---|
| 1 | Rédiger les critères | Rédigés avec le plan, approuvés par une personne | L'approbation fige la liste |
| 2 | Planifier les parcours | Planificateur de tests | Aucun |
| 3 | Préparer l'environnement | Agent d'infrastructure | Uniquement au vert, puis une personne approuve |
| 4 | Dérouler les parcours | Testeur d'acceptation | Une personne approuve le rapport |
| 5 | Décider | Étape de décision | Réussite, ou échec qui part en correction |
| 6 | Corriger les échecs | Agent développeur | Aucun |
Claude Code construit la fonctionnalité entre les étapes 2 et 3.
Rédiger les critères. Chacun nomme un acteur, un comportement et quelque chose d'observable : un écran, un message, une réponse. « Le code existe » n'est jamais un critère, car ce que l'on ne peut pas observer ne peut pas être accepté. L'approbation fige la liste : les étapes suivantes n'en ajoutent, n'en retirent et n'en réinterprètent jamais aucun.
Planifier les parcours. Un parcours par critère, cité mot pour mot avec son identifiant, pour que chaque critère ait exactement un endroit où il est prouvé.
Préparer l'environnement. Un agent d'infrastructure dédié démarre l'environnement de branche propre au plan, fournit les données et les identifiants selon le mécanisme du plan, et les consigne. Le point de validation porte sur le vert, pas sur l'effort fourni. Le testeur ne prépare rien : il ne peut donc pas réussir en se fabriquant un cas facile.
Dérouler, décider, corriger. Le testeur d'acceptation déroule les parcours et ne corrige jamais rien. Un échec envoie le rapport à l'agent développeur, qui commite les corrections sur la même branche, puis tout le plan est rejoué.
La boucle n'a pas de minuterie : elle tourne après la construction de chaque plan et, sur une tâche, chaque fois qu'un parcours a changé. Un passage au niveau d'une tâche en tire 3 à 8 parcours : le chemin nominal plus le chemin d'erreur le plus risqué pour chaque comportement modifié. On ne peut s'en passer que s'il n'y a aucun parcours à dérouler (refactorisation pure, outillage, documentation, configuration ou modifications limitées aux tests), en indiquant le motif. Dans le doute, on lance le passage.
Les Playwright Test Agents(s’ouvre dans un nouvel onglet) de Microsoft (planner, generator, healer) produisent et réparent du code de test. Les nôtres produisent un plan à partir d'exigences figées et un rapport de verdicts. Les points de validation fonctionnent comme dans comment nous construisons un système d'IA auto-améliorant, et les approbations sont des points de validation humains.

Un passage, étape par étape : la liste d'attente de Quillbay
Le moment intéressant n'est pas le premier FAIL. C'est le nouveau passage après la correction, car l'étape de décision n'accepte aucune autre preuve.
Déclencheur. Les étapes de construction de plan/waitlist se terminent. Les critères FR-1 à FR-4 ont été figés avant qu'une seule ligne de code n'existe.
Le plan. Le parcours U2 cite FR-2 mot pour mot : « Quand une place se libère, le premier élève de la file reçoit un e-mail dont le lien ouvre le cours avec la place réservée pendant 2 heures. » Chaque précondition indique comment la vérifier : le cours acc-wl-r7-class-wheel-basics est complet à 8 sur 8 (la page affiche « Full » (complet) et le bouton Join waitlist (rejoindre la liste d'attente)), les deux élèves peuvent se connecter, et les e-mails sortants arrivent dans la boîte de capture.

Préparation. L'agent d'infrastructure prouve que wl-waitlist.app.quillbay.example.com et son API sont au vert, puis consigne les jeux de données des élèves et la clé du gérant de l'atelier pour qu'ils soient réutilisés.
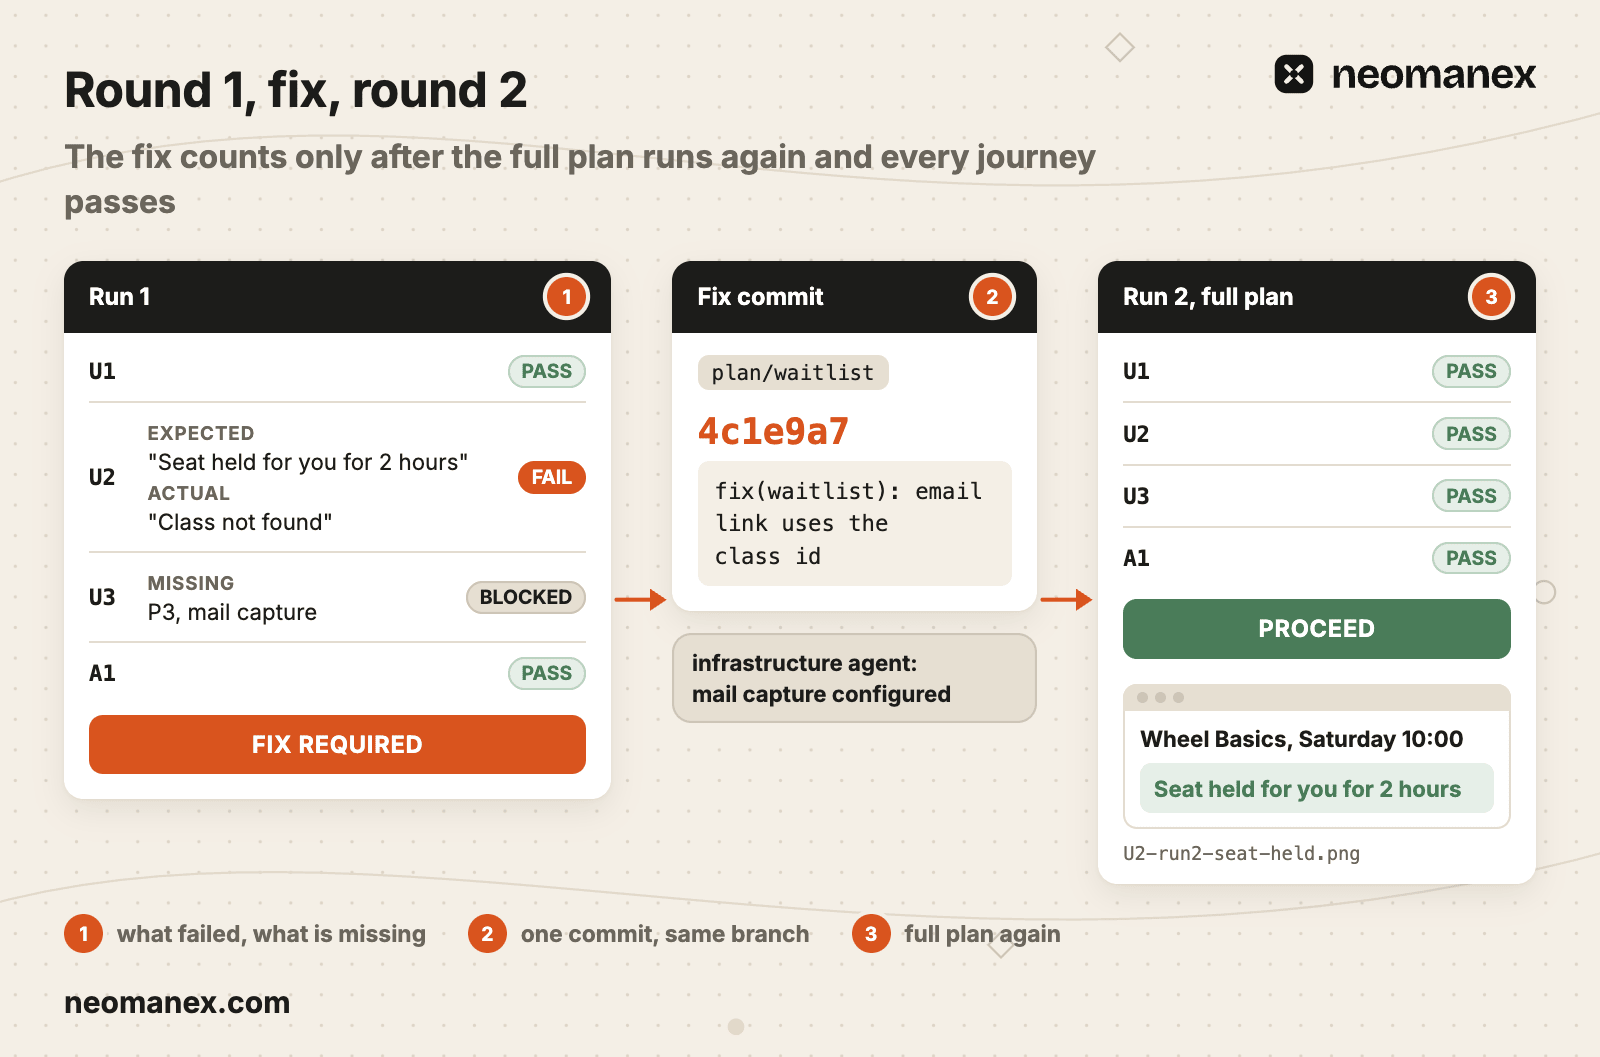
Passage 1. Le testeur d'acceptation déroule quatre parcours en 1440x900 et revérifie en 390x844 les écrans qui dépendent de la mise en page.
| Parcours | Verdict | Ce qu'il a observé |
|---|---|---|
| U1 | PASS | « You are #1 on the waitlist » (vous êtes n° 1 sur la liste d'attente) |
| U2 | FAIL | Le lien de l'e-mail ouvre « Class not found » (cours introuvable) : il transporte l'identifiant de l'inscription en liste d'attente, pas celui du cours |
| U3 | BLOCKED | P3 manquante : aucune capture des e-mails dans l'environnement de branche, ce que l'en-tête indique |
| A1 | PASS | GET /v1/classes/{id}/waitlist appelé en tant que gérant renvoie 200 avec l'élève A en position 1 |
Recommandation : FIX REQUIRED. U2 est une jonction : l'API et l'application passent chacune leurs tests unitaires, et seul le parcours traverse les deux.
Décision. Une personne approuve le rapport, et la décision est un échec. U2 relève du code livré par ce plan : il est donc corrigé sur la branche, pas consigné dans un ticket.
Correction. L'agent développeur reproduit U2 sur le même environnement, modifie le lien, exécute le test unitaire du fichier touché et commite fix(waitlist): email link uses the class id (4c1e9a7) sur plan/waitlist. L'agent d'infrastructure configure la capture des e-mails.
Passage 2. Tout le plan est rejoué : les quatre parcours, pas seulement U2 et U3. Tous réussissent, et la capture d'écran de U2 affiche « Seat held for you for 2 hours » (place réservée pour vous pendant 2 heures). Recommandation : PROCEED. La décision est une réussite, et le rapport alimente la section de vérification de la merge request.
À quoi ressemble le rapport, et comment le lire
Lisez BLOCKED avant FAIL. Un parcours que personne n'a pu dérouler est celui qui a le plus de chances de cacher un vrai défaut.
| Partie | Contenu |
|---|---|
| En-tête | Passage, passage précédent avec ses décomptes, branche et commit de tête, hôtes, résolutions d'écran, verdict |
| Mentions obligatoires de l'en-tête | Tout ce que le passage n'a pas pu tester, chaque point nommé. Passage 1 : « P3 capture des e-mails non configurée : U2 et U3 en dépendent » |
| Résultats des parcours | Une ligne par parcours, passage précédent à côté du passage actuel, images de preuve |
| Échecs en détail | Étape, résultat attendu, résultat obtenu, preuve, correction recommandée |
| Liste de contrôle de non-régression | Réserver un cours non complet fonctionne toujours. Annuler une réservation libère toujours la place |
| Recommandation | PROCEED ou FIX REQUIRED |
| Verdict | Signification |
|---|---|
| PASS | Chaque étape observée telle que le critère l'énonce |
| PARTIAL PASS | Le parcours fonctionne, mais une observation énoncée ne se vérifie pas entièrement |
| FAIL | Le résultat obtenu à une étape diffère du résultat attendu |
| BLOCKED | Le parcours n'a pas pu être déroulé ; l'élément manquant est nommé |
| COVERED BY SUITE | Prouvé par un test de régression automatisé que le rapport cite, sans être rejoué |
Nos plans posent une règle de plus : une étape qui a eu besoin d'un prérequis non documenté, d'une nouvelle tentative ou d'un rattrapage manuel est un FAIL, même si le comportement a fini par fonctionner. Une réussite qui a eu besoin d'aide ne réussira pas pour un utilisateur. Et un PASS dont la capture d'écran ne montre pas l'élément vérifié ne constitue pas une preuve : la personne qui accepte le verdict ouvre les images.

Ce qui tourne mal : des jonctions dont aucune couche n'était responsable
La plupart de nos échecs d'acceptation n'étaient pas des bugs que le modèle avait ratés. C'étaient des jonctions entre couches dont aucune couche n'était responsable.
Le principal a la forme du U2 de Quillbay : un premier passage d'acceptation fait échouer une bonne partie des parcours alors que toutes les couches inférieures sont au vert, et chaque défaut se situe entre deux couches. La règle qui en est née : lancer l'acceptation sur un vrai environnement avant que les étapes de revue ne deviennent coûteuses, et prévoir un second passage complet pour tout plan qui touche à l'interface, à l'API et à MCP.

| Échec | La règle qui en est née |
|---|---|
| Des cycles de correction ont introduit des régressions que le passage suivant a détectées. Chez Quillbay, une correction de U2 qui ferait aussi un peu de ménage sur la page du cours casserait U1 | Ne corriger que les échecs signalés, sans ménage annexe. Le passage complet suivant détecte ce qu'une correction a cassé, et une personne décide quand arrêter la boucle |
| Deux sessions partageaient un même navigateur Playwright MCP. Une session voisine a changé de page dans l'onglet en plein parcours et l'état observé a disparu | Chaque session pilote son propre contexte de navigateur ou un script Playwright autonome, retrouve sa page à chaque appel et vérifie l'URL avant de lire |
| Un parcours réussissait sur le serveur de développement et affichait un contenu périmé une fois l'application construite | Les parcours qui dépendent du prérendu ou du mode cache tournent sur une image construite ou un environnement déployé : un serveur de développement rend chaque requête à neuf |
| Une configuration manquante a laissé un parcours BLOCKED pendant plusieurs passages, ce qui masquait un autre défaut derrière lui | BLOCKED est un verdict qui nomme l'élément manquant dans l'en-tête. Le passage ne simule jamais une réussite |
| Un plan contenait des contrôles que l'environnement ne pourrait jamais satisfaire : une règle déjà enfreinte sur main, une connexion dont l'environnement ne disposait pas | Le planificateur de tests confronte chaque parcours à ce que l'environnement peut réellement faire |
Séparer la détection et la correction en deux tâches distinctes est aussi la colonne vertébrale de notre boucle de site web autoréparateur.
Construire le vôtre : les instructions que reçoit chaque agent
Commencez par les critères et par la règle « ne jamais corriger ». Playwright MCP est la partie facile. Le testeur sert à vérifier, pas à enquêter : déboguez d'abord, puis lancez l'acceptation une fois que vous pensez que la construction fonctionne. Les étapes ci-dessous donnent l'ordre ; voici les instructions, prêtes à copier.
Planificateur de tests : le modèle de parcours.
Pour chaque critère figé, rédigez UN parcours :
  ID : U<n> (UI) ou A<n> (API/MCP)
  Critère : <id FR>, cité mot pour mot
  Préconditions : chacune avec « Comment vérifier ».
    Une précondition manquante bloque, on ne la contourne pas.
  Étapes : numérotées ; chacune indique ce que vous observerez.
  Résolutions : 1440x900 ; revérifiez en 390x844 chaque
    écran qui dépend de la mise en page.
  Jeux de données : préfixe acc-<plan>-<run>- ; nettoyage après le passage.
Confrontez chaque parcours à ce que l'environnement
peut réellement faire.
Agent d'infrastructure : préparer et vérifier.
Préparez l'environnement de branche du plan, puis prouvez qu'il est au vert.
1. Démarrez chaque service que le plan touche. Tous doivent tourner.
2. Fournissez données et identifiants UNIQUEMENT selon le mécanisme
   du plan. Pas de mécanisme : arrêtez-vous et demandez. Consignez
   les identifiants pour le testeur.
3. Vérifiez :
   - le health check renvoie 200
   - un VRAI endpoint de données renvoie 2xx, pas seulement le health check
   - appel sans authentification : 401/403 ; avec authentification : 2xx
     (MCP : tools/list ET un appel d'outil authentifié)
   - 3 à 5 pages clés via Playwright : aucune erreur console,
     aucune requête en échec, aucun écran blanc
   - le flux principal fonctionne une fois de bout en bout
4. Corrigez ce qui est rouge, revérifiez, n'avancez que sur du vert.
   Signalez les défauts produit avec leur emplacement et leurs preuves.
Ne déroulez pas les parcours. Ne démontez rien.
Testeur d'acceptation : dérouler et rendre compte.
L'environnement est préparé et tourne. Réutilisez les identifiants
consignés. Ne démarrez et ne démontez rien.
Déroulez chaque parcours UI avec Playwright MCP, chaque parcours
API/MCP avec de vrais appels, puis la liste de contrôle de non-régression.
Suivez le plan dans l'ordre. Ne corrigez jamais le code. Ne passez
jamais un échec sous silence. Aucun test improvisé.
Faites une capture d'écran de chaque observation qui tranche une étape.
Consignez le corps des réponses API.
Verdict par parcours : PASS, PARTIAL PASS, FAIL, BLOCKED,
COVERED BY SUITE.
Rapport : en-tête ; mentions obligatoires de l'en-tête (ce que vous
n'avez pas pu tester, chaque point nommé) ; résultats des parcours ;
échecs en détail (étape, attendu, obtenu, preuve, correction
recommandée) ; liste de contrôle de non-régression ; recommandation :
PROCEED ou FIX REQUIRED.
Règle de décision.
Réussite uniquement si chaque parcours est PASS ou une exception
acceptée : un échec dans du code que cette modification n'a pas livré,
suivi dans son propre ticket et cité par son identifiant.
Tout le reste est un échec : envoyez le rapport en correction, puis
rejouez le plan ENTIER.
Un échec dans du code que cette modification a livré se corrige sur
la branche, jamais dans un ticket séparé.
Pas sûr qu'un comportement soit voulu ? Une personne tranche.
Agent développeur : corriger.
Pour chaque parcours en échec : reproduisez-le sur le même
environnement, trouvez la cause, corrigez-la, rejouez le
parcours en conditions réelles.
Ne corrigez que ce que les échecs exigent. Pas de retouches cosmétiques, pas de ménage annexe.
Lancez les tests unitaires et le lint uniquement sur les fichiers touchés.
Commitez sur la même branche. Consignez ce qui a changé et pourquoi.
Ne certifiez jamais votre propre correction : le nouveau passage est la preuve.
Cette couche ne remplace pas la CI : les tests unitaires, d'intégration et de régression restent le point de validation déterministe du pipeline de merge.
Étapes
Rédiger des critères observables et les figer
Donnez à chaque critère un acteur, un comportement et quelque chose d'observable à l'écran ou dans une réponse. L'approbation d'une personne fige la liste ; tout changement de périmètre revient à cette étape.
Rédiger un parcours par critère
Citez le critère mot pour mot avec son identifiant, listez les préconditions en indiquant comment vérifier chacune, et énoncez une observation pour chaque étape.
Préparer l'environnement dans une étape à part
Un agent d'infrastructure fournit les données et les identifiants selon le mécanisme du plan, puis prouve que le health check, un vrai endpoint de données, l'authentification dans les deux sens et les pages clés sont au vert avant que quiconque ne teste.
Dérouler les parcours avec un testeur distinct
Donnez au testeur d'acceptation Playwright MCP dans son propre contexte de navigateur, de vrais appels pour les parcours API, et deux règles : ne jamais corriger, ne jamais ignorer un échec.
Lire le rapport et décider
Lisez d'abord les lignes BLOCKED. Ne validez que si chaque parcours est PASS ou une exception acceptée, suivie dans son propre ticket.
Corriger sur la branche, puis tout rejouer
L'agent développeur ne corrige que les échecs signalés et commite sur la même branche. Tout le plan est rejoué ; personne ne certifie sa propre correction.
Questions fréquentes
Qu'est-ce que le test d'acceptation piloté par agent ?
Le test d'acceptation piloté par agent est une boucle de vérification dans laquelle un agent IA déroule chaque parcours utilisateur dans un vrai navigateur et rend un verdict de réussite ou d'échec au regard de critères d'acceptation figés. ConvOps l'exécute sous forme d'étapes de workflow : une personne fige les critères, un planificateur de tests rédige un parcours par critère, un testeur d'acceptation distinct les déroule avec Playwright MCP, et tout échec est corrigé sur la branche avant que le plan entier ne soit rejoué.
À qui s'adresse le test d'acceptation piloté par agent ?
Le test d'acceptation piloté par agent s'adresse aux responsables techniques et aux fondateurs qui livrent des fonctionnalités avec des agents de code comme Claude Code. ConvOps le lance après la construction de chaque plan : chaque critère approuvé par une personne est ainsi prouvé sur l'application en cours d'exécution, avec une capture d'écran par observation décisive, avant la revue de la merge request.
Peut-on utiliser des agents IA pour les tests QA ?
Oui, comme couche des parcours. Dans ConvOps, un agent testeur d'acceptation déroule chaque parcours utilisateur avec Playwright MCP et chaque parcours API avec de vrais appels, puis rend un verdict par parcours, preuves à l'appui. Il ne corrige jamais le code et n'ignore jamais un échec. La suite de régression en CI reste le point de validation déterministe, et une personne lit le rapport avant la décision.
Playwright MCP est-il fiable pour les tests d'acceptation ?
Oui, comme outil d'exécution, à deux conditions. ConvOps prouve que l'environnement est au vert avant l'arrivée du testeur, et chaque session pilote son propre contexte de navigateur, retrouve sa page à chaque appel et vérifie l'URL avant de lire. Un navigateur partagé perd son état quand une autre session change de page dans l'onglet. Chaque observation décisive fait l'objet d'une capture d'écran qui montre l'élément vérifié.
Comment faire tester par un agent de code IA le code qu'il a écrit, dans un vrai navigateur ?
Ajoutez le serveur MCP de ConvOps, https://mcp.convops.app/, à votre client IA et connectez-vous une fois. Rédigez ensuite des critères d'acceptation observables et figez-les, faites rédiger un parcours par critère à un planificateur de tests, et donnez Playwright MCP à un second agent pour les dérouler. Celui qui construit ne note jamais son propre travail : les échecs sont corrigés sur la branche et le plan entier est rejoué.
Le test d'acceptation piloté par agent remplace-t-il la recette utilisateur ?
Non. Dans ConvOps, l'agent vérifie des critères qu'une personne a approuvés avant la construction, et une personne lit et approuve chaque rapport. Un constat dont personne ne sait s'il correspond au comportement voulu remonte à une personne avant la décision de réussite ou d'échec. L'agent tranche sur ce qu'il a observé, jamais sur l'intention.
Les tests d'acceptation menés par un agent IA remplacent-ils les tests de CI ?
Non. Dans les plans ConvOps, les tests unitaires, les tests d'intégration et la suite de régression tournent dans le pipeline de merge et constituent le point de validation déterministe. L'acceptation pilotée par agent est une quatrième couche : elle déroule les parcours sur l'application en cours d'exécution et détecte les défauts qui se logent entre des couches qui passaient chacune de leur côté. Elle ne conditionne pas le merge à elle seule.
Que se passe-t-il quand l'agent ne peut pas tester un parcours ?
Le parcours est BLOCKED, et l'en-tête du rapport nomme l'élément manquant, par exemple une boîte de capture des e-mails dont l'environnement ne disposait pas. ConvOps ne compte jamais BLOCKED comme une réussite. L'agent d'infrastructure fournit ce qui manquait, et le plan entier est rejoué. Lisez d'abord les lignes BLOCKED : un parcours que personne n'a pu dérouler peut cacher un vrai défaut.