
Ce que vous saurez faire
- Organiser les six couches d'apprentissage dans votre propre pile d'agents.
- Typer vos mémoires par catégorie et décider de ce que chaque catégorie alimente.
- Ajouter à un workflow un rappel en premier, Learning Capture en dernier et des étapes de détection des lacunes.
- Mettre en place un registre des échecs plafonné et une passe de consolidation mensuelle.
- Choisir le premier point de validation à confier à une vérification consignée, et ceux qui ne bougent jamais.
Points clés
- Un système d'IA auto-améliorant améliore ses fichiers, ses mémoires et ses étapes de workflow, jamais son modèle : les leçons de chaque travail terminé deviennent des règles que le travail suivant lit.
- Il apprend en six couches, chacune étant une boucle : la mémoire, Learning Capture (capture des apprentissages), les modifications de workflow, les étapes de détection des lacunes, les frictions consignées dès qu'elles apparaissent, et un pipeline qui passe en revue tout le système.
- Les mémoires sont typées par catégorie, et chaque catégorie alimente un endroit différent : les corrections deviennent des règles candidates, les décisions sont rappelées, les procédures deviennent des étapes de workflow.
- Un test « classe ou cas isolé », un registre des échecs plafonné à 15 entrées par section et une consolidation mensuelle gardent les règles assez courtes pour être lues.
- L'autonomie en est le résultat : les points de validation deviennent des vérifications consignées à mesure que les couches les rendent prévisibles, tandis que les fusions, la publication et les actions irréversibles restent entre les mains d'une personne.
Pour construire un système d'IA auto-améliorant, ne touchez pas au modèle et améliorez tout ce qui l'entoure. Un système d'IA auto-améliorant est un dépôt de standards, une base de mémoire et des workflows à points de validation qui transforment les leçons de chaque travail terminé en règles que le travail suivant lit. Les poids du modèle ne changent jamais. Le système apprend en six couches, chacune étant une boucle qui écrit une leçon là où le travail suivant la lit.
Nous faisons tourner les six couches sur ConvOps, où vivent nos tâches, nos workflows, nos points de validation et notre base de mémoire, et nous les faisons évoluer chaque semaine. Ce guide décrit la construction. Il s'adresse aux responsables techniques, aux ingénieurs plateforme et aux fondateurs techniques qui confient un travail récurrent à des agents de code ou de contenu. Pour voir à quoi ressemble une semaine ordinaire, en termes simples, lisez le guide central de cette série, comment nous dirigeons notre entreprise avec des agents IA. Commencez par les couches 1 et 2 sur un workflow que vous exécutez chaque semaine : le reste s'appuie sur ce qu'elles écrivent.
Ici, « auto-améliorant » est à prendre au sens procédural. Il ne s'agit pas d'auto-amélioration récursive, et rien n'est réentraîné. Chaque leçon aboutit dans une mémoire, une étape de workflow ou un standard écrit qu'une personne peut lire, relire et annuler. C'est la force de cette conception : vous voyez exactement ce que le système a appris, où il l'a écrit et qui l'a validé.
Tous les exemples utilisent Copperfern, une boutique en ligne fictive d'articles pour la maison qui vend des ustensiles de cuisine et du linge de table, en anglais et en espagnol, sur copperfern.example.com. Les noms d'étapes, les points de validation, les catégories et les seuils sont les nôtres. L'entreprise, les personnes et toutes les valeurs sont inventées. Maya est la personne qui valide au point de validation Merge (fusion).
Ce que fait un système d'IA auto-améliorant
Un système d'IA auto-améliorant transforme une erreur en règle une seule fois, pour qu'aucun travail ultérieur ne la répète. Il repose sur trois éléments : un dépôt de standards et de fichiers d'instructions que lisent les agents, une base de mémoire que chaque travail interroge en premier et alimente au fil de l'eau, et des workflows à points de validation qui fixent ce qui s'exécute, dans quel ordre, et où une personne valide.
Sur ces trois éléments reposent six couches d'apprentissage, de la plus simple à la plus avancée. Chaque couche est une boucle : quelque chose se produit pendant un travail, une leçon est écrite quelque part, et un travail ultérieur la lit à cet endroit.

| Couche | La boucle | Ce qu'elle écrit | Où le travail suivant la lit | Qui valide |
|---|---|---|---|---|
| 1 Mémoire | Rappeler avant le travail, enregistrer pendant et après | Une mémoire typée : une décision, une correction, un piège | La première étape de chaque travail lié | Personne : enregistrer est la règle par défaut |
| 2 Learning Capture (capture des apprentissages) | La dernière étape de chaque workflow enregistre ce que l'exécution a appris | Des mémoires et des routes | Le rappel, et toutes les couches supérieures | Personne : l'agent décide de ce qui mérite d'être gardé |
| 3 Modifications du workflow | Une leçon répétée devient une ligne dans une étape, ou une nouvelle étape | Le workflow lui-même | Chaque exécution de ce workflow, sans rappel nécessaire | Une personne valide la modification |
| 4 Étapes de détection des lacunes | Des étapes du workflow vérifient le travail par rapport aux standards et écrivent la règle manquante | Standards, fichiers de règles, fichiers d'instructions, candidats au registre des échecs | L'étape de découverte de chaque tâche ultérieure, et chaque revue de plan | L'agent juge une lacune de classe et la consigne ; une personne valide la fusion |
| 5 Tâches ouvertes sur le moment | Une friction devient une tâche dès qu'elle se fait sentir ; les règles incontournables deviennent des hooks | Tâches et hooks | Le backlog, et l'outil qui exécute l'agent, à chaque appel d'outil | Ouvrir une tâche ne demande l'accord de personne ; une personne fixe l'horizon |
| 6 Pipeline de mémoire | Lit chaque catégorie dans tous les espaces de travail, fusionne, promeut, retire et suggère | Entrées du registre, propositions de règles, modifications d'agents et de fichiers d'instructions | Tout ce qui précède | Les petites modifications entrent directement ; les nouvelles règles demandent une personne |
Les couches basses coûtent peu et ne voient qu'un travail. Les couches hautes sont plus lentes et voient tout le système. Construisez-les dans l'ordre, car chaque couche haute lit ce qu'écrivent les couches basses. En termes de conseil, c'est une étape du parcours vers un modèle opérationnel IA ; ce guide s'en tient à la mécanique.
Couche 1 : la mémoire, rappelée avant chaque travail et enregistrée après
Un agent qui commence chaque session de zéro répète toutes les erreurs qu'il a jamais commises. La mémoire est la première boucle, et elle ne fonctionne que si chaque travail lit avant d'écrire.
Qu'est-ce que la mémoire d'un agent IA dans un système auto-améliorant ? La mémoire d'un agent IA est une base de notes courtes et typées (décisions, corrections, pièges, procédures et autres) que chaque travail interroge à sa première étape et alimente au fil de l'eau. Nous utilisons une seule base pour tous les espaces de travail et tous les agents connectés, Claude Code comme OpenCode, si bien qu'une leçon enregistrée dans l'espace support est retrouvée par une tâche du site web.
Rappeler d'abord, enregistrer au fil de l'eau
La première étape de nos workflows commence par un rappel. Un seul appel, context_query, renvoie deux choses à la fois : des routes, qui indiquent où se trouvent les choses (modules, fichiers, documentation), et des mémoires, qui consignent ce que nous savons. Un appel plus ciblé, memory_recall, filtre par catégorie, par tags et par importance minimale quand une étape n'a besoin que d'un type de note.
Enregistrer, c'est appeler memory_store avec une catégorie, une importance de 1 à 10 et des tags. Le rappel classe par sens, par importance et par fraîcheur : l'agent fixe donc l'importance selon ce que perdrait un travail ultérieur s'il passait à côté de la note. Une nouvelle note qui en répète une existante la remplace au lieu de s'y ajouter en doublon.
La tâche de paiement de Copperfern s'ouvre en rappelant la décision « Toutes les dates sont stockées en UTC et affichées dans le fuseau horaire du client (mars) » et le piège « L'e-mail de commande formate les dates dans son propre modèle ». Avant d'écrire une ligne de code, l'agent connaît la règle et le piège.
Les mémoires sont typées, et chaque type alimente un endroit différent
La catégorie est le champ le plus important d'une mémoire, car c'est elle qui décide où va ensuite la leçon. Une correction est une règle candidate. Une décision se rappelle, elle ne se rouvre pas. Une préférence a sa place dans un fichier d'instructions, que chaque session lit sans requête.
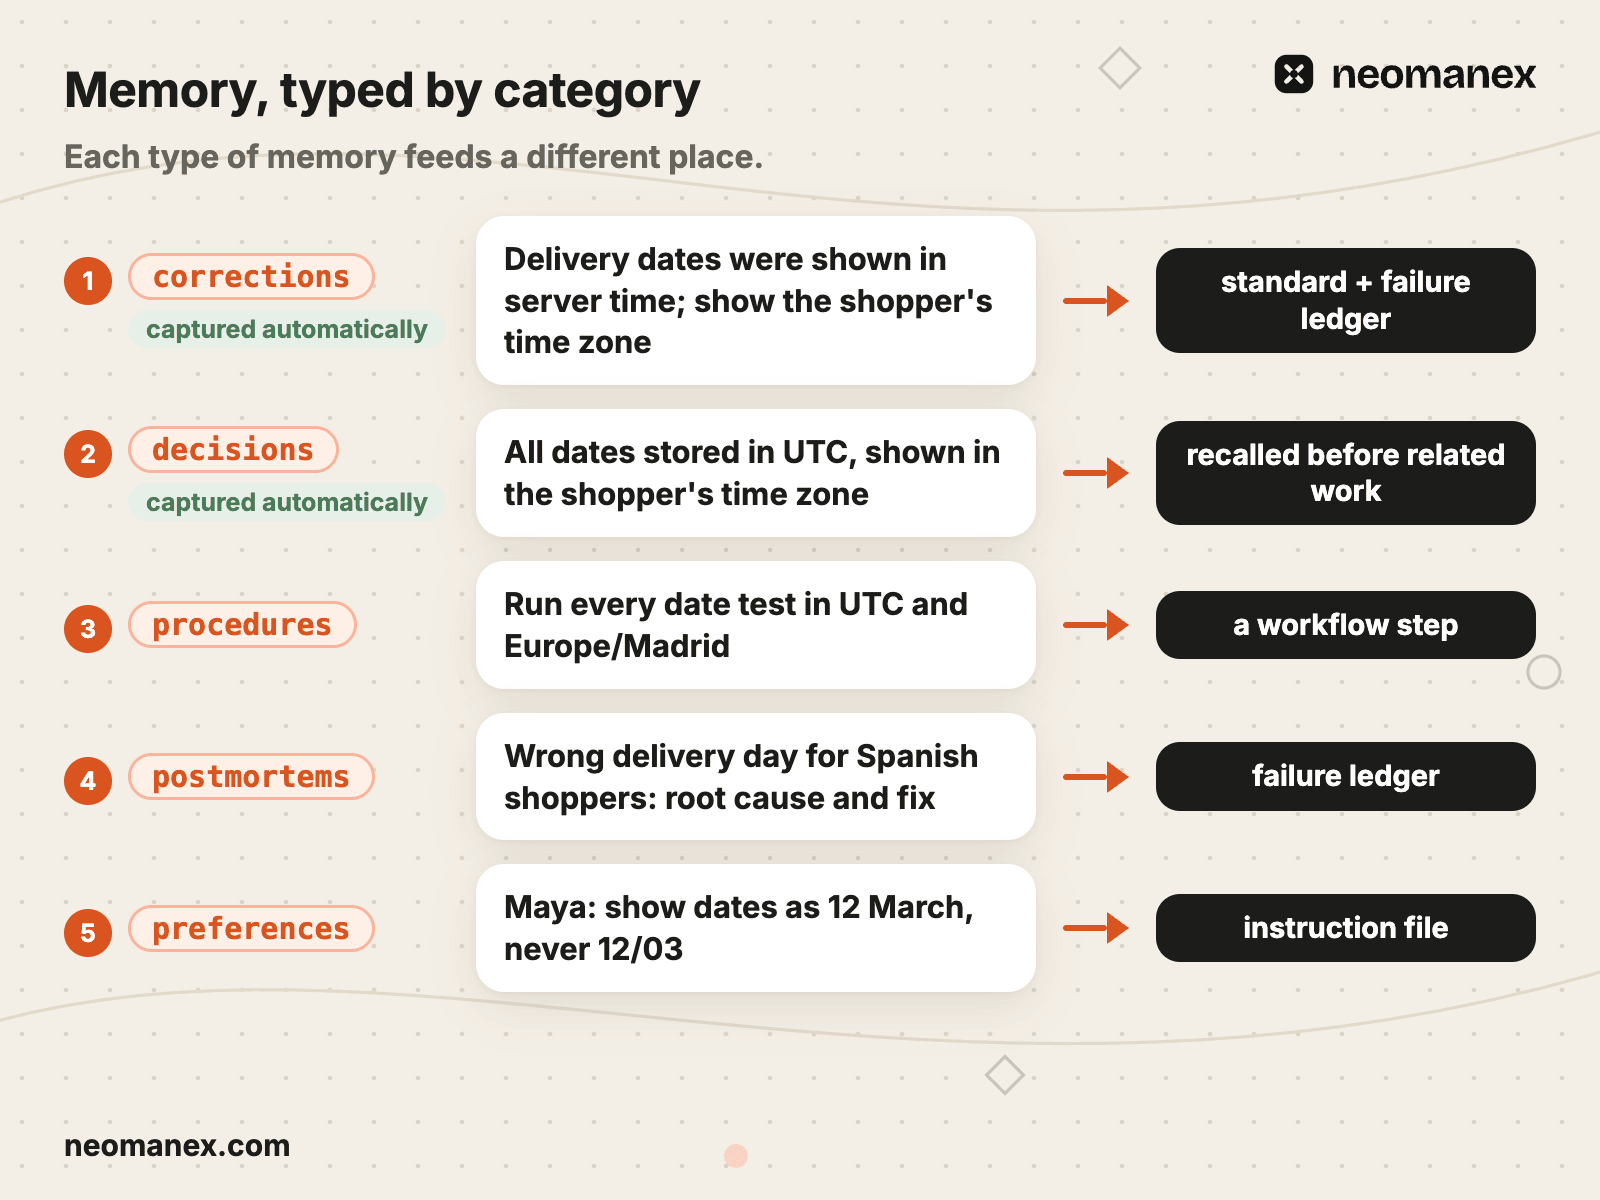
| Catégorie | Mémoire de Copperfern | Ce qu'elle alimente ensuite |
|---|---|---|
corrections | « Les dates de livraison s'affichaient à l'heure du serveur ; afficher le fuseau horaire du client » | Une règle candidate pour un standard et le registre des échecs |
gotchas | « L'e-mail de commande formate les dates dans son propre modèle » | Une règle candidate ; rappelée avant toute modification de date |
decisions | « Toutes les dates sont stockées en UTC et affichées dans le fuseau horaire du client (mars) » | Rappelée avant le travail lié |
context | La note de fusion de Maya : « Validé après la réussite du test Madrid » | Reste sur sa tâche, rappelée à la reprise de ce travail |
procedures, patterns | « Exécuter chaque test de date en UTC et en Europe/Madrid » | Étapes de workflow et standards |
postmortems | « Mauvais jour de livraison pour les clients espagnols : cause racine et correctif » | Le registre des échecs |
preferences | « Maya : afficher les dates sous la forme 12 mars, jamais 12/03 » | Fichiers d'instructions |
progress | « Tâche date de livraison fusionnée, branche nettoyée » | Reste sur sa tâche |
reference, customers, marketing, posts | Connaissances métier conservées pour leur propre travail | Rappelées par domaine |
La couche 6 lit toutes ces catégories à la fois. C'est là qu'une correction dans un espace et un piège dans un autre se révèlent être la même leçon.
Certaines mémoires s'enregistrent toutes seules
Trois canaux automatiques enregistrent sans que personne le demande, à mesure que surviennent les événements du cycle de vie. Chacun s'active par espace de travail, et nous les faisons tourner tous les trois :
decisions: quand une étape de décision est tranchée, qu'une tâche est annulée ou que quelqu'un écrit une note DECISION (décision).progress: à chaque passage d'étape et à chaque achèvement.corrections: quand quelqu'un écrit une note BLOCKER (bloquant), par exemple un refus à un point de validation.
En plus de ces canaux, les notes context= sont écrites chaque fois qu'elles sont transmises. Le paramètre context= des appels de tâche et de workflow enregistre la note comme mémoire context dans le même appel que l'action. Un réglage de l'espace de travail le contrôle, et il est activé par défaut.
Tout le reste est enregistré délibérément. Une note context= fait 2 à 3 lignes, une décision et sa raison, jamais un compte rendu d'avancement. Une note de moins de 40 caractères n'est pas enregistrée du tout, car les notes vides polluent le rappel, et ce seuil vit dans la base plutôt que dans la discipline de qui que ce soit.
Le suivi des tâches (context et progress) reste sur sa tâche. Il est marqué et exclu par défaut du rappel des autres tâches, si bien qu'une ligne d'avancement du mois dernier ne passe jamais devant une décision.
Qui valide une mémoire
Personne. Enregistrer est la règle par défaut, et l'agent fixe l'importance. Une mémoire faible est remplacée ou fusionnée plus tard dans la couche 6, jamais validée en amont. Une étape de validation à ce niveau pousse les agents à moins enregistrer, et une leçon manquante coûte bien plus cher qu'une note bruyante que le pipeline fusionnera.
Ce qui a mal tourné avec la mémoire, et la règle qui en est née
Notre première conception de la mémoire n'avait qu'une catégorie fourre-tout, learnings. Tout y finissait, et le rappel renvoyait un tas de notes mélangées pour n'importe quelle requête. La règle : learnings est obsolète dans notre standard de mémoire pour les nouvelles mémoires, et les mémoires vont dans des catégories précises, chacune avec son rôle. Chez Copperfern, le même tas mêlait dates, e-mails et prix ; désormais, chaque note a un type et une destination.
Le deuxième échec est venu après l'activation des canaux automatiques. Le suivi des tâches dépassait en nombre les connaissances délibérées et passait devant elles au rappel. La règle : le suivi est marqué et exclu par défaut du rappel entre tâches, et chaque nouveau canal de capture arrive avec un poids de rappel, une classe d'éligibilité et une importance configurable.
Si vos agents commencent chaque session de zéro, construisez cette couche en premier. ConvOps est l'endroit où nous la faisons tourner : des workflows avec une étape de rappel en premier et Learning Capture en dernier, et une base de mémoire unique que lit chaque agent connecté. Découvrez comment fonctionne ConvOps(s’ouvre dans un nouvel onglet).
Couche 2 : Learning Capture, la dernière étape de chaque workflow
Si l'enregistrement d'une leçon dépend de la mémoire de l'agent, il n'a pas lieu. Dans notre système, c'est donc une étape, et c'est la dernière de chaque workflow.
Learning Capture est une étape globale. Nous la définissons une fois, et le moteur de workflow l'ajoute, suivie de Complete (terminer), à chaque workflow concerné. Personne ne l'ajoute à la main à un nouveau workflow, et personne ne peut l'oublier. Les workflows de correction, et ceux qui exécutent une seule phase d'un plan plus large, sortent de son périmètre.
L'étape dit à l'agent :
Capturez les apprentissages de cette exécution de workflow. Enregistrez les décisions, les pièges et les patterns via memory_store(). Indexez les nouveaux chemins de code comme routes si des zones de code importantes ont été créées : route_create pour une nouvelle zone, ou route_update pour en étendre une existante. Interrogez d'abord la route existante et fusionnez vous-même les chemins, car route_update remplace chaque champ que vous envoyez. Si rien de notable ne s'est produit, passez avec « no learnings to store » (aucun apprentissage à enregistrer).
Ce texte contient trois choix de conception :
- Il nomme les catégories. Décisions, pièges, patterns : l'agent enregistre des mémoires typées, pas un journal de l'exécution.
- Il indexe le nouveau code comme routes. Le rappel du travail suivant dit où se trouve le code, en plus de ce que nous savons à son sujet.
- Il autorise à passer. Une exécution sans rien de nouveau n'enregistre rien, à dessein. Une note forcée à chaque exécution, c'est le déluge de suivi de la couche 1 qui revient.
Les workflows qui ont leur propre étape d'apprentissage exécutent les deux. Notre cycle d'amélioration (couche 3) a une étape Learn (apprendre) qui enregistre ce que chaque cycle a appris, et l'étape globale Learning Capture s'exécute quand même avant Complete.
Learning Capture alimente trois endroits : la base que rappelle la couche 1, les modifications de workflow de la couche 3 et le pipeline de la couche 6. Personne ne la valide ; l'agent décide de ce qui mérite d'être gardé.
La tâche de date de livraison de Copperfern se termine par Learning Capture, qui enregistre le piège « Le fuseau horaire du serveur s'infiltre dans les dates de livraison ; tester en Europe/Madrid » et une route vers le nouveau module de formatage des dates. La tâche de date suivante trouve les deux dès sa première étape : quoi tester, et où se trouve le code.
Ce qui a mal tourné. Des sessions modifiaient des fichiers et se terminaient sans rien enregistrer. Une étape en fin de workflow ne peut pas rattraper un travail fait hors workflow, ni une session qui s'arrête avant sa dernière étape. La règle : un hook Stop dans l'outil qui exécute l'agent (dans Claude Code, un script déclenché chaque fois que l'agent s'arrête) vérifie tous les 2 tours de l'assistant si la session a enregistré quelque chose. Une session qui a modifié des fichiers sans rien enregistrer est signalée immédiatement, sans attendre le nombre de tours. Le protocole ne dépend jamais de la mémoire de qui que ce soit, celle de l'agent comprise.
Couche 3 : des workflows qui se modifient eux-mêmes
Une leçon qui ne vit qu'en mémoire ne sert que si le rappel la retrouve. Une leçon écrite dans l'étape est lue chaque fois que le travail atteint cette étape. La troisième couche transforme donc ce qu'a trouvé Learning Capture en modification du workflow lui-même : une consigne plus précise, une nouvelle étape, un nouveau point de validation, une boucle bornée.
C'est pourquoi nous gardons les procédures dans des workflows plutôt que dans un long fichier d'instructions. Un workflow est un graphe d'étapes : une leçon va donc dans la seule étape qui en a besoin, pas dans un fichier que chaque étape doit lire (l'idée derrière le graph engineering).
Comment une étape change
Les modifications sont chirurgicales : une étape à la fois, jamais la reconstruction d'un workflow en service. Chaque modification n'est appliquée qu'avec zéro avertissement de validation, puis relue depuis le moteur pour confirmer que l'étape dit bien ce qui était prévu. Avant un changement structurel, comme déplacer ou supprimer une étape, nous vérifions les exécutions en cours, pour qu'aucune tâche active ne trouve sa prochaine étape disparue.
Le texte d'une étape ne contient que la procédure : ce que fait l'exécutant à cette étape. La raison d'un changement va dans une mémoire, jamais dans l'étape. Une étape chargée d'historique est une étape que les agents survolent.
Le workflow de développement de Copperfern tire la leçon de la date de livraison en une ligne :
Implement
  (existing instructions unchanged)
+ Run every date test in UTC and Europe/Madrid.
Dès lors, chaque tâche qui atteint Implement (implémenter) lit cette ligne. Aucun rappel n'a besoin de la classer, et aucun agent n'a besoin de s'en souvenir.
Une personne valide les modifications de workflow. L'agent propose le changement puis, une fois celui-ci validé, effectue la modification chirurgicale. Une correction d'une ligne dans un standard ou un fichier d'instructions vers lequel pointe une étape entre directement, selon notre standard des fichiers d'instructions (la couche 5 précise où passe cette limite).
Le cycle d'amélioration : une amélioration par cycle
Certains travaux améliorent un livrable au lieu de terminer une tâche : une page, un texte, un audit récurrent. Pour cela, nous utilisons le workflow Autonomous Cycle (cycle autonome), une boucle qui modifie son propre résultat, un changement à la fois.
| Étape | Ce qu'elle fait |
|---|---|
| Analyze (analyser) | Rappelle les leçons antérieures sur ce livrable (importance minimale 5, 10 au plus) et rédige une analyse |
| Validate (valider) | Rappelle les décisions passées (jusqu'à 10) et les pièges (jusqu'à 5). Si l'analyse est erronée ou répète une décision passée, elle écrit pourquoi et renvoie le cycle à Analyze |
| Plan (planifier) | Choisit l'amélioration au plus fort impact. Une par cycle, bien faite |
| Execute (exécuter) | Effectue ce seul changement |
| Learn | Enregistre ce que le cycle a appris |
| Continue? (continuer ?) | improve-more programme le cycle suivant une minute plus tard ; done clôt l'exécution. Un plafond de cycles, quand l'exécution en fixe un, l'arrête |
Learning Capture et Complete suivent, comme sur chaque workflow. Une amélioration par cycle garde chaque étape petite et vérifiable : un cycle qui change cinq choses ne peut pas dire laquelle a aidé. Le retour de Validate vers Analyze empêche la boucle de proposer ce qui a déjà été écarté.
Ce qui a mal tourné avec les workflows, et les règles qui en sont nées
Après l'arrêt d'une tâche de traduction séparée, nos guides sont sortis uniquement en anglais, et rien dans le workflow des guides ne l'a remarqué. La règle : la traduction est devenue une étape du workflow des guides, suivie d'un juge de traduction qui doit rendre zéro constat pour chaque langue. Chez Copperfern, les pages espagnoles avaient du retard sur les pages anglaises pour la même raison ; désormais, le workflow des pages traduit et juge avant de pouvoir publier.
Les étapes de revue tournaient aussi en boucle sans converger, chaque tour trouvant quelque chose de nouveau. La règle : chaque revue renvoie vers une étape de révision et, après 2 tours, ouvre un bug et s'arrête au lieu de lancer un troisième tour. Une revue qui boucle consomme des exécutions ; un bug fait intervenir une personne, preuves à l'appui.
Couche 4 : des étapes qui trouvent les lacunes et corrigent les standards
Le meilleur endroit pour trouver une règle manquante, c'est le workflow qui vient d'en avoir besoin. Notre workflow de développement porte donc ses propres étapes de détection des lacunes. Elles vérifient le travail par rapport aux standards, repèrent où un standard manque ou est faible, et écrivent le correctif avant que la tâche suivante ne commence.
Ce workflow s'appelle Development Task (MR flow) (tâche de développement, flux de merge request). Voici, dans l'ordre, les étapes qui comptent pour cette couche, avec les cinq étapes de détection des lacunes numérotées comme dans l'image ci-dessous. D'autres étapes, comme la documentation des cas d'usage, le push et les vérifications de CI, s'exécutent entre elles :
Functional Analysis (analyse fonctionnelle ; une personne valide, la liste des exigences est figée) → 1 Discover Standards & Flag Gaps → Technical Analysis (analyse technique) → 2 Traceability Check (one pass) → Implement → 3 Check Standards Compliance et Compliance Decision → 4 Terminal Gap Check → Update Documentation (mise à jour de la documentation) → Merge (Verification Review + CI Green + Operator) → Standards Check? → 5 Standards Capture → Learning Capture → Complete.

1. Discover Standards & Flag Gaps
Avant toute conception, cette étape (découvrir les standards et signaler les lacunes) confie à un agent de découverte des standards la lecture de nos fichiers de routage (un par équipe, la source unique qui dit quels standards s'appliquent à quel travail). Il en tire la liste des standards qui régissent cette tâche. Le même passage ouvre chaque standard et signale une lacune quand :
- aucun standard ne couvre le domaine
- un standard existe mais ne couvre pas le pattern dont ce travail a besoin
- un standard est obsolète ou contredit la pratique
- le travail introduit un nouveau pattern qu'aucun standard ne traite
- un fichier de standard existe mais aucun fichier de routage n'y mène
Sans aucune lacune, l'étape l'indique et avance sans attendre. À la moindre lacune, elle s'arrête, et une personne tranche lacune par lacune : créer une tâche, étendre un standard existant ou accepter le risque. Au passage à l'étape suivante, la liste est verrouillée pour ce travail. Chaque vérification ultérieure se fait sur cette liste verrouillée, si bien que personne ne change les règles en cours de route.
2. Traceability Check (one pass)
Après Technical Analysis, cette vérification de traçabilité confie à un analyseur de lacunes un seul passage sur une liste fermée de quatre points. Un seul passage, jamais une boucle. Les blocages relevés sur les trois premiers points sont corrigés sur place, un blocage sur le quatrième point attend la décision d'une personne, et tout le reste va dans la liste de surveillance des risques connus de la tâche au lieu de déclencher un nouveau tour de revue.
3. Check Standards Compliance et Compliance Decision
Après Implement, un relecteur de standards vérifie la modification par rapport à la liste verrouillée : c'est le contrôle de conformité. Compliance Decision (décision de conformité) lit le rapport :
| Constat | Ce qui se passe |
|---|---|
| HIGH ou MEDIUM (élevé ou moyen) | Le workflow de correction s'exécute une fois. Le relecteur n'est pas relancé : la preuve, ce sont les éléments du correcteur lui-même (lint, vérification de types et tests unitaires concernés au vert), cités dans les notes de la tâche |
| LOW (faible), une ligne | Corrigé sur place |
| LOW, plus d'une ligne | Recherche d'une tâche existante, sinon ouverture d'une tâche avec le tag discovered-during-execution, en citant fichier, ligne et standard |
| Préexistant | Jamais corrigé ici |
L'étape passe avec zéro constat HIGH et zéro constat MEDIUM ouvert.
4. Terminal Gap Check
Avant la documentation et la fusion, le Terminal Gap Check (contrôle final des lacunes) fait trois choses. Chaque élément de la liste de surveillance de l'étape 2 est clos : un risque qui s'est concrétisé est corrigé maintenant, un risque qui ne s'est pas concrétisé reçoit une ligne qui en acte le sort. Chaque exigence est reliée à sa preuve livrée, et une exigence sans preuve reçoit un test maintenant, sinon l'étape s'arrête jusqu'à la décision d'une personne. Enfin, chaque échec d'exécution que rien n'avait prévu est enregistré comme mémoire failure-pattern d'importance 7 : ce sont les candidats au registre des échecs.
Update Documentation suit, rédigée par un agent de documentation à partir du diff. Après le push et les vérifications de CI vient le point de validation Merge : il exige un pipeline au vert et l'accord d'une personne, les deux. C'est le seul point de contrôle opérateur entre l'analyse validée et la fusion, et un pipeline rouge signifie corriger la cause, jamais fusionner en passant outre.
5. Standards Check? et Standards Capture
Après la fusion, Standards Check? (vérifier les standards ?) décide si le correctif apprend quelque chose aux standards. Oui quand un bug corrigé peut représenter une classe d'erreurs, quand un standard manquant ou faible aurait pu éviter le problème, ou quand le changement a révélé une lacune dans les standards. Non pour une simple fonctionnalité, une refactorisation sans changement de comportement ou une modification qui ne touche que la documentation.
Un oui déclenche Standards Capture (capture des standards), en trois étapes :
- Assess Standards Gap (évaluer la lacune) lit les standards, les fichiers de règles des agents et les fichiers d'instructions. Elle renvoie « No gap » (aucune lacune) avec une raison d'une ligne, ou « Gap found » (lacune trouvée) avec le fichier exact, la règle, la justification et une proposition de formulation. Elle ne recommande une règle que lorsque le bug représente une classe d'erreurs qu'une règle attraperait, jamais pour un cas isolé.
- Standards Judgment (jugement sur les standards) est la décision de l'agent seul, sans validation de l'opérateur. Avant d'avancer, il doit consigner le résultat comme activité. Ce journal a remplacé la signature d'une personne, et c'est la piste d'audit.
- Apply Standard (appliquer le standard) ne s'exécute que si la lacune a été jugée fondée. Un agent de documentation écrit la règle, puis relit le fichier pour vérifier que la modification est bien en place.
Le test de classe est ce qui garde les standards lisibles. Une règle pour chaque bug isolé gonfle un standard jusqu'à ce qu'aucun agent ne le lise attentivement.
Voici comment le correctif de date de livraison de Copperfern passe par ces étapes :
Standards Check?   yes
Assess             Gap found. Class: any date shown to a shopper can leak server time
Judgment (logged)  Standards judgment: applied dates-and-times.md, shopper time zone
Apply              dates-and-times.md v1.2
                   Store UTC; render in the shopper's time zone;
                   every date test runs in two time zones
Standards Capture modifie les standards, les fichiers de règles et les fichiers d'instructions. Les corrections de workflow passent par la couche 3. Les changements de définitions d'agents viennent de ce que trouvent ces étapes et des suggestions de la couche 6.
Le registre des échecs : la grille des revues de plan
Qu'est-ce qu'un registre des échecs ? Un registre des échecs est une liste choisie de patterns d'échec réfutables, chacun tiré d'un incident réel, que les revues de plan vérifient un par un. Chaque entrée a quatre champs : ID, Pattern (le schéma d'échec), Check (la vérification) et Incident. Un relecteur rend PASS, FAIL ou N/A (conforme, non conforme, sans objet) pour chaque entrée, et ne lit que la section Global (générale) et la section de son propre projet.
| ID | Pattern | Check | Incident |
|---|---|---|---|
FL-P1 | Date affichée sans le fuseau horaire du client | Chaque date du plan indique son fuseau horaire | Date de livraison sur les pages produit |
| Règle du registre | Valeur | Pourquoi |
|---|---|---|
| Admission | Incidents réels uniquement ; candidats promus lors de la consolidation, jamais en cours de revue | Un registre de risques imaginaires n'est qu'une liste de souhaits |
| Plafond par section | 15 entrées ; au plafond, les entrées qui se recoupent fusionnent avant qu'une nouvelle n'entre | « C'est le plafond qui force le tri » |
| Retrait | Uniquement PASS ou N/A sur 5 plans consécutifs : déplacée vers Retired (retirées) lors de la consolidation | Une vérification qui ne se déclenche jamais coûte à chaque revue |
| Où elle est vérifiée | La revue du plan suivant | Le workflow de développement fournit les candidats ; les revues de plan lisent le registre |
Ce qui a mal tourné. Une revue de plan enchaînait les tours, chacun trouvant quelque chose de nouveau, sans jamais converger. La règle : les revues vérifient un registre choisi de patterns réfutables issus d'incidents réels, chaque constat adossé à son incident, avec un plafond par section et un nombre de tours borné.
Couche 5 : des améliorations consignées pendant le travail
Le moment le moins coûteux pour consigner une friction, c'est celui où elle se fait sentir. Une leçon dont on se souvient en fin de semaine est déjà à moitié perdue. Toute suggestion d'amélioration d'une boucle, d'une étape, d'un standard ou d'un outil devient donc une tâche dès qu'elle est trouvée, et le travail continue.
La règle vit dans notre fichier d'instructions racine. Une action qui n'a pas réussi du premier coup (un test qui échoue la première fois, un prérequis caché, une configuration manquante, une étape non documentée) déclenche une alerte à une personne, puis la recherche d'une tâche existante, et l'ouverture d'une tâche avec le tag discovered-during-execution seulement si aucune ne correspond. Toutes ces tâches sont rattachées à un même objectif de santé de l'ingénierie, quel que soit le projet d'origine, si bien que la friction a un seul point d'arrivée et un seul backlog.
Compliance Decision applique la même règle à l'intérieur d'un workflow : un constat LOW de plus d'une ligne devient une tâche, jamais une raison de bloquer la fusion.
En corrigeant la date de livraison, l'agent de Copperfern découvre que l'e-mail de commande formate les dates dans son propre modèle. Il ouvre la tâche « L'e-mail de commande ignore le fuseau horaire du client », avec le tag discovered-during-execution, et termine la tâche en cours. L'e-mail obtient sa propre tâche, sa propre revue et sa propre fusion.
Ouvrir une tâche ne demande aucune validation. Une personne fixe l'horizon : now, next ou later (maintenant, ensuite ou plus tard). Quand le correctif est une petite modification d'un fichier d'instructions, d'un standard ou d'un protocole (une ligne, une valeur périmée, une coquille, sans nouvelle règle ni choix de conception), l'agent l'applique directement selon notre standard des fichiers d'instructions, puis fait le commit et le push. Une nouvelle règle, une restructuration ou tout ce qui change le comportement des agents est d'abord proposé, puis validé par une personne. Ce partage garde les fichiers d'instructions courts : ils renvoient aux standards, ils ne les contiennent jamais (pourquoi un long CLAUDE.md est un symptôme).
Les hooks : les règles qui ne dépendent jamais de la mémoire
Certaines règles sont trop importantes pour vivre dans un prompt. Les hooks de l'outil qui exécute votre agent se déclenchent avant ou après les appels d'outils et quand l'agent s'arrête : ils appliquent une règle, que l'agent s'en souvienne ou non. Voici trois des hooks que nous utilisons dans Claude Code :
| Hook | Quand il se déclenche | Ce qu'il impose |
|---|---|---|
| Blocage des commandes destructrices | Avant chaque commande shell | La suppression est bloquée avant de s'exécuter, et les fichiers sont archivés à la place (comment nous empêchons les suppressions) |
| Contrôle des écarts Git | Quand la session s'arrête | Un travail non commité ou non poussé empêche la session de se terminer |
| Contrôle de la mémoire | Quand la session s'arrête, tous les 2 tours de l'assistant | Des fichiers modifiés sans rien d'enregistré sont signalés immédiatement |
Les tâches ouvertes alimentent le backlog, où chacune est traitée comme une tâche à part entière. Elles alimentent la couche 6, qui lit les problèmes signalés en même temps que les mémoires. Et quand le correctif est une étape ou un standard, elles alimentent les couches 3 et 4.
Ce qui a mal tourné. Une boucle de standards (vérifier, corriger, revérifier) trouvait sans cesse de nouveaux constats LOW, tour après tour, jusqu'à ce qu'une personne l'arrête, pendant que la vraie tâche attendait. La règle : les constats HIGH et MEDIUM sont corrigés une fois, sans nouvelle revue. Un constat LOW est corrigé sur place s'il tient en une ligne, sinon il devient une tâche. Chez Copperfern, la même boucle aurait bloqué le correctif de date de livraison pour une formulation de commentaire ; avec la règle, la formulation part dans une tâche et le correctif est fusionné.
Couche 6 : le pipeline de mémoire qui passe en revue tout le système
Chaque couche précédente voit un seul travail. Celle-ci les voit tous, et c'est là qu'apparaissent les patterns qu'aucun travail isolé ne peut voir.
Le pipeline de mémoire lit chaque catégorie de mémoire, chaque décision et chaque problème signalé dans tous les espaces de travail. Il fusionne ce qui se répète, garde le registre honnête et suggère des améliorations pour tout le système : standards, workflows, définitions d'agents et fichiers d'instructions.
La mécanique :
- La consolidation exécute
memory_consolidatechaque mois sur chaque catégorie active : d'abord un essai à blanc, pour qu'une personne puisse lire ce qui fusionne, puis la fusion des mémoires à 0,85 de similarité ou plus. Ce seuil fusionne les quasi-doublons et garde séparées les leçons distinctes. - Les chaînes de remplacement substituent à une ancienne mémoire sa version plus récente au lieu de garder les deux.
expires_atsupprime le contexte limité dans le temps quand il cesse d'être vrai.- L'entretien du registre promeut les candidats
failure-patterndans le registre, jamais en cours de revue, et déplace vers Retired les entrées qui ont traversé 5 plans consécutifs sans se déclencher.
Chaque suggestion arrive là où elle doit, avec son propre validateur :
| Suggestion | Arrive sous forme de | Qui valide |
|---|---|---|
| Un candidat failure-pattern | Une entrée du registre | Promu lors de la consolidation |
| Une entrée du registre qui ne se déclenche jamais | Une entrée dans Retired | Déplacée lors de la consolidation, selon la règle du registre |
| Une petite correction d'un fichier d'instructions, d'un standard ou d'un protocole | Une modification directe | L'agent, selon le standard des fichiers d'instructions |
| Une nouvelle règle ou une restructuration | Une proposition | Une personne |
| Un changement de workflow | Une modification de couche 3 | Une personne |
| Une ligne pour une définition d'agent | Une proposition | Une personne |
La consolidation de Copperfern lit corrections et gotchas dans les espaces site web et support. Elle trouve trois corrections liées aux dates et aux fuseaux horaires, les fusionne et promeut l'entrée FL-P1 du registre. Elle propose aussi une ligne pour la définition de l'agent d'implémentation, « Ne jamais afficher une date sans le fuseau horaire du client », et Maya la valide.
Ce qui a mal tourné. Les deux échecs de la couche 1, la catégorie fourre-tout et le déluge de suivi, sont d'abord apparus ici, sous la forme d'un rappel qui renvoyait du bruit. Vu depuis un seul travail, ce bruit ressemble à de la malchance ; à l'échelle de toute la base, c'est un pattern qui a une cause, et seule cette couche voit toute la base.
Des agents IA qui apprennent de leurs erreurs : une leçon à travers les six couches
Les agents IA qui apprennent de leurs erreurs le font en écrivant la leçon à plus d'un endroit. Voici une leçon de Copperfern, d'une fusion refusée jusqu'à la réussite de la tâche suivante. La tâche s'intitule « Afficher la date de livraison sur les pages produit » et suit le workflow Development Task (MR flow).

- Déclencheur. Au point de validation Merge, Maya refuse avec une note BLOCKER : « Les clients espagnols voient la date de demain comme celle d'aujourd'hui. »
- Couche 1, mémoire. La note BLOCKER est capturée automatiquement comme mémoire
corrections: « Les dates de livraison s'affichaient à l'heure du serveur ; afficher le fuseau horaire du client. » - Couche 2, Learning Capture. La tâche corrigée se termine en enregistrant le piège « Le fuseau horaire du serveur s'infiltre dans les dates de livraison ; tester en Europe/Madrid », plus une route vers le module de formatage des dates.
- Couche 3, modification du workflow. L'étape Implement reçoit la ligne qui fait exécuter chaque test de date en UTC et en Europe/Madrid.
- Couche 4, étapes de détection. Standards Check? répond oui. Assess trouve une classe : toute date affichée à un client peut laisser passer l'heure du serveur. Le jugement est consigné, et
dates-and-times.mdv1.2 reçoit la règle « Stocker en UTC ; afficher dans le fuseau horaire du client ; chaque test de date s'exécute dans deux fuseaux horaires », relue après écriture. Le Terminal Gap Check avait enregistré le candidatfailure-pattern. - Couche 5, tâche ouverte. La tâche « L'e-mail de commande ignore le fuseau horaire du client » est ouverte, avec le tag
discovered-during-execution. - Couche 6, pipeline. La consolidation fusionne trois corrections de fuseau horaire entre site web et support, promeut
FL-P1et propose « Ne jamais afficher une date sans le fuseau horaire du client » pour l'agent d'implémentation. Maya valide la ligne. - Tâche suivante. « Afficher les créneaux de retrait » démarre. Sa première étape rappelle la décision sur l'UTC. Discover Standards & Flag Gaps liste
dates-and-times.md. Check Standards Compliance passe. La revue du plan auquel elle appartient vérifieFL-P1: PASS. Maya valide au point Merge.
La tâche suivante réussit parce que six couches ont écrit la leçon à six endroits, pas parce que le modèle a changé. Si le rappel manque la mémoire, la ligne de l'étape est là. Si un nouvel agent saute l'étape, le standard figure dans sa liste verrouillée. Si le plan dérive, le registre le rattrape.
À quoi ressemble l'autonomie après les couches
L'autonomie n'est pas un réglage que l'on pousse. C'est ce qui reste quand les couches inférieures ont rendu prévisible la décision d'un point de validation. Un point de validation passe de la signature d'une personne à une vérification consignée seulement dans ce cas, et la décision reste consignée pour qu'une personne puisse la lire (comment nous lisons les décisions des agents).

| Passé de la signature d'une personne à une vérification consignée | Ne bouge jamais |
|---|---|
| Standards Judgment sur une lacune de classe : l'agent décide et consigne une activité qu'une personne lit | Le point de validation Merge pour le code : pipeline au vert et accord d'une personne |
| Conformité aux standards : HIGH et MEDIUM corrigés une fois avec les preuves du correcteur, sans seconde revue | La publication d'un guide |
| Tours de revue : une revue en échec va vers une étape de révision, puis vers un bug après 2 tours | Force-push, réécriture de l'historique et tags de release publics |
| Points de validation pré-approuvés pour une exécution quand une personne dit « go autonomous » (passer en autonome) | La suppression de fichiers : bloquée par un hook, archivage à la place |
| Petites corrections de pages publiées, revérifiées en ligne, le reste étant mis de côté pour une personne (la boucle d'autoréparation) | Les nouvelles règles et les restructurations des fichiers d'instructions et des protocoles |
Standards Judgment est le cas le plus net. Cette étape attendait autrefois une personne. Le test de classe d'Assess, les standards qu'elle lit et la relecture d'Apply ont rendu son résultat assez prévisible pour qu'une décision consignée remplace désormais la signature. L'activité de Copperfern indique « Standards judgment: applied dates-and-times.md, shopper time zone » (jugement sur les standards : dates-and-times.md appliqué, fuseau horaire du client), et Maya la lit quand elle le souhaite. La fusion, elle, l'attend toujours.
La colonne de droite est un choix de conception, pas un manque de maturité. Ces actions sont irréversibles ou publiques, et une décision consignée après coup ne peut pas les annuler. Là où une personne reste dans la boucle, c'est parce que le risque s'y trouve (concevoir des systèmes d'IA avec l'humain dans la boucle).
Ce qui tourne mal quand on construit des agents IA auto-améliorants
Chaque règle de ce système vient d'un échec que nous avons rencontré. Les voici réunies, avec la couche que chacune a modifiée.
| Échec | Règle qui en est née | Couche |
|---|---|---|
| Une seule catégorie de mémoire fourre-tout ; le rappel renvoyait du bruit | Des catégories précises ; learnings obsolète pour les nouvelles mémoires | 1, 6 |
| Le suivi des tâches dépassait en nombre les connaissances délibérées au rappel | Le suivi reste sur sa tâche, hors du rappel entre tâches | 1, 6 |
| Des sessions modifiaient des fichiers sans rien enregistrer | Un hook Stop signale immédiatement les modifications sans mémoire | 2, 5 |
| Des guides publiés en anglais seulement | La traduction comme étape du workflow, avec un juge | 3 |
| Des revues bouclaient sans converger | Registre des échecs, étapes de révision, un bug après 2 tours | 3, 4 |
| Une boucle de standards trouvait sans cesse de nouveaux constats LOW | HIGH et MEDIUM corrigés une fois ; LOW sur place ou en tâche | 5 |
| Un brief prévoyait une image par paragraphe | Un budget d'images dans le standard des guides | 4 |
La dernière ligne montre la même boucle à l'œuvre sur du contenu, pas sur du code. Un brief de guide prévoyait bien plus d'images qu'un lecteur n'en a besoin, et aucune règle ne fixait de plafond. Une personne l'a refusé au point de validation Brief et, comme chaque brief planifie des images, le correctif est allé dans le standard plutôt que dans ce seul brief : le standard des guides a gagné un budget d'au plus 8 images pour un guide consacré à une boucle et 6 pour tout autre guide, image principale comprise. Chez Copperfern, la même règle aurait réduit un brief de guide d'achat qui prévoyait une image par paragraphe aux quelques images qui expliquent ce que le texte ne peut pas montrer.
Le mécanisme derrière chaque ligne est le même. L'échec s'est produit une fois, quelqu'un a écrit la règle dans la couche qui l'aurait attrapé, et le travail suivant a lu la règle au lieu de redécouvrir l'échec. Notre boucle d'expériences SEO a fait grandir ses règles de la même façon.
Construire votre propre système d'exploitation IA, couche par couche
Vous n'avez pas besoin des six couches dès le premier jour. Les couches 1 et 2 viennent d'abord, car chaque couche supérieure lit ce qu'elles écrivent. Ajoutez les étapes de détection des lacunes quand vous avez des standards qui méritent qu'on s'y mesure, et le pipeline quand votre base contient assez de mémoires pour se répéter.
Les six étapes ci-dessous suivent les couches dans l'ordre. Chacune fonctionne avec n'importe quel outil d'exécution d'agents ; ConvOps sert d'exemple, parce que c'est là que nous faisons tourner les nôtres. Créez un compte ConvOps gratuit(s’ouvre dans un nouvel onglet) et connectez votre agent(s’ouvre dans un nouvel onglet) pour suivre le guide.
Étapes
Donner une mémoire à chaque travail
Placez une étape de rappel en premier sur chaque workflow et enregistrez des mémoires typées pendant le travail : décisions, corrections, pièges, procédures. Décidez de ce que chaque catégorie alimente. Activez la capture automatique des décisions, de l'avancement et des corrections, qui reste désactivée tant que vous ne l'activez pas pour votre espace de travail.
Faire de Learning Capture la dernière étape
Ajoutez à chaque workflow une dernière étape globale qui enregistre les décisions, les pièges et les patterns, et qui indique où se trouve le nouveau code. Laissez-la passer avec « no learnings to store » (aucun apprentissage à enregistrer) quand une exécution n'a rien appris de nouveau.
Modifier le workflow, pas le prompt
Transformez chaque leçon répétée en une ligne dans l'étape qui en avait besoin, ou en une nouvelle étape. Faites une modification chirurgicale à la fois, validez-la, relisez-la, et gardez la raison dans une mémoire, pas dans l'étape.
Ajouter des étapes de détection des lacunes
Découvrez les standards applicables avant le travail et signalez les lacunes, vérifiez la conformité après, et lancez un contrôle final des lacunes qui enregistre les candidats aux patterns d'échec. Évaluez chaque correctif comme une classe ou un cas isolé, et tenez un registre des échecs tirés d'incidents réels, plafonné à 15 entrées par section, pour les revues de plan.
Ouvrir une tâche dès que la friction se fait sentir
Quand quelque chose ne réussit pas du premier coup, alertez une personne, cherchez une tâche existante et ouvrez-en une avec le tag discovered-during-execution, puis terminez la tâche en cours. Placez les règles qui ne doivent jamais échouer, comme le blocage de la suppression de fichiers, dans les hooks de l'outil qui exécute votre agent.
Lancer le pipeline de mémoire et déplacer un point de validation
Consolidez les mémoires chaque mois par catégorie, avec d'abord un essai à blanc, promouvez les candidats du registre, retirez les entrées qui ne se déclenchent jamais, et proposez des changements aux standards, aux workflows, aux agents et aux fichiers d'instructions. Confiez ensuite un point de validation prévisible à une décision d'agent consignée, et laissez les fusions et la publication à une personne. Créez un compte ConvOps gratuit sur https://my.convops.app/register et connectez votre agent sur https://convops.app/connect. Vous voulez le construire avec votre équipe ? Réservez une Discovery Session (séance de découverte) gratuite sur https://neomanex.com/fr/services.
Questions fréquentes
Qu'est-ce qu'un système d'IA auto-améliorant ?
Un système d'IA auto-améliorant est un dépôt de standards, une base de mémoire et des workflows à points de validation qui transforment les leçons de chaque travail terminé en règles que le travail suivant lit. ConvOps héberge les workflows, les points de validation et la base de mémoire sur lesquels nous faisons tourner le nôtre. Il apprend en six couches, de la mémoire rappelée avant chaque travail jusqu'à un pipeline qui passe en revue tout le système. Le modèle ne change jamais ; ce sont les fichiers, les étapes et les mémoires qui l'entourent qui changent.
À qui s'adresse un système d'IA auto-améliorant ?
Un système d'IA auto-améliorant s'adresse aux responsables techniques, aux ingénieurs plateforme et ops et aux fondateurs techniques qui confient un travail récurrent à des agents IA, en développement, en contenu ou en opérations. ConvOps exécute ce travail sous forme de tâches sur des workflows à points de validation : une erreur répétée devient une règle écrite, avec la trace de qui l'a validée, et le travail suivant lit cette règle avant de commencer.
Une IA auto-améliorante est-elle possible sans réentraîner le modèle ?
Oui. Dans ConvOps, les leçons aboutissent dans des mémoires typées, des étapes de workflow et des standards écrits, et les poids du modèle ne sont jamais modifiés : chaque leçon reste lisible et réversible. Le système ne modifie ni le modèle ni ses propres garde-fous : une personne valide les fusions, la publication, les nouvelles règles et les restructurations des fichiers d'instructions, et un hook bloque la suppression de fichiers.
Comment construire un système d'IA auto-améliorant ?
Créez un compte ConvOps gratuit sur my.convops.app/register et connectez l'agent que vous utilisez déjà. Placez ensuite une étape de rappel en premier et une étape Learning Capture (capture des apprentissages) en dernier sur un workflow, et activez la capture automatique des décisions et des corrections. Ajoutez des étapes de détection des lacunes qui vérifient le travail par rapport à vos standards, ouvrez une tâche pour chaque friction dès qu'elle apparaît, et lancez une consolidation mensuelle de vos mémoires.
Comment empêcher les règles et les mémoires de grossir sans limite ?
ConvOps range les mémoires dans des catégories précises, remplace les doublons au moment de l'enregistrement et fusionne les quasi-doublons lors d'une consolidation mensuelle à 0,85 de similarité. Le suivi des tâches reste hors du rappel entre tâches. Un standard ne gagne une règle que pour une classe d'erreurs, jamais pour un cas isolé. Le registre des échecs contient au plus 15 entrées par section, et une entrée qui ne renvoie que PASS ou N/A (conforme ou sans objet) sur 5 plans consécutifs est retirée.
Qui valide un changement des règles ?
Dans ConvOps, cela dépend de la couche. Les agents enregistrent les mémoires sans validation. Une lacune de classe dans les standards est jugée par l'agent et consignée comme activité qu'une personne peut lire. Les petites modifications des fichiers d'instructions et des standards, comme une ligne ou une valeur périmée, entrent directement selon un standard. Les nouvelles règles, les restructurations et les changements de workflow demandent une personne, et les fusions comme la publication attendent toujours une personne.
En quoi un système d'IA auto-améliorant diffère-t-il d'un fichier de leçons ?
Un fichier de leçons est un fourre-tout qui grossit sans limite, et c'est pourquoi nous avons rendu obsolète notre propre catégorie de mémoire learnings pour les nouvelles mémoires. Dans ConvOps, chaque leçon est typée et aboutit dans la couche qui l'utilise : une décision rappelée, une étape de workflow, un standard ou une entrée du registre des échecs. Elle est plafonnée et consolidée, et le rappel ne renvoie que les mémoires qui correspondent au travail.