Ce que vous saurez faire
- Mettre en place un dépôt registre avec une fiche par expérience SEO
- Répartir les familles de pages en groupes traité et témoin par une affectation aléatoire à graine fixe
- Lire un verdict de différence de différences et décider de conserver, prolonger ou revenir en arrière
- Planifier un pouls quotidien qui prend un instantané des données Search Console et réveille les expériences arrivées à échéance
- Savoir quels types de correction votre site peut mesurer, et lesquels il ne peut pas mesurer du tout
Points clés
- Une correction SEO ne compte que si un groupe témoin de pages intactes, tiré au sort, a moins bougé que les pages traitées.
- Inscrivez l'hypothèse, la métrique, les groupes de pages et la règle de réfutation dans le registre avant la modification, et ne les modifiez jamais ensuite.
- Un script calcule chaque métrique et chaque verdict ; Claude Code exécute les étapes et lit le résultat.
- Non concluant est un verdict normal sur un petit site : la boucle prolonge une fois jusqu'au jour 59, puis ferme.
- Un pouls quotidien sert d'horloge : les expériences dorment jusqu'à leur échéance et sont réveillées au jour 15 et au jour 31.
Ce que fait la boucle d'expériences SEO
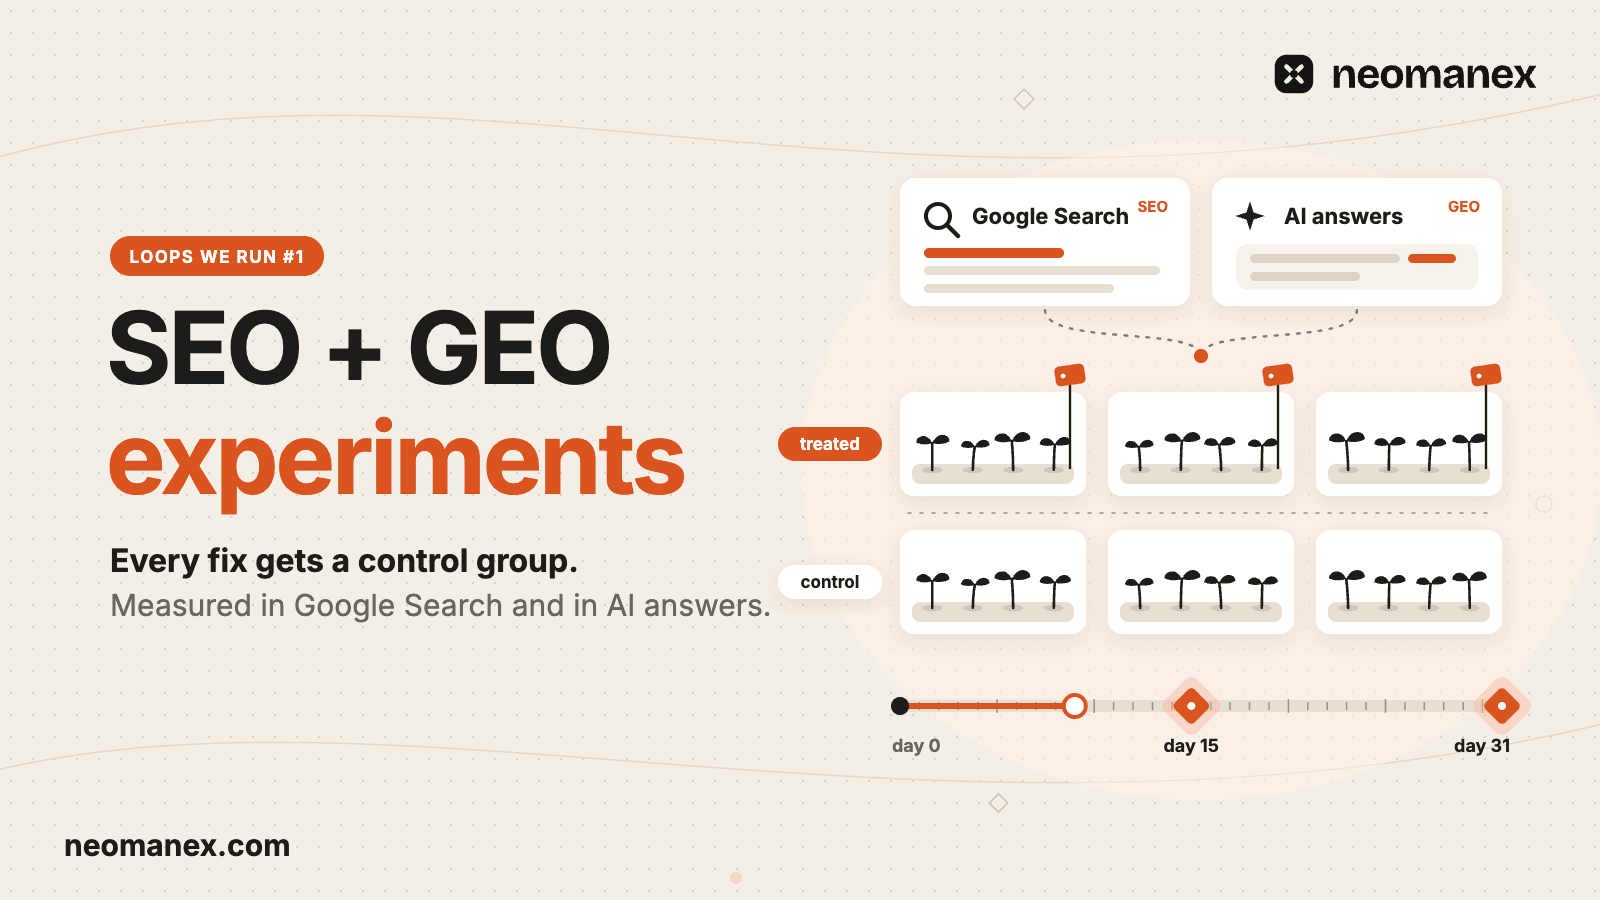
Une expérience SEO ne vous apprend quelque chose que si les pages modifiées ont plus bougé qu'un groupe de pages laissées intactes. Nous faisons passer toutes les corrections SEO de notre site par cette règle. Claude Code rédige la fiche de l'expérience avant de toucher la moindre page, modifie un groupe traité tiré au sort, laisse de côté un groupe témoin apparié, et un script compare les deux au jour 15 et au jour 31. ConvOps fait tourner l'ensemble sous forme de tâches planifiées avec des workflows, et une personne fusionne chaque modification. C'est l'une des boucles sur lesquelles tourne notre entreprise.
Une expérience SEO pré-enregistrée est une modification de page dont l'hypothèse, la métrique, les groupes de pages et la règle de réfutation sont committés avant la mise en ligne, et jamais modifiés ensuite. Une famille de pages est une page et ses variantes linguistiques (en, es, de). Les familles sont l'unité que la boucle affecte au groupe traité ou au groupe témoin.
Chaque écran et chaque chiffre ci-dessous utilisent des données d'exemple de Tidewell, une application de facturation fictive à l'adresse tidewell.example.com.
| Élément | Ce que c'est |
|---|---|
| Déclencheur | Quatre planifications. Personne ne lance une exécution à la main |
| Entrées | Les données de pages de Search Console, les passages des robots d'IA et les visites humaines issues des statistiques d'audience du site |
| Environnement d'exécution de l'agent | Claude Code, une session isolée par exécution |
| Orchestrateur | Les tâches, workflows et planifications de ConvOps |
| Sorties | Des instantanés, des fiches d'expériences, des notes de recherche et de stratégie, le tout dans un seul dépôt git servant de registre |
| Contrôles humains | Chaque fusion sur le site, et chaque note de stratégie |
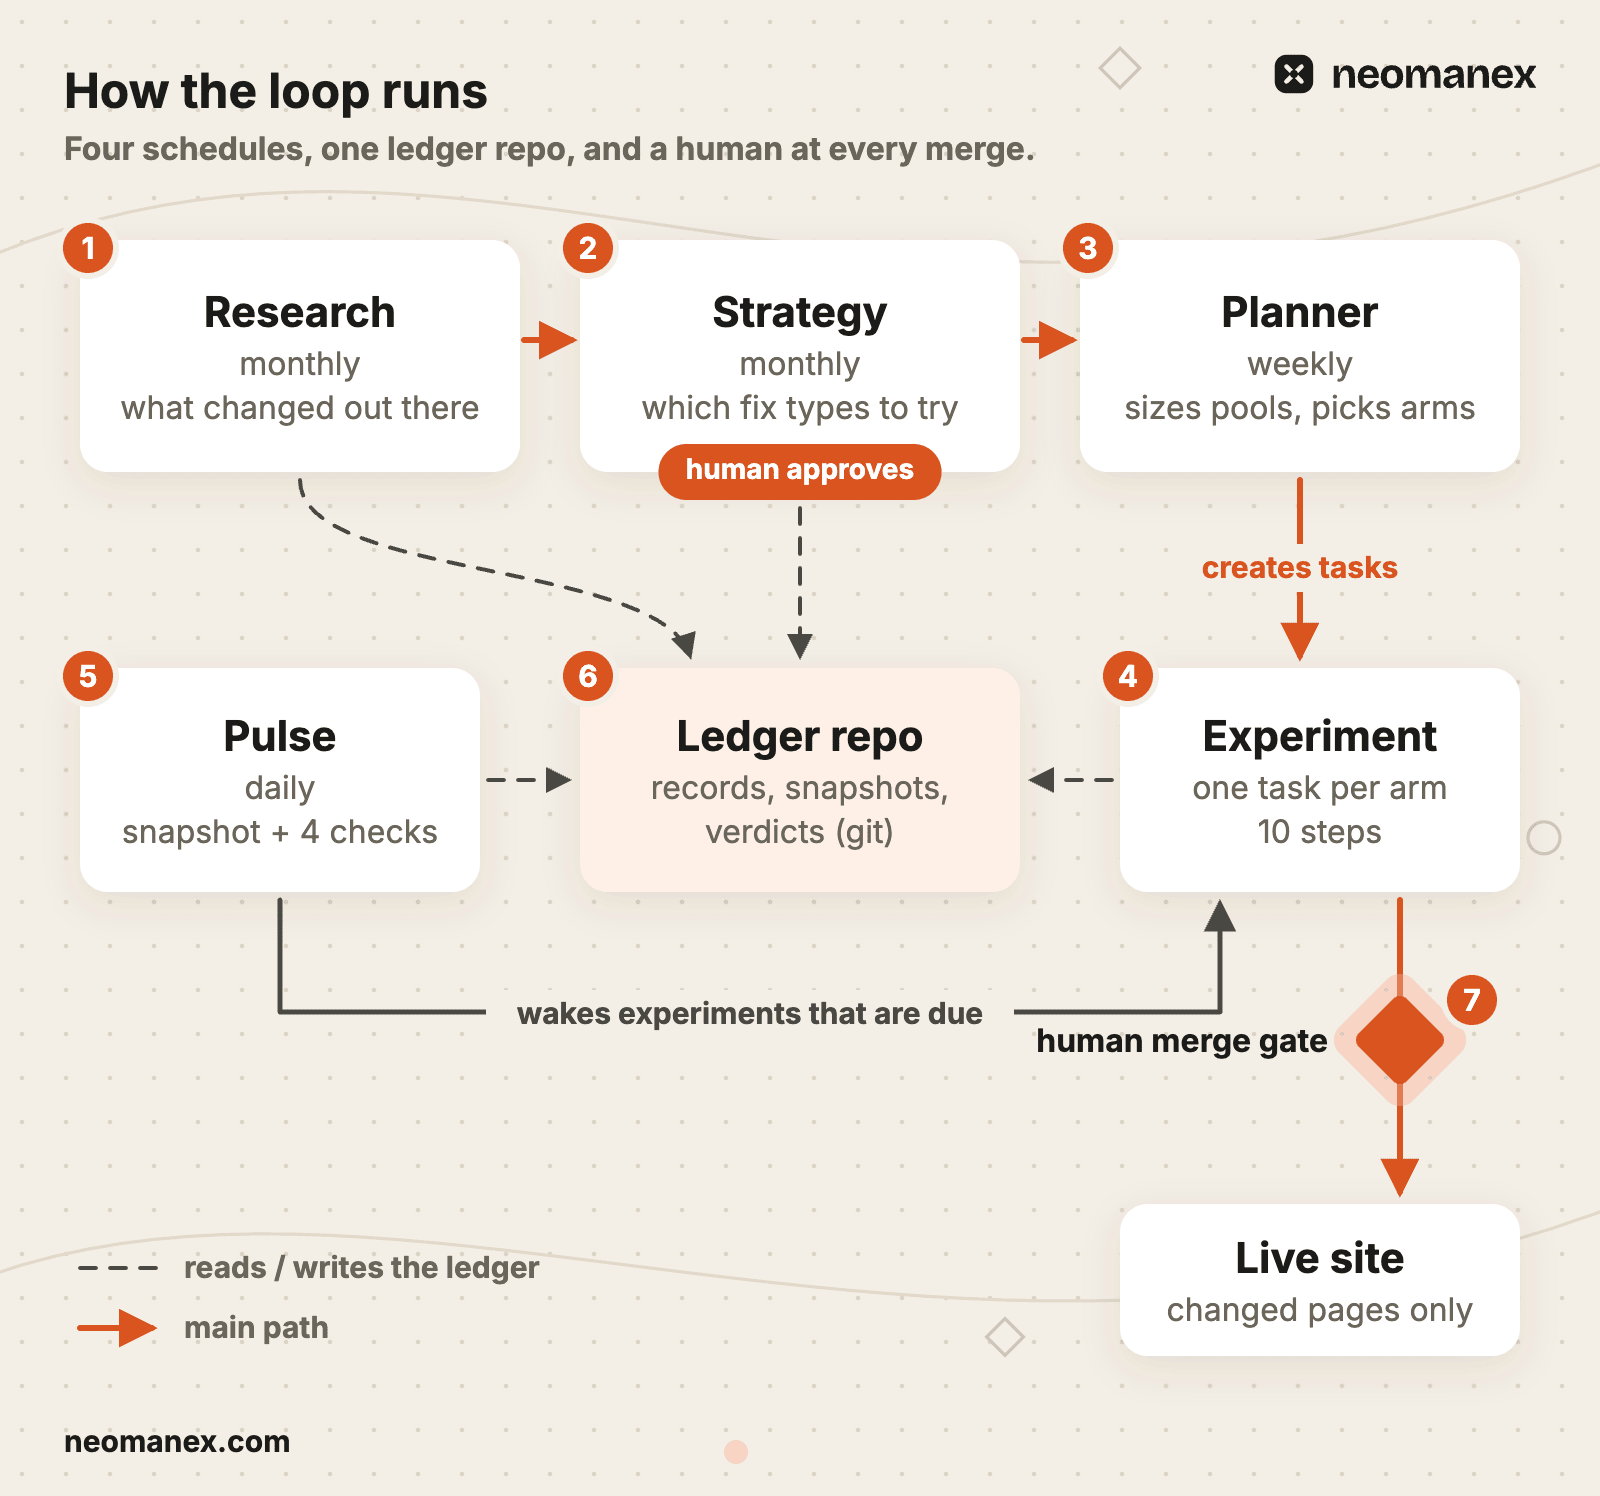
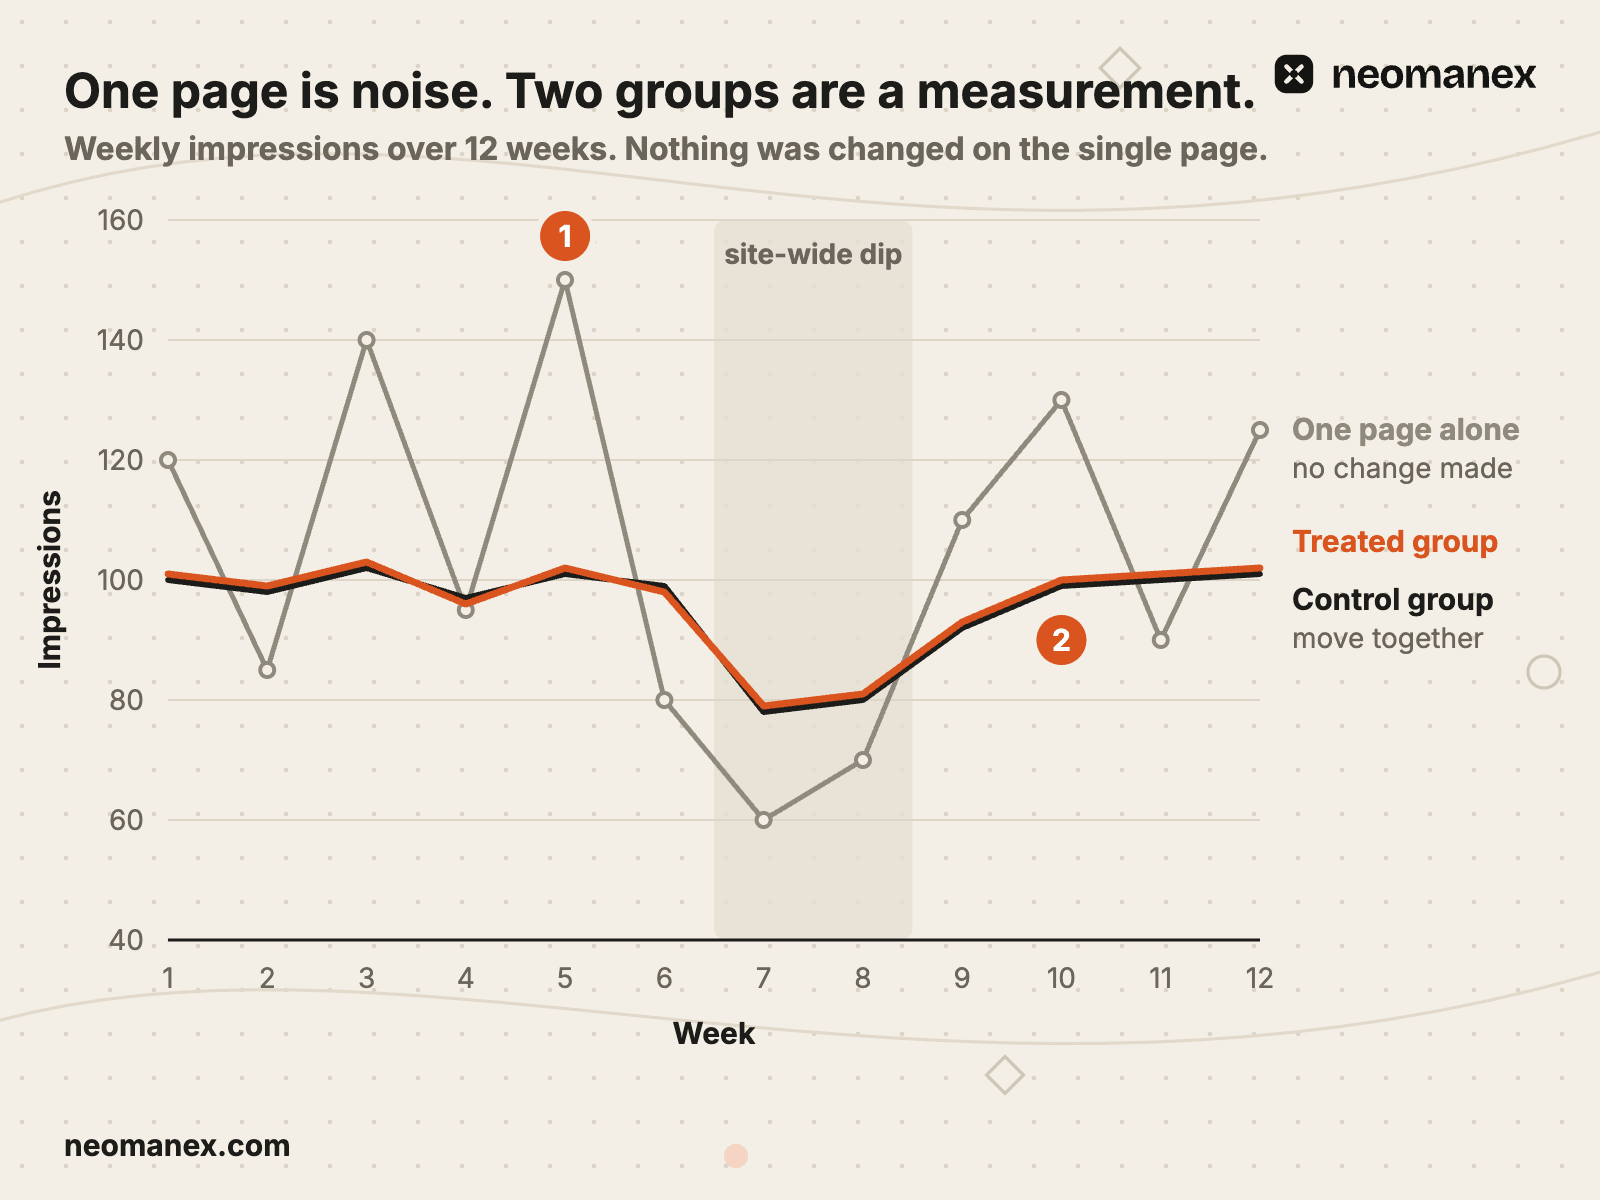
Quatre planifications la pilotent : un pouls quotidien, un planificateur hebdomadaire, et une recherche et une stratégie mensuelles.
Pourquoi nous l'avons construite : une page, c'est du bruit, et les agents inventent des chiffres
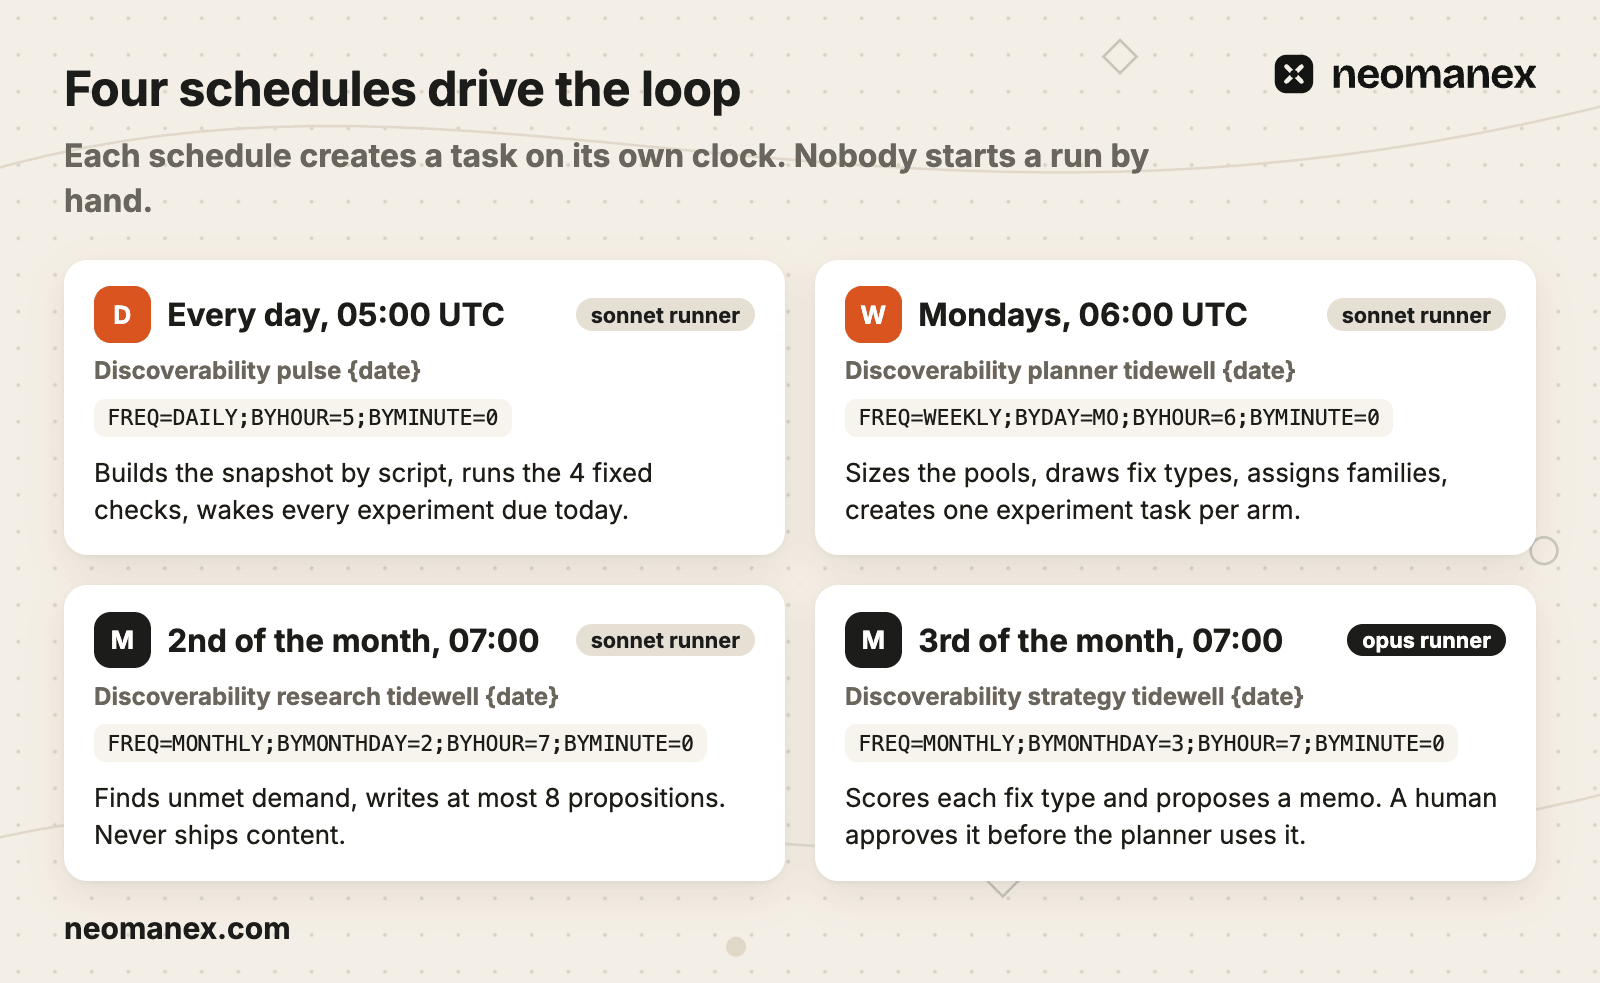
La plupart des tests SEO sur un petit site vous mentent : une page varie d'un tiers sans que rien n'ait changé. Les mises à jour de Google, la saisonnalité, le rythme d'exploration et les baisses à l'échelle du site font bouger une page d'eux-mêmes. Un graphique avant/après d'une seule page ne distingue pas une correction d'une semaine calme.
La réponse est un groupe témoin issu du même site, tiré au sort au même moment. Les deux groupes subissent les mêmes conditions : l'écart entre eux est donc l'effet. Selon les recommandations de Google sur les tests, la durée nécessaire à un test fiable dépend du trafic du site (Google Search Central, 2025(s’ouvre dans un nouvel onglet)). Cette boucle ne modifie jamais une URL et n'ajoute jamais de redirection, et un petit site dispose de 28 jours mesurés plus une prolongation.
Le second problème, c'est l'agent. Demandez à un agent de « vérifier les données » et il calcule des ratios, les compare à des références qu'il a inventées et recommande des modifications. Le nôtre a fait exactement cela. Un script calcule donc chaque métrique et chaque verdict, et Claude Code exécute les étapes et lit les résultats.
Si vous voulez une boucle planifiée comme celle-ci, avec des étapes, des contrôles et des validations humaines, découvrez comment ConvOps la fait tourner(s’ouvre dans un nouvel onglet).
Comment elle tourne : quatre planifications, cinq workflows
Une boucle d'expériences n'est honnête que si son horloge l'est : rien ici n'attend qu'une personne s'en souvienne.
| Planification | Quand (UTC) | Ce qu'elle fait |
|---|---|---|
| Pouls | Tous les jours à 5 h | Fait construire par un script un instantané des données Search Console d'il y a trois jours (elles sont généralement disponibles au bout de 2 à 3 jours, Google Search Central, 2025(s’ouvre dans un nouvel onglet)), exécute quatre vérifications fixes, réveille chaque expérience arrivée à échéance ce jour-là, signale celles qui sont bloquées |
| Planificateur | Chaque lundi à 6 h | Dimensionne les pools, choisit les types de correction, affecte les familles, crée une tâche d'expérience par bras |
| Recherche | Le 2 de chaque mois à 7 h | Repère la demande non satisfaite, rédige au plus 8 propositions, ne publie jamais de contenu |
| Stratégie | Le 3 de chaque mois à 7 h | Évalue chaque type de correction et propose une note de stratégie à faire approuver par une personne |
Le planificateur n'utilise qu'une note de stratégie dont la tâche d'approbation est terminée. Sans elle, il conserve ses valeurs par défaut. Une note de stratégie oriente des semaines d'expériences : une personne la signe donc.
Un pool est l'ensemble des familles sur lesquelles une métrique est mesurable : passages des robots d'IA, impressions Google, position ou taux de clics. Un bras est un type de correction appliqué à un groupe de familles de pages. Une vague est l'ensemble des bras lancés ensemble un même lundi, partageant un même groupe témoin.
Chaque bras est une tâche à part entière avec un workflow de 10 étapes, un graphe d'étapes et de contrôles, la forme que nous décrivons dans Qu'est-ce que le graph engineering ?.
| Étape | Exécutée par | Condition |
|---|---|---|
| Enregistrement | Claude Code | Un vrai type de correction et une fiche committée, sinon arrêt |
| Mise en œuvre | Claude Code | Une seule variable, familles traitées uniquement, vérifications produit réussies |
| Revue statique | Claude Code | Diff limité aux pages traitées, longueur du titre et de la meta description, un seul H1. Deux rejets ouvrent un bug |
| Livraison | Une personne | Une personne ouvre et fusionne la modification |
| Mise en ligne (jour 0) | Claude Code | Traitement vérifié dans le HTML de production. Pas en ligne sous 14 jours : annulée |
| Point intermédiaire (jour 15) | Script de verdict, lu par Claude Code | Retour arrière en cas d'effet néfaste, annulation en cas de mise à jour de Google, arrêt anticipé sur un succès net des passages IA, sinon poursuite jusqu'au jour 31 |
| Bilan final (jour 31) | Script de verdict, lu par Claude Code | Succès, échec ou non concluant |
| Retour arrière | Claude Code, puis une personne | Retour arrière sur une branche, une personne fusionne, l'exécution suivante confirme qu'il est en ligne |
| Action | Claude Code | Un succès ouvre une idée de réplication, jamais une nouvelle expérience |
| Enseignement | Claude Code | Une ligne d'enseignement dans la fiche |
Chaque fusion attend une personne, le contrôle humain décrit dans Concevoir des systèmes d'IA avec humain dans la boucle.
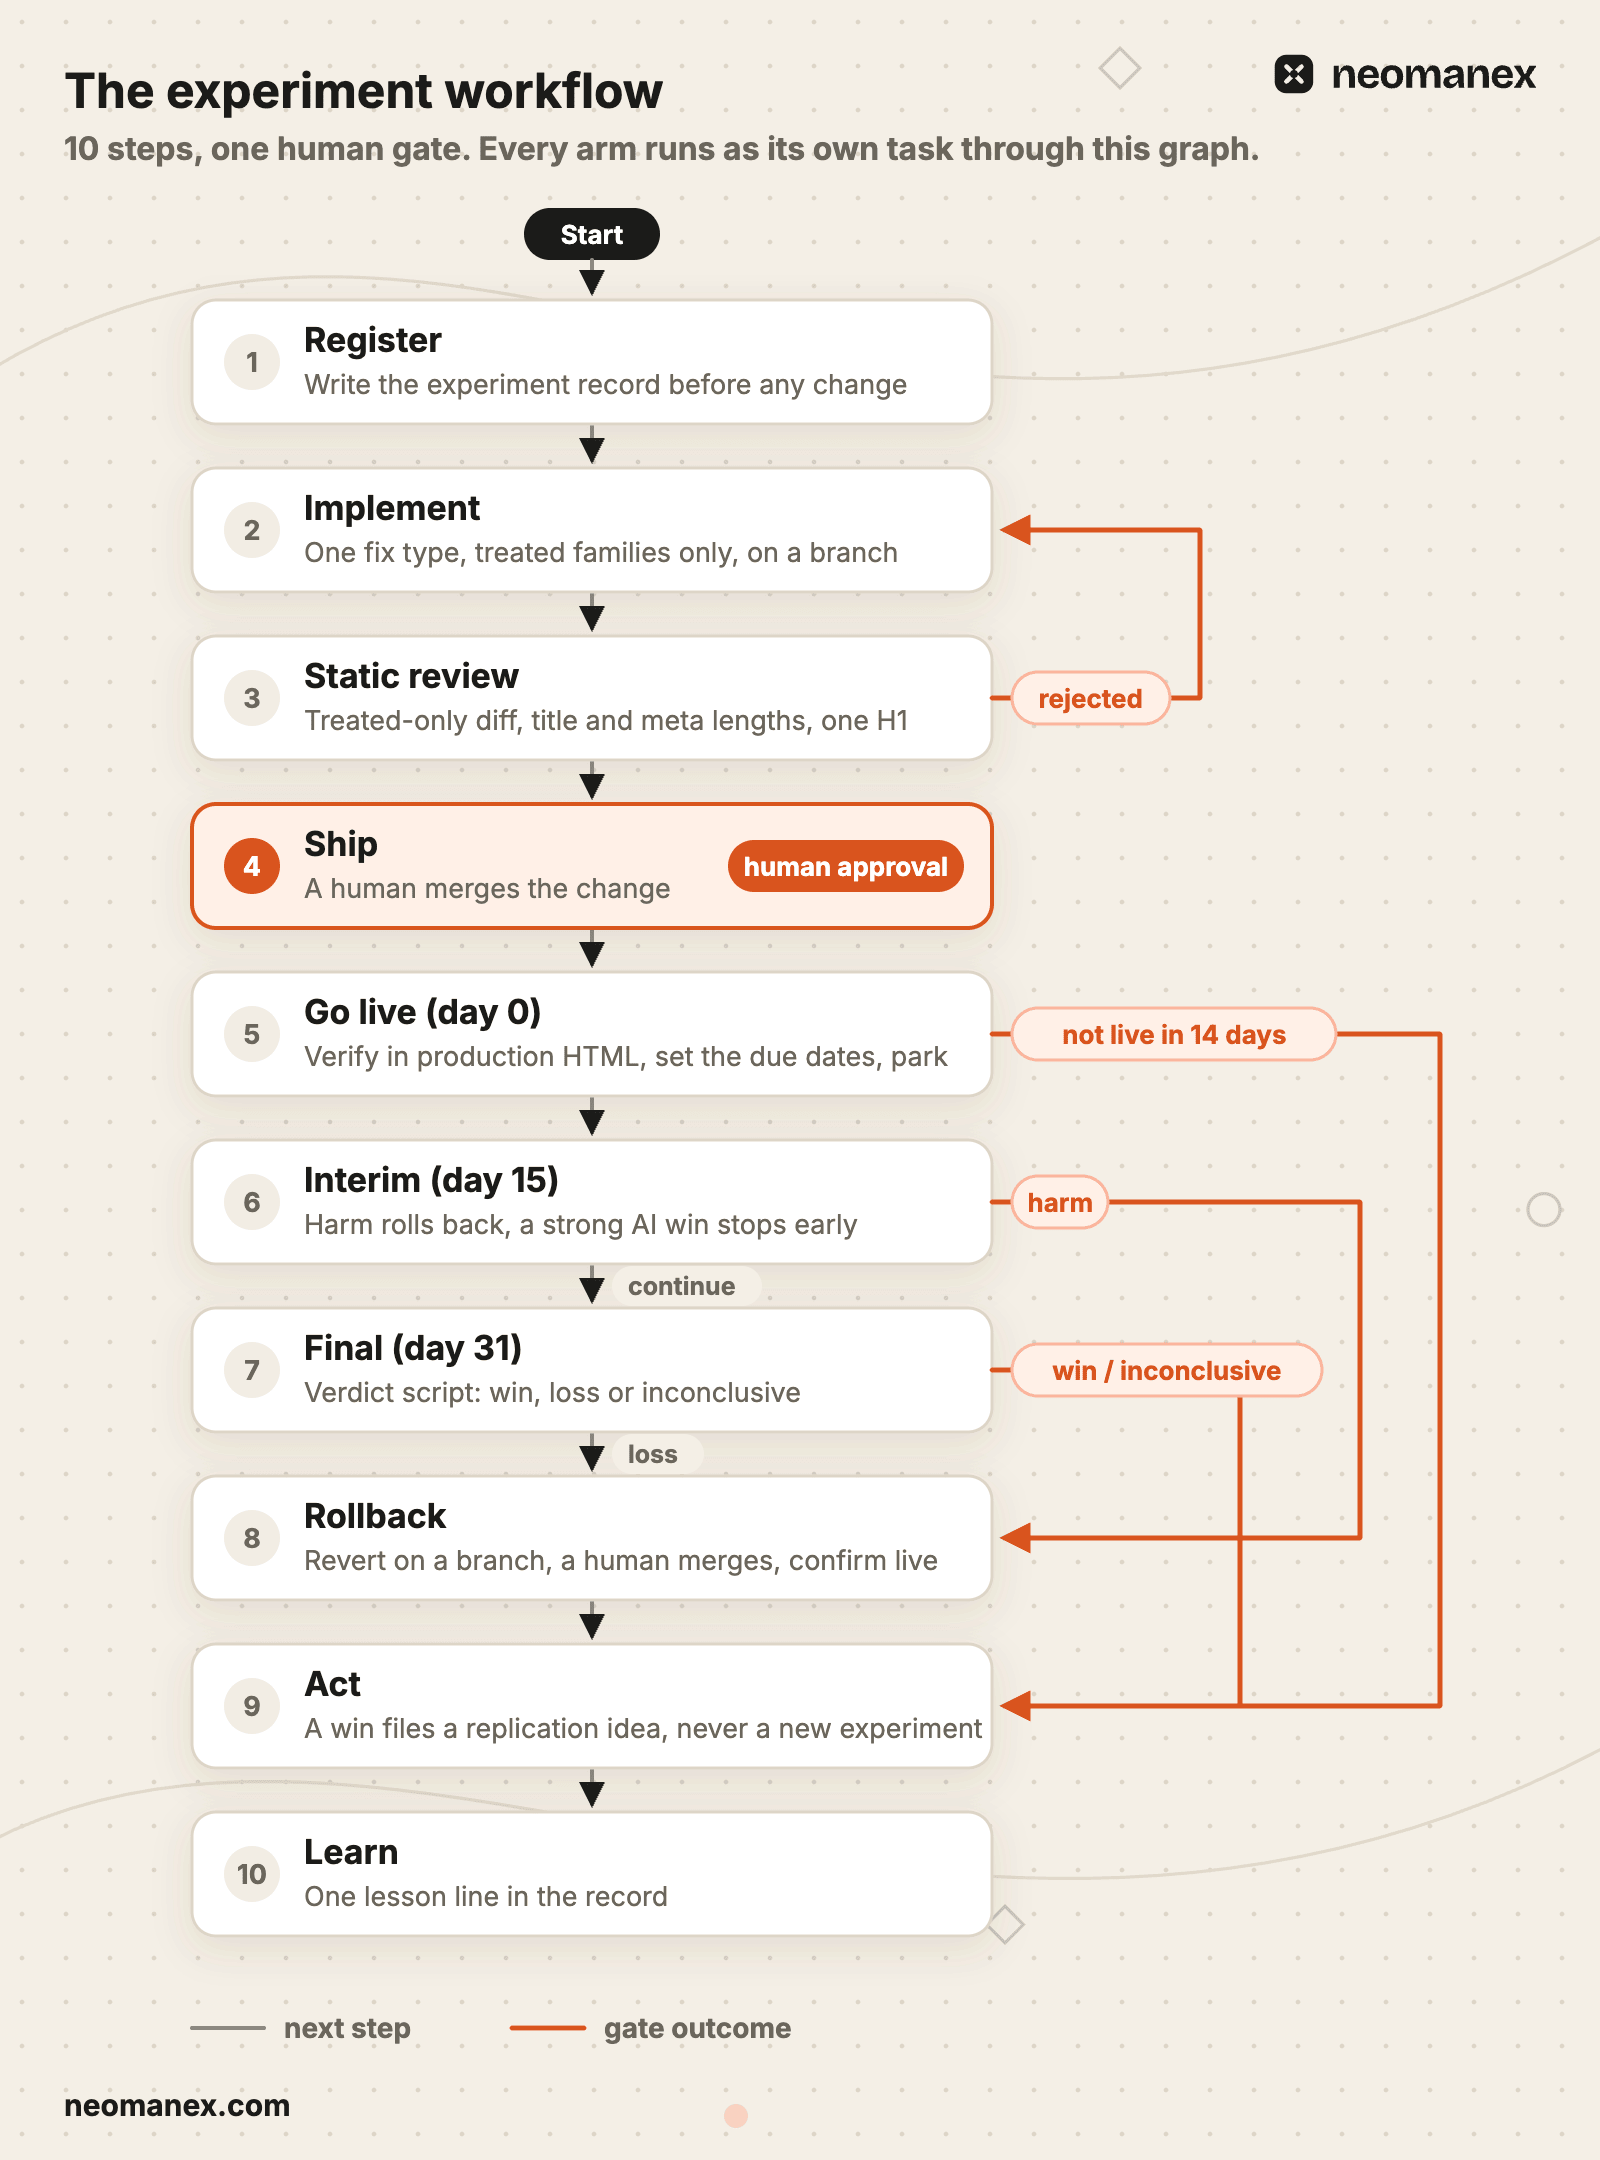
Entre deux points de mesure, la tâche est mise en sommeil jusqu'à son échéance et le pouls quotidien la réveille.
Notre boucle de site web autoréparateur applique le même schéma à la QA du site : un balayage hebdomadaire ouvre des bugs, et chaque bug a sa propre exécution de réparation, fermée seulement après une revérification.
Une exécution, étape par étape (données d'exemple)
Voici une exécution complète de Tidewell, du planificateur du lundi au verdict du jour 31.
Lundi : le planificateur ouvre une vague
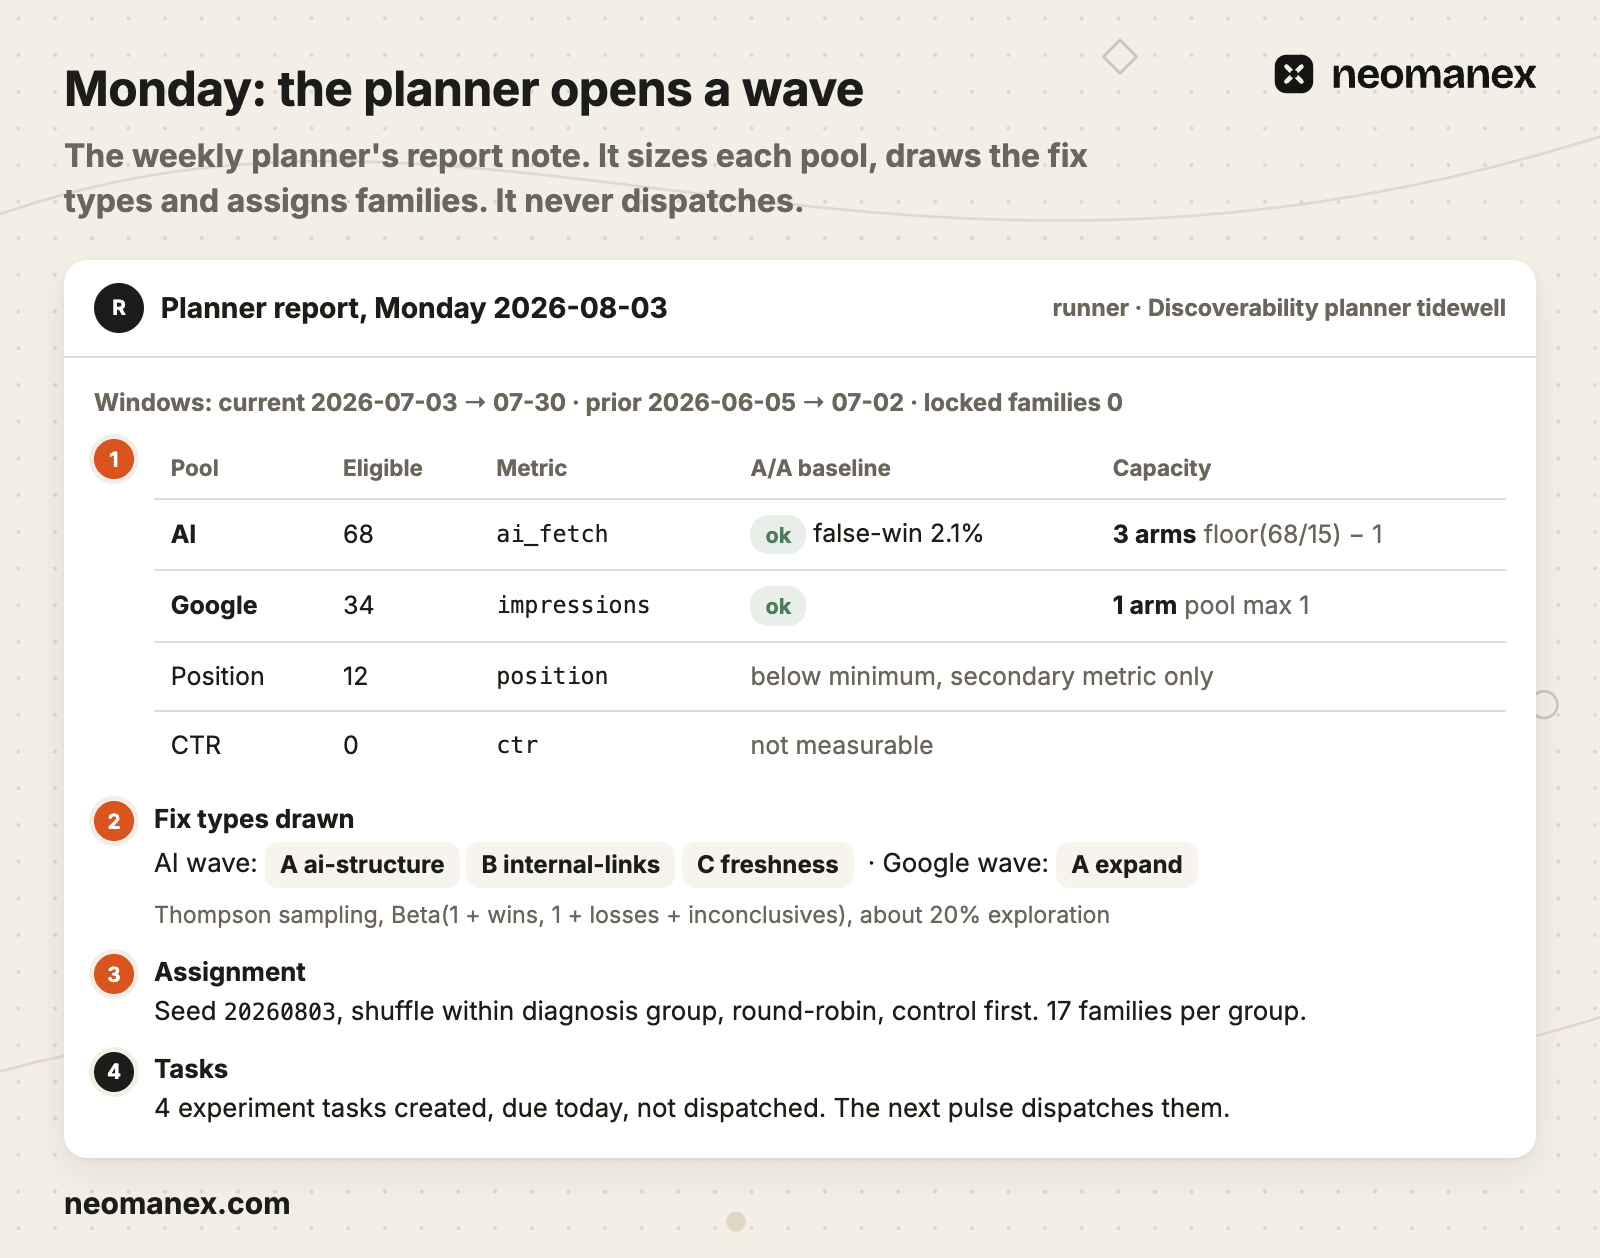
Le planificateur compte les familles éligibles et la capacité en bras par pool (repère 1). La capacité est le nombre de familles éligibles divisé par 15, arrondi à l'inférieur, moins un : les 68 familles du pool IA de Tidewell permettent 3 bras. Le pool Google est plafonné à 1 bras, et chaque pool ne fait tourner qu'une vague active à la fois.
Un pool n'obtient une vague que si sa base de référence A/A historique est bonne. Cette base rejoue des données passées avec de fausses répartitions et compte combien de fois le bruit seul ressemble à un succès (2,1 % dans l'exemple). Un pool qui échoue n'obtient pas de vague, car tout verdict y serait du bruit.
Les types de correction qui ont le plus gagné sont tirés plus souvent (repère 2), environ 20 % des bras étant réservés aux types de correction sans verdict (échantillonnage de Thompson, Beta(1 + succès, 1 + échecs + non concluants)).
L'affectation utilise la date comme graine aléatoire, mélange au sein de chaque groupe de diagnostic et distribue les familles à tour de rôle, en commençant par le témoin (repère 3). Chaque groupe reçoit 17 familles. C'est le pouls suivant, et non le planificateur, qui répartit les quatre tâches.
Enregistrement : la fiche d'abord
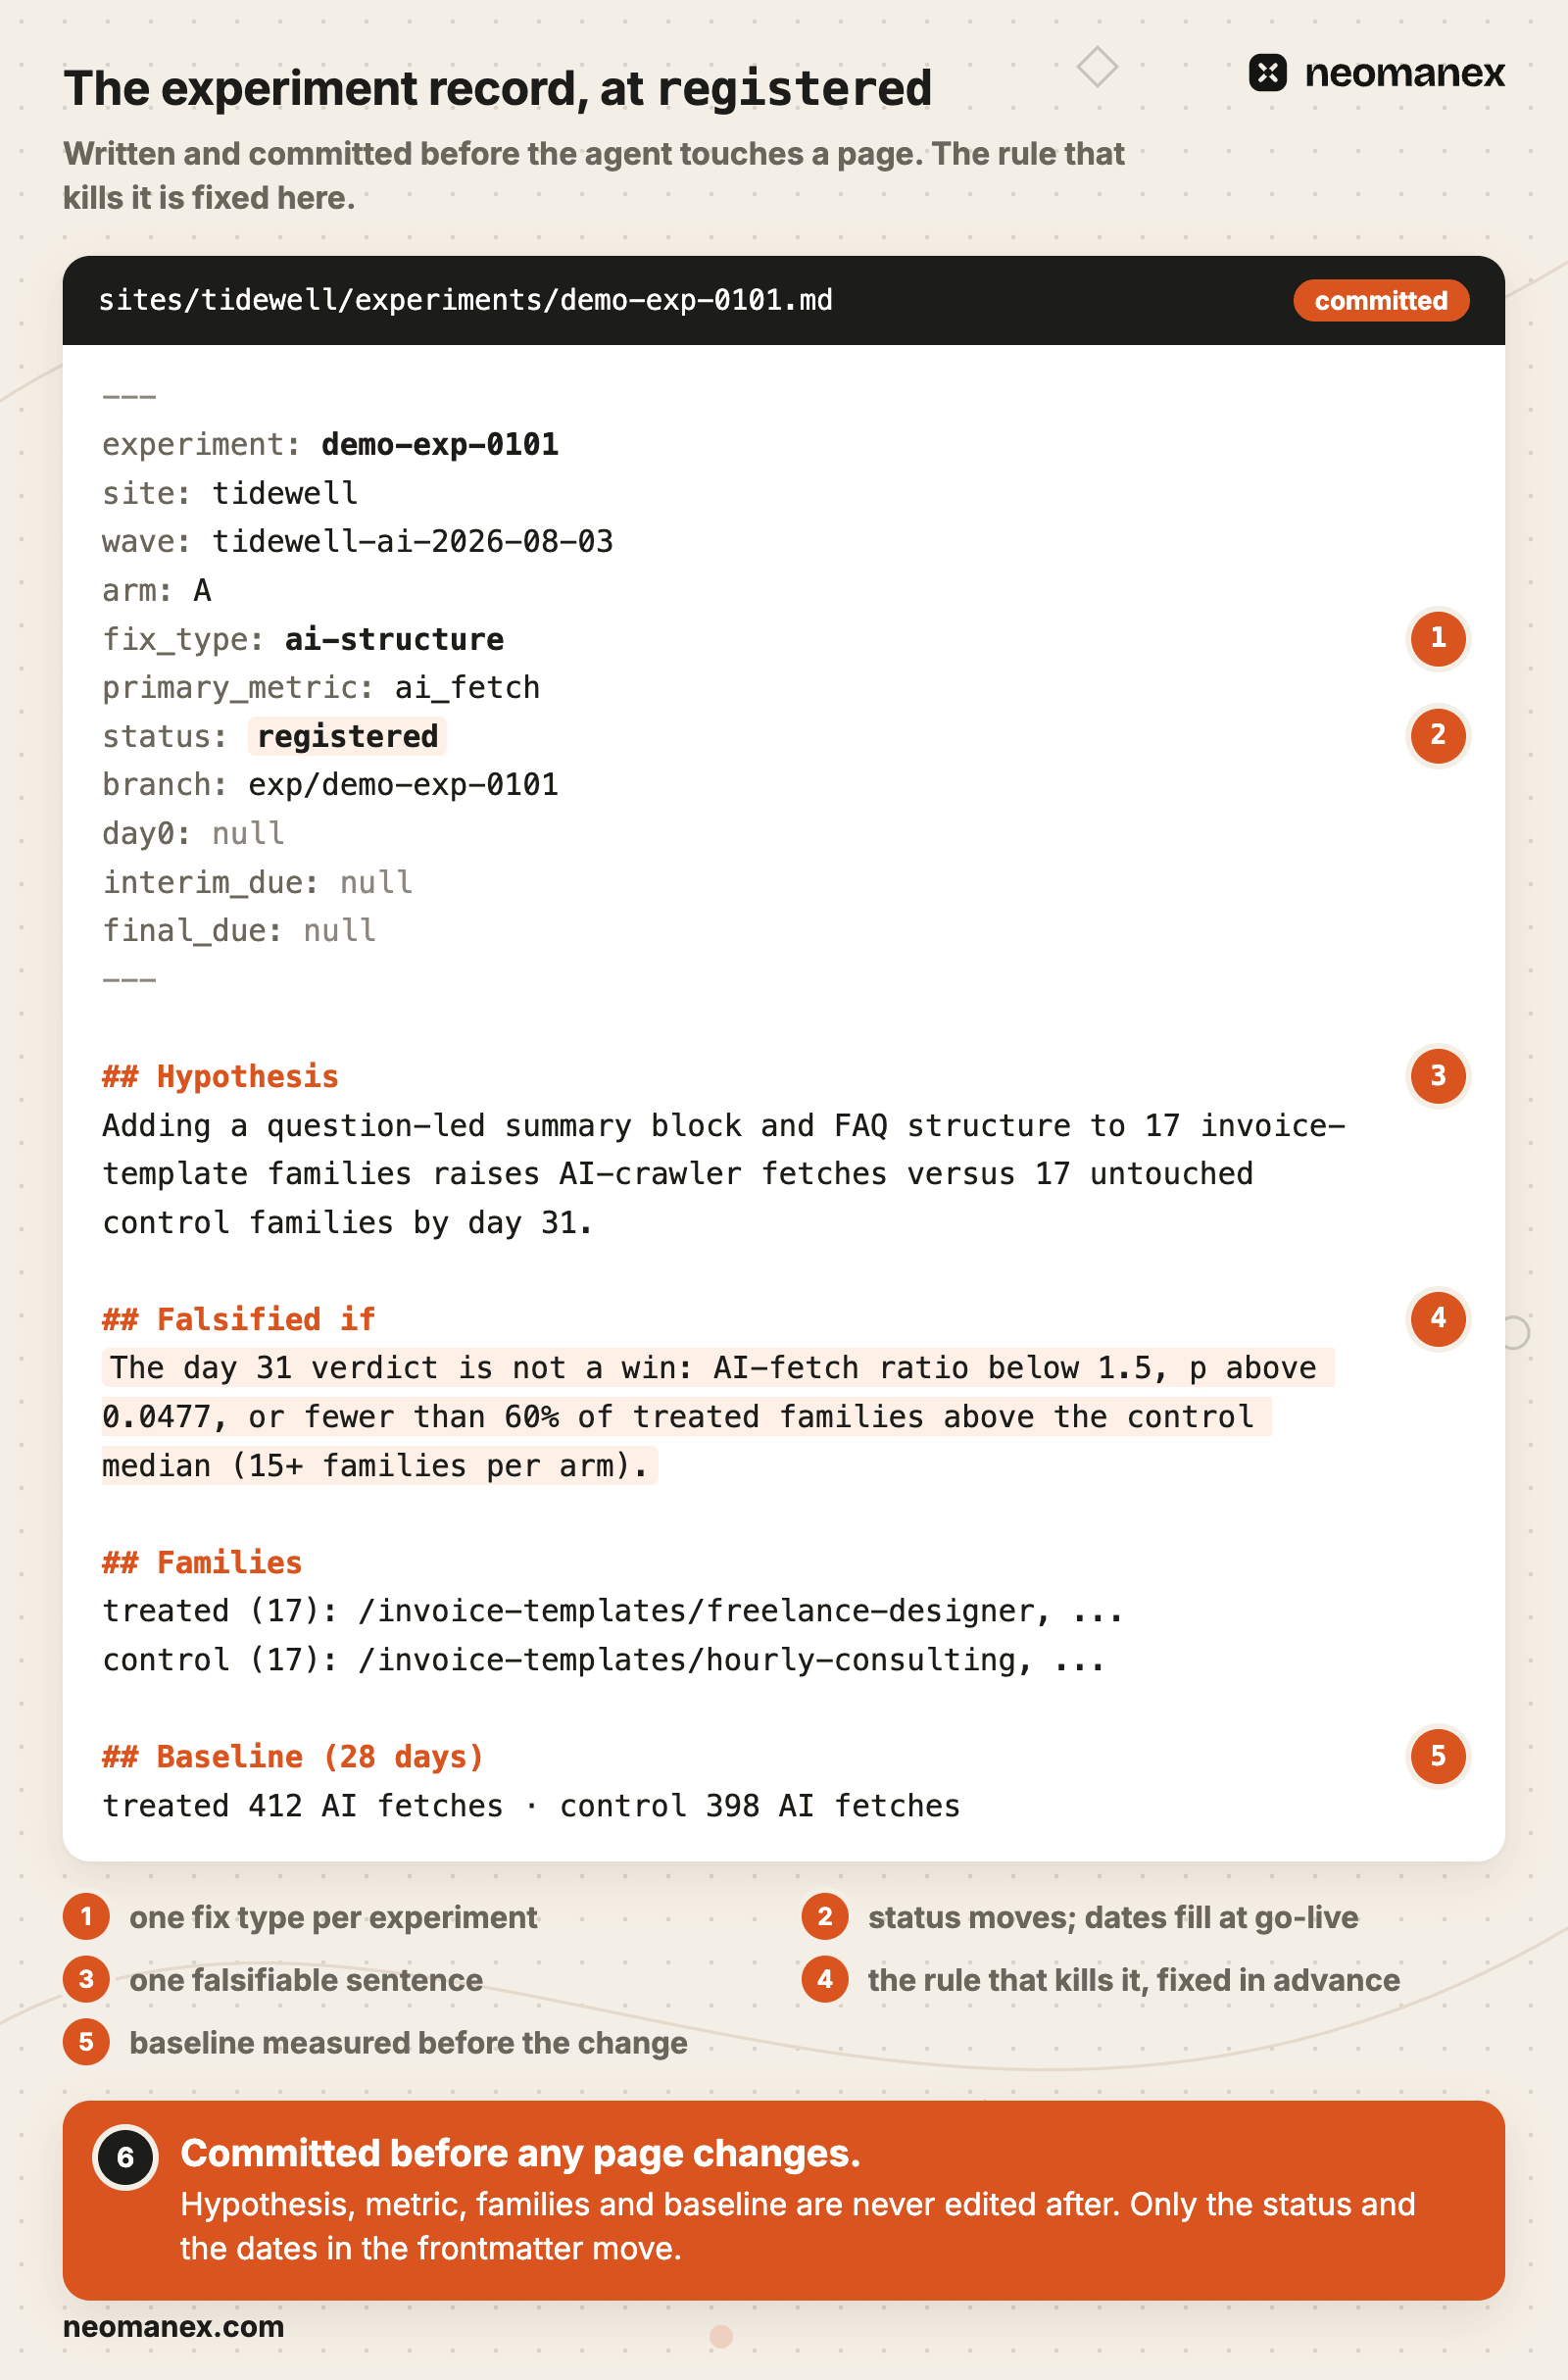
La fiche contient un seul type de correction (repère 1), une phrase réfutable (3), la règle qui la réfute (4) et une base de référence de 28 jours (5). Après le commit, seuls le statut et les dates évoluent. Nous pré-enregistrons parce qu'un agent, comme une personne, peut trouver une histoire dans n'importe quel chiffre après coup ; une règle de réfutation committée ne laisse rien à réinterpréter.
Mise en œuvre, revue, livraison, mise en ligne
Sur le bras A, Claude Code ajoute un résumé introduit par une question et un bloc FAQ aux 17 familles traitées de modèles de factures. C'est l'unique variable. Il ne touche jamais aux URL, aux slugs, aux redirections, à la mise en page commune ni aux faits, et il met à jour la date sur chaque page modifiée. La revue statique passe ; une personne fusionne. Voici le bras B de la même vague, mis en sommeil après la mise en ligne.
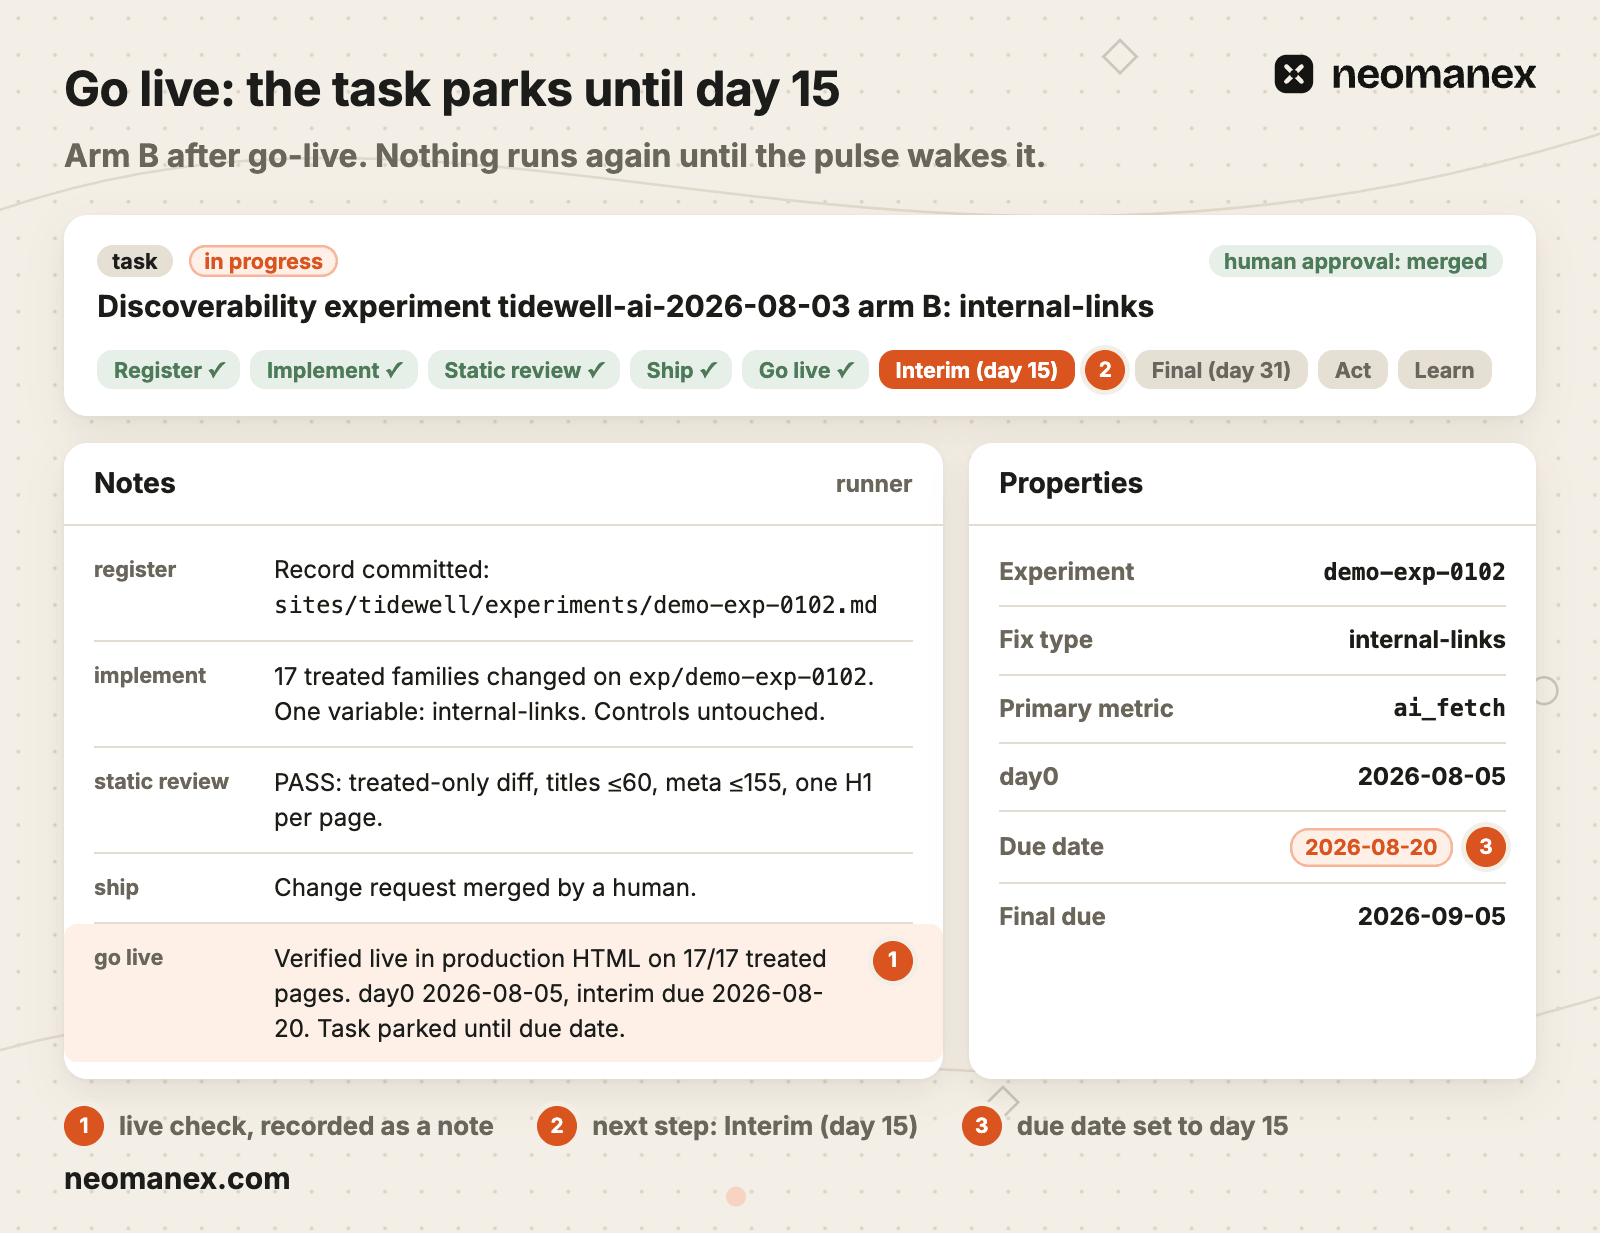
La mise en ligne vérifie le traitement dans le HTML de production sur les 17 pages (repère 1). Google indique que l'exploration peut prendre de quelques jours à quelques semaines (Google Search Central, 2025(s’ouvre dans un nouvel onglet)) : le jour 0 est donc le jour où la modification est vérifiée en ligne, pas le jour de la fusion. La mise en ligne fixe le jour 0 et les deux échéances, puis met la tâche en sommeil jusqu'au jour 15 (repères 2 et 3).
Jour 15 et jour 31 : un script décide
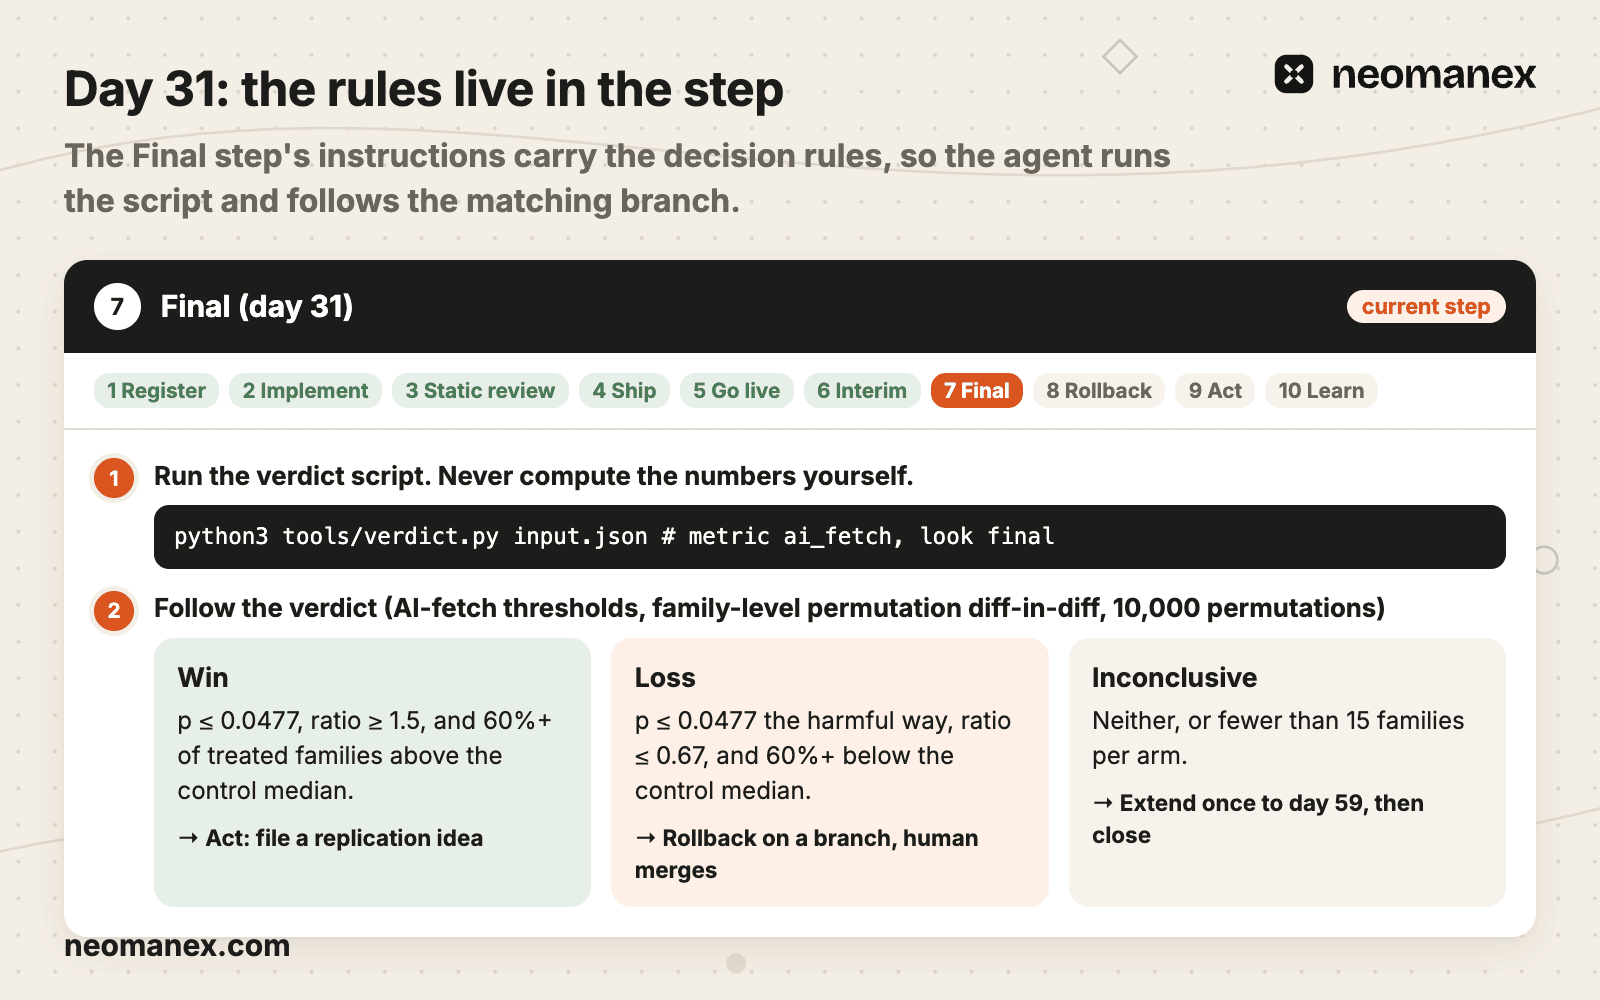
Les règles de décision figurent dans les instructions de l'étape (repère 2) : l'agent ne peut pas les discuter. Il lance le script de verdict et suit la branche correspondante.
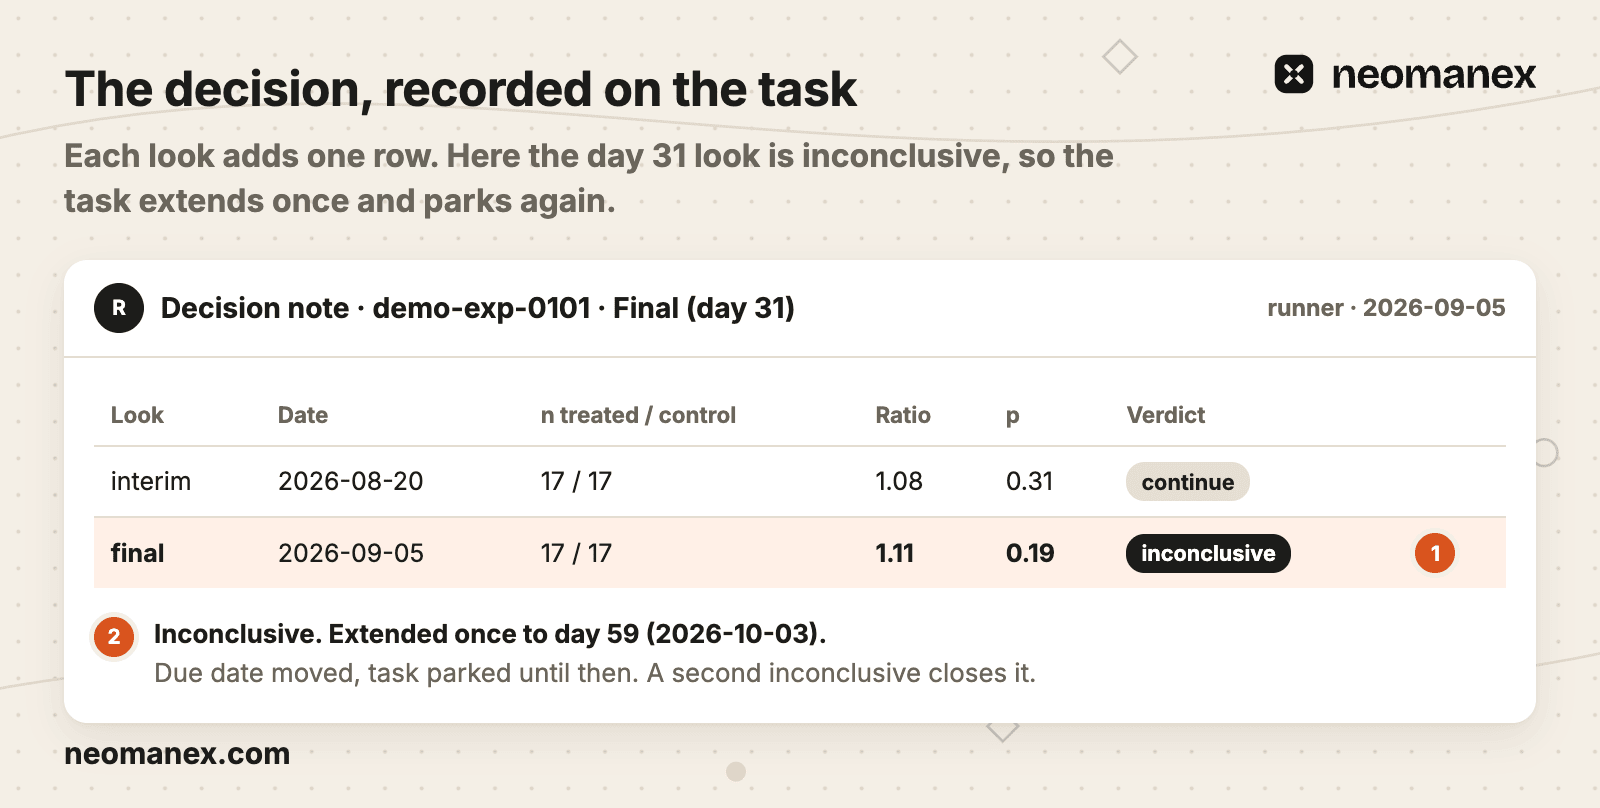
Au jour 15, le script indique un ratio de 1,08, p 0,31 : pas d'effet néfaste, pas de succès anticipé, on continue. Au jour 31, il indique un ratio de 1,11, p 0,19 (repère 1) : non concluant, la tâche est donc prolongée une fois jusqu'au jour 59 et remise en sommeil.
À quoi ressemble la sortie : le registre
C'est le registre, et non un graphique de trafic, que produit cette boucle.
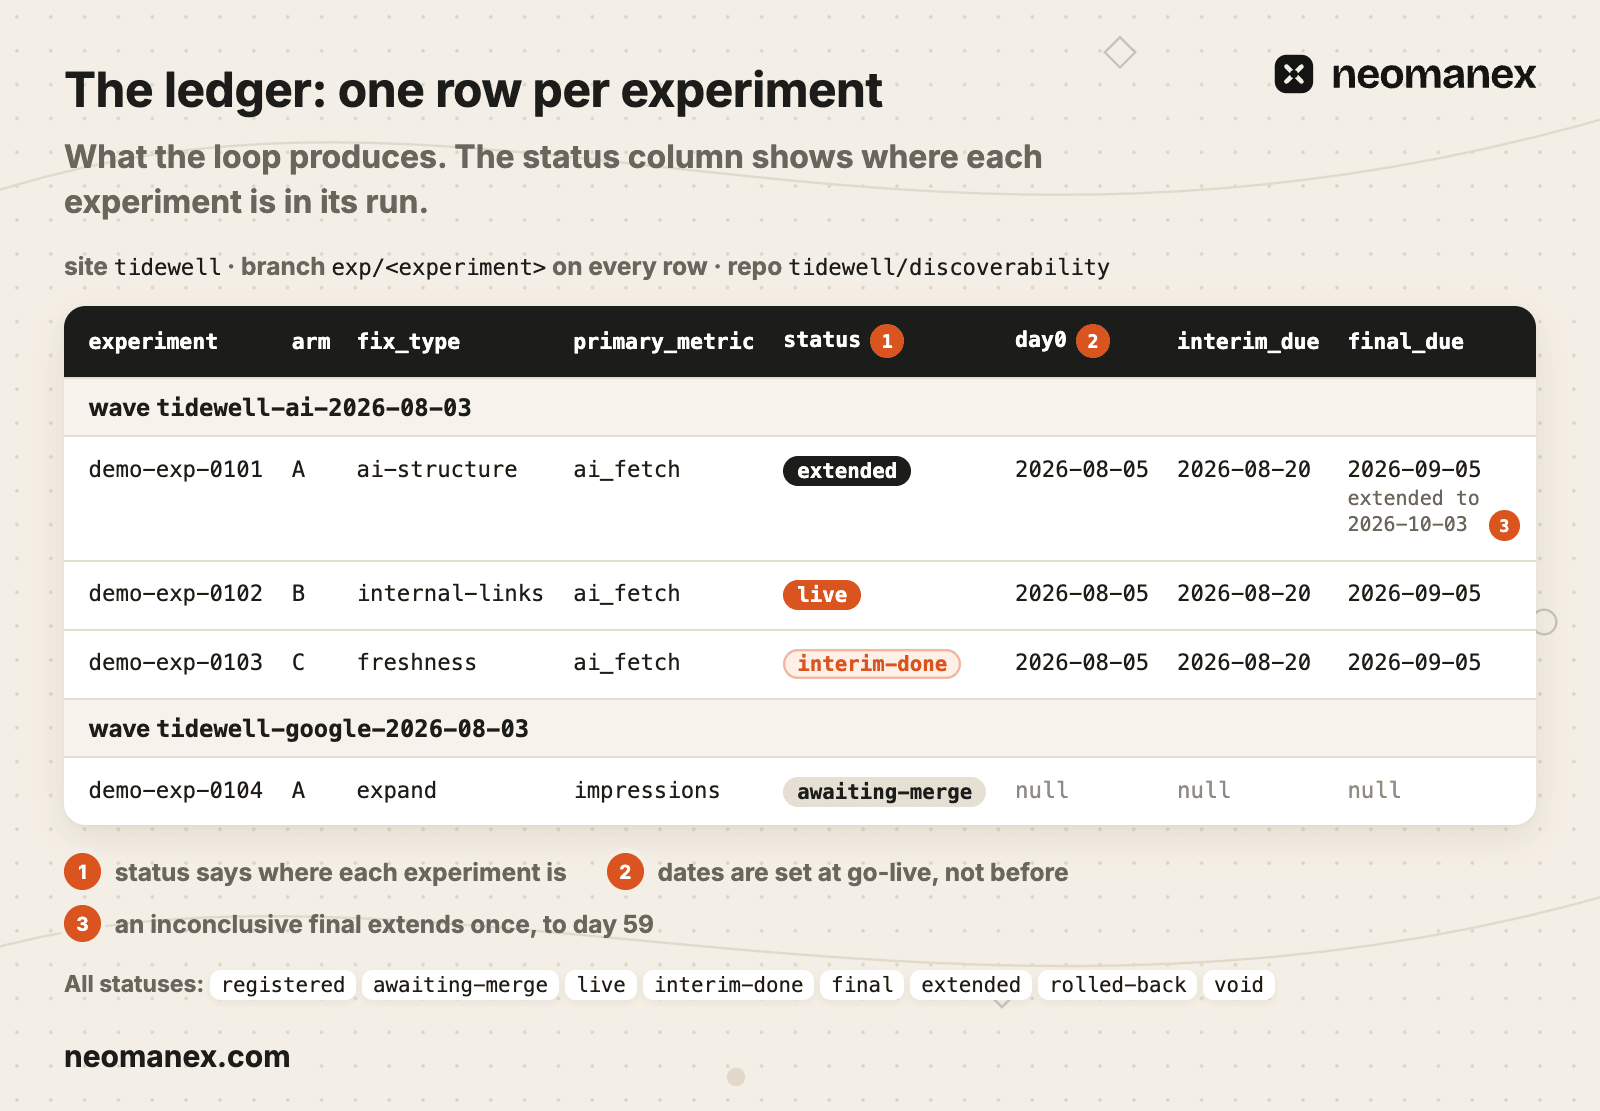
Une expérience passe par les statuts registered, awaiting-merge, live, interim-done et final, et peut se terminer en extended, rolled-back ou void. Chaque bras est une tâche à part entière avec son propre verdict.
Le script de verdict effectue une différence de différences par permutation au niveau des familles, sur 10 000 tirages. Le ratio est la variation du groupe traité divisée par celle du groupe témoin sur la même fenêtre : 1,5 signifie que le groupe traité a progressé de 50 % de plus que le témoin. Pour les passages IA (chaque métrique a ses propres seuils), un succès exige p ≤ 0,0477 au jour 31, un ratio de 1,5 ou plus, et au moins 60 % des familles traitées au-dessus de la médiane du témoin. Au jour 15, un résultat sur les passages IA à p ≤ 0,0074 qui respecte aussi les règles de ratio et de part arrête le bras de façon anticipée : il est définitif et passe directement à l'action. Un échec en est l'image inversée (ratio de 0,67 ou moins, 60 % sous la médiane), et le retour arrière suit. Tout le reste, ou moins de 15 familles par bras, est non concluant.
Les deux seuils de p répartissent un même budget de 5 % de faux succès entre les deux points de mesure : s'arrêter tôt au jour 15 n'ajoute donc aucun faux succès. Le ratio et la part de 60 % écartent un résultat statistiquement réel mais minuscule, ou porté par une seule grosse page.
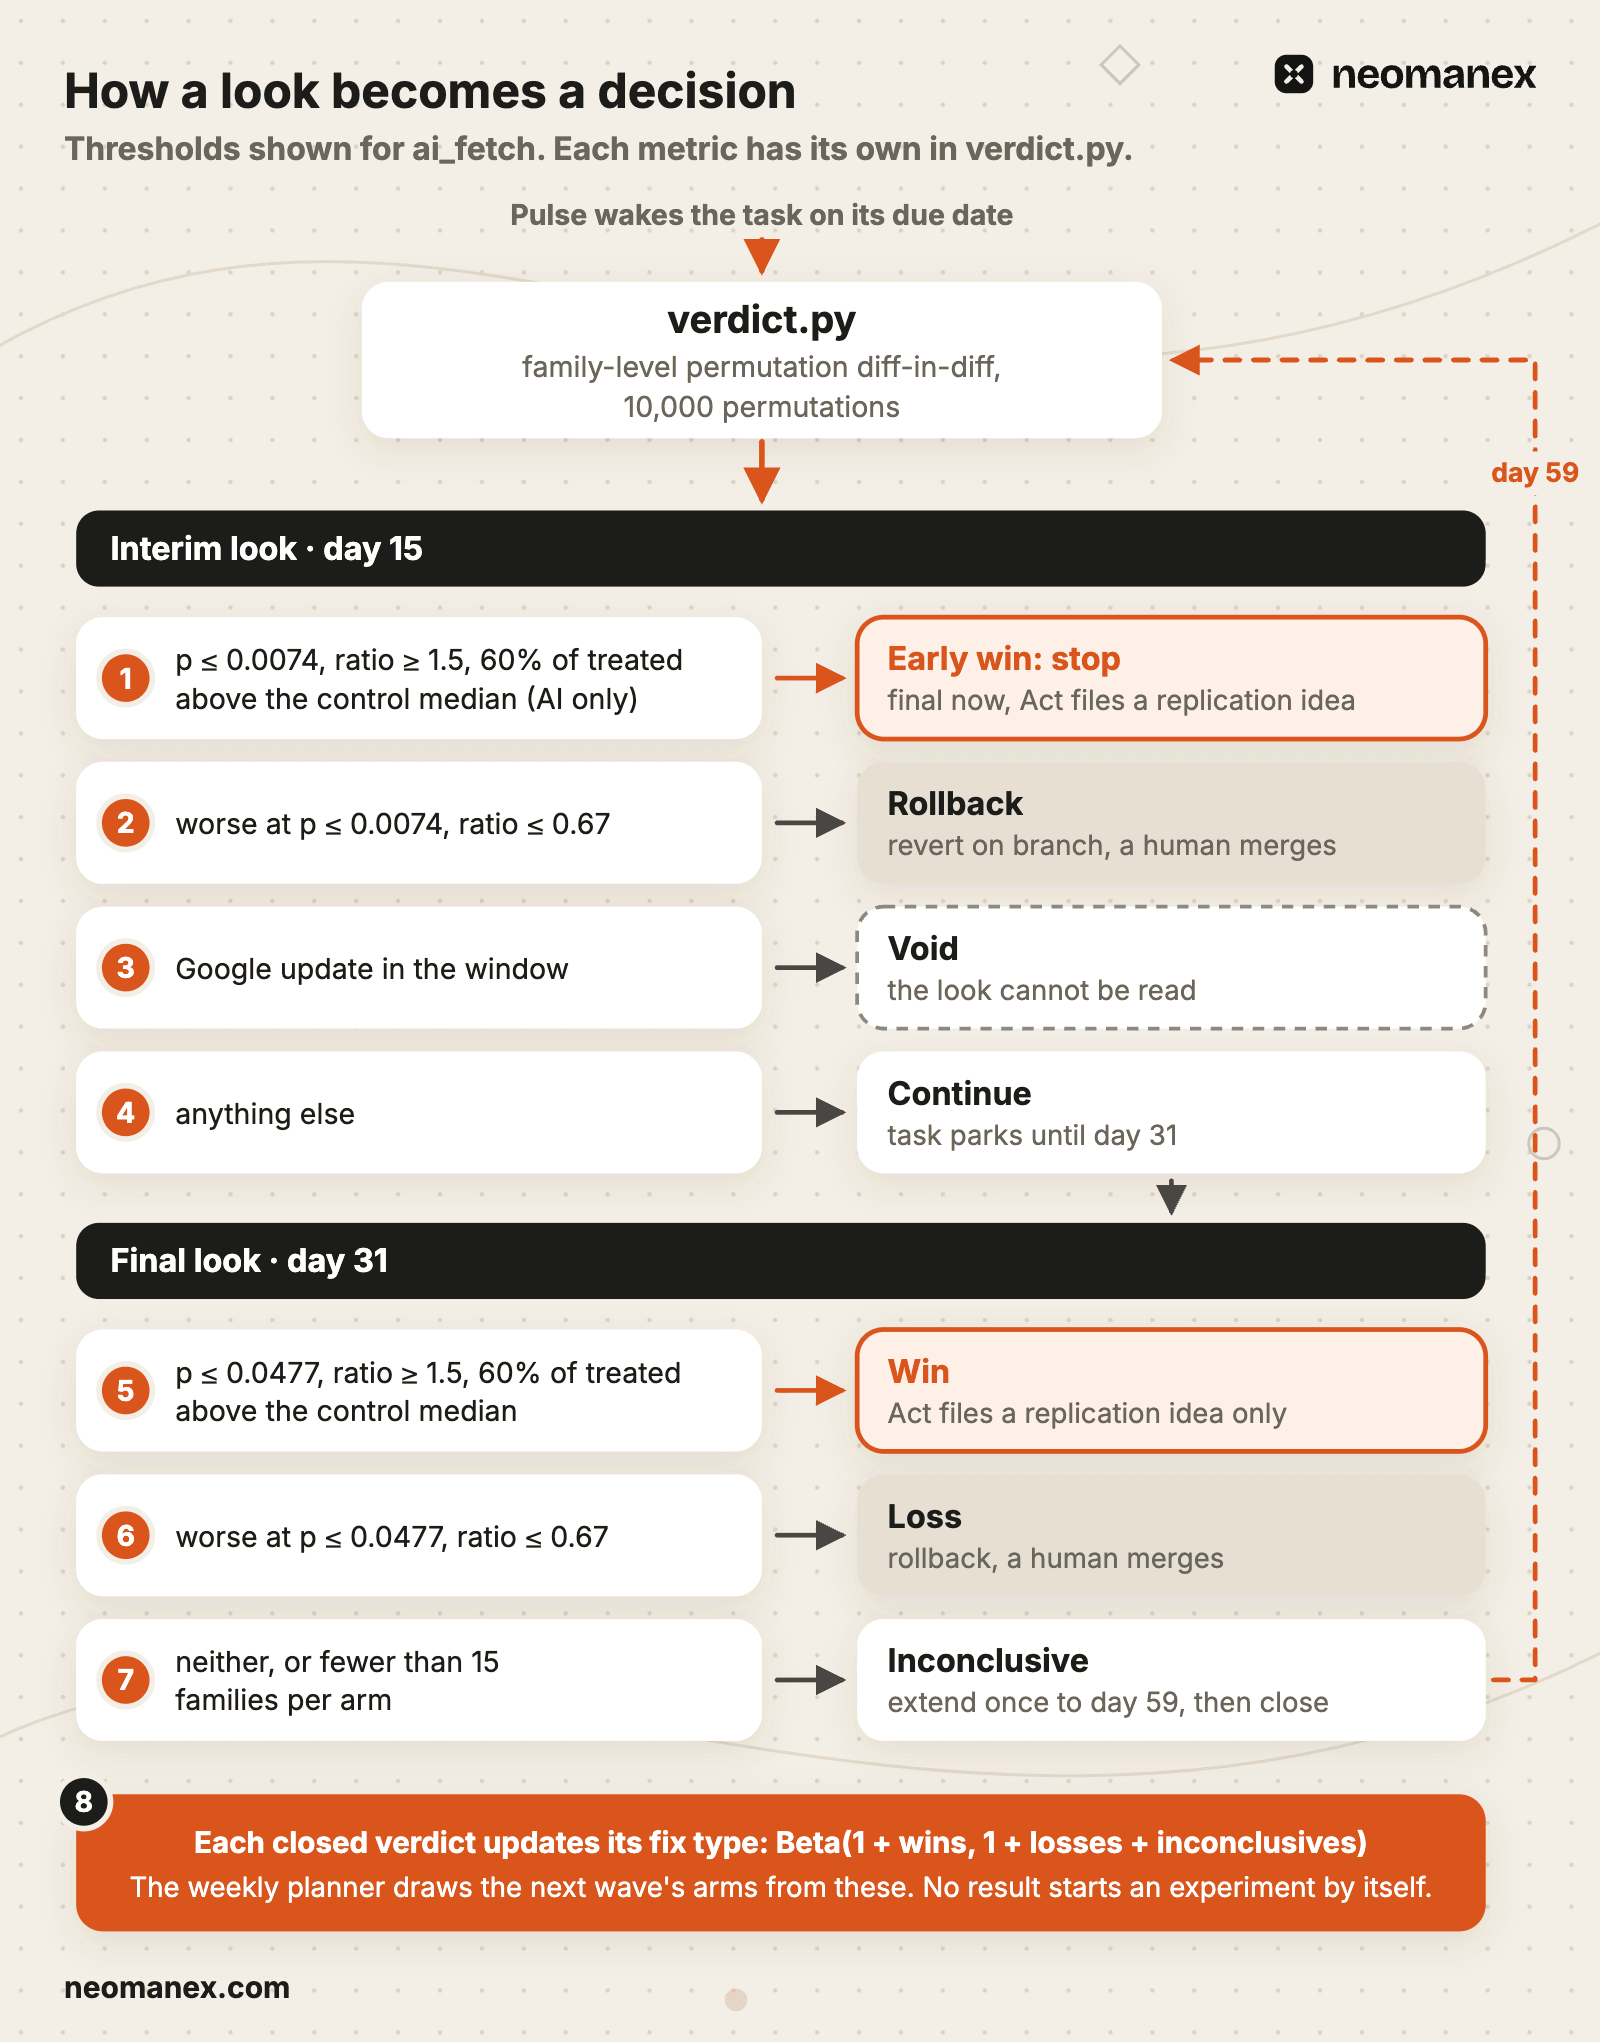
Non concluant n'est pas un échec. Cela signifie que l'effet, s'il existe, est plus petit que ce que ce site peut détecter. La tâche est prolongée une fois jusqu'au jour 59 puis se ferme, car un test qu'on laisse tourner jusqu'à ce qu'il gagne finit par gagner sur du bruit. Un succès ne génère pas non plus de nouvelles expériences. Il ouvre une idée de réplication pour une personne, car un budget de 5 % de faux succès signifie que certains succès sont du bruit, et seule une seconde exécution sur de nouvelles familles permet de les distinguer.
Ce qui tourne mal : l'agent qui a inventé une crise
Notre pire matinée est venue d'un agent qui voulait bien faire. Notre vérification quotidienne a sauté sa liste de contrôles et rédigé son propre rapport. Elle a calculé un taux de clics, l'a comparé à une « norme du secteur » que personne ne lui avait fournie, l'a étiqueté CRITIQUE, a recommandé des modifications et cité des bugs de suivi qui n'avaient jamais été ouverts. Chaque chiffre semblait plausible. Aucun ne venait d'une vérification définie. Nous avons archivé le rapport et réécrit l'étape le jour même. La voici transposée sur les données de Tidewell.
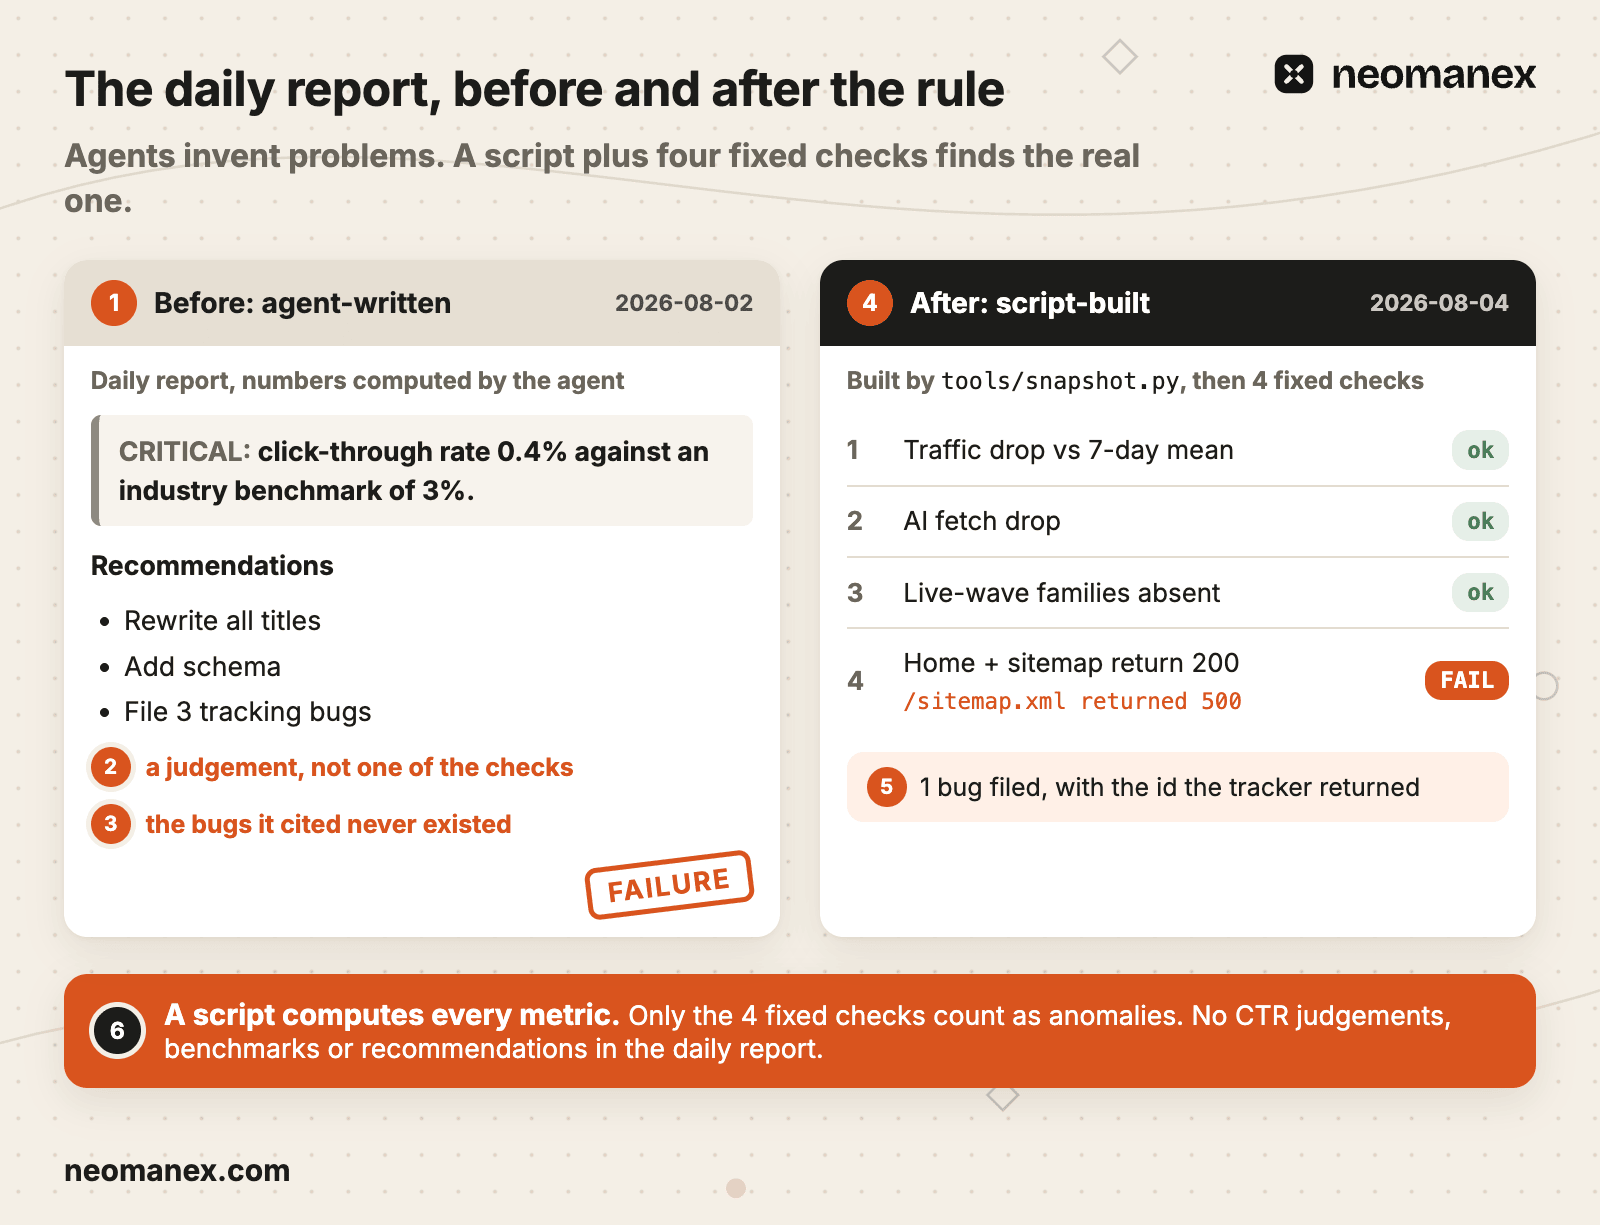
La règle qui en est sortie a deux volets. D'abord, un script construit l'instantané, et l'agent ne calcule jamais un chiffre de l'instantané ni n'écrit le fichier à la main. Ensuite, seules quatre vérifications fixes comptent comme anomalies :
- Les impressions tombent sous la moitié de leur moyenne sur 7 jours.
- Les passages des robots d'IA tombent sous 50 % ou dépassent 300 % de leur moyenne sur 7 jours.
- Une famille d'une vague active est absente des données pendant 7 jours.
- La page d'accueil ou le sitemap ne renvoie pas HTTP 200 à un robot d'IA.
Aucun jugement sur le CTR, aucun classement, aucune référence, aucune recommandation. Un bug n'est cité que par l'identifiant renvoyé par l'outil de suivi.
Le second échec était plus discret, et pire. La publication d'un paquet pour l'un de nos sites embarquait une modification produit non publiée, qui a réécrit le texte de l'une de nos pages témoins avant le jour 0. Un témoin qui change n'est plus un témoin : tout écart qu'il montre vient de notre propre modification, pas de la correction. Nous l'avons repéré avant la mise en ligne. La règle : une famille touchée après l'affectation passe dans « Exclue après affectation » et sort de la comparaison.
Construisez la vôtre : la version minimale
Inutile d'avoir cinq workflows pour commencer. Il vous faut un dépôt, deux scripts, un modèle de fiche et un planificateur quotidien.
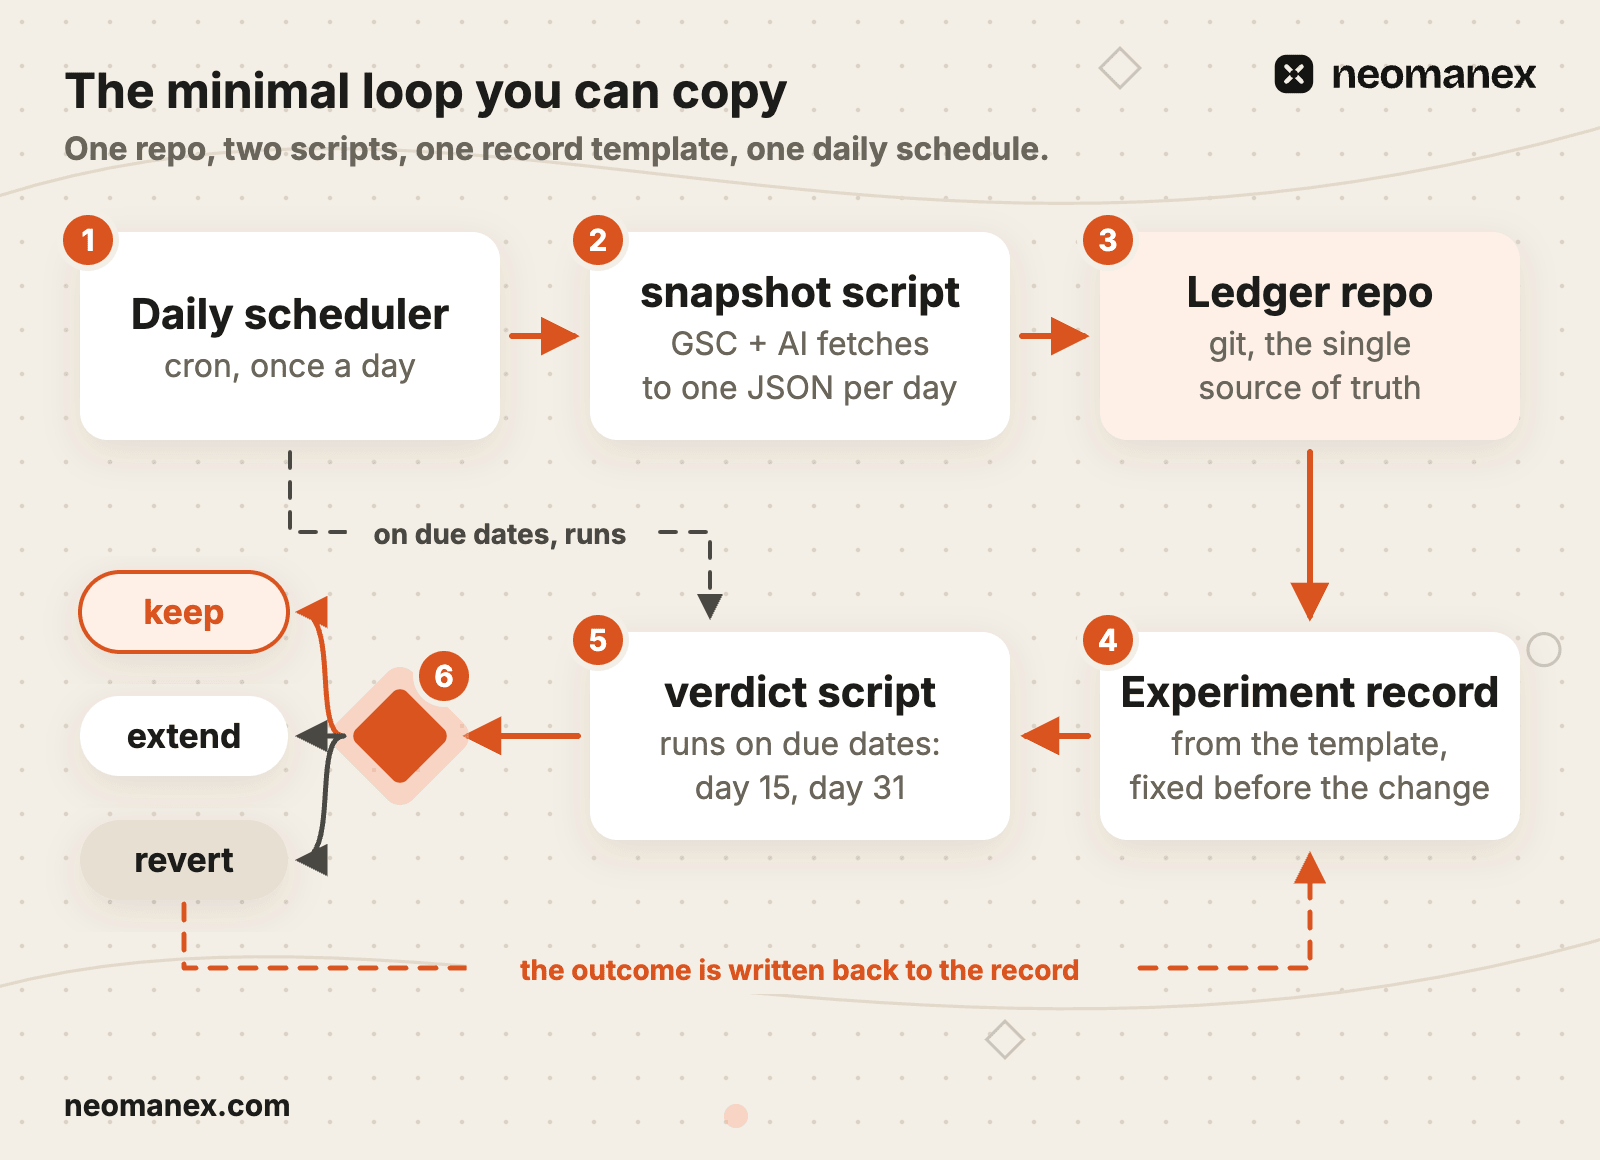
Le modèle de fiche, un fichier par expérience :
---
experiment: exp-0001
site: example
wave: example-2026-01-05
arm: A
fix_type: internal-links
primary_metric: impressions
status: registered
branch: exp/exp-0001
day0: null
interim_due: null
final_due: null
---
Hypothesis:
One falsifiable sentence: what changes, on which treated families, against which control, by day 31.

Falsified if:
The day 31 verdict is not a win under the thresholds fixed in the verdict script.

Families:
treated (15+): ...
control (15+): ...

Baseline (28 days):
treated ... | control ...

Verdicts:
| Look | Date | n treated / control | Ratio | p | Verdict |
|---|---|---|---|---|---|

Lesson:
Copiez le modèle de fiche, puis planifiez le pouls quotidien dans ConvOps(s’ouvre dans un nouvel onglet) pour que chaque expérience soit réveillée à son échéance.
Étapes
Créez le dépôt registre
Créez un dépôt git avec la méthodologie, les outils et un dossier par site pour les instantanés, les vagues, les expériences et les rapports. Chaque exécution d'agent y committe sa sortie.
Écrivez le script d'instantané
Récupérez les données de pages de Search Console d'il y a trois jours, car les jours récents ne sont pas encore définitifs, et écrivez un fichier JSON par jour. Claude Code appelle le script et ne calcule jamais les chiffres lui-même.
Vérifiez ce que vous pouvez mesurer
Comptez les familles de pages qui disposent de votre métrique. En dessous de 15 familles par groupe, cette métrique ne peut pas porter une expérience sur votre site : choisissez-en une autre ou attendez.
Affectez par un mélange à graine fixe
Utilisez la date comme graine aléatoire, mélangez au sein de groupes de pages similaires et distribuez les familles à tour de rôle, en commençant par le témoin, jusqu'à ce que chaque groupe en compte 15 ou plus.
Enregistrez avant la modification
Copiez le modèle de fiche, rédigez une hypothèse réfutable et la règle qui la réfute, et committez avant toute modification de page.
Modifiez les pages traitées et fusionnez à la main
Faites modifier par Claude Code une seule variable, sur les familles traitées uniquement, sur une branche. Une personne fusionne, et le jour 0 est le jour où la modification apparaît dans le HTML de production.
Écrivez le script de verdict
Lancez une différence de différences par permutation au niveau des familles, avec des seuils fixés dans le code : succès, échec ou non concluant. L'agent lit le verdict et suit l'étape correspondante.
Planifiez le pouls quotidien
Faites tourner chaque matin une tâche qui construit l'instantané, exécute quelques vérifications fixes et réveille chaque expérience arrivée à échéance ce jour-là, au jour 15 et au jour 31.
Questions fréquentes
Qu'est-ce qu'une expérience SEO pré-enregistrée ?
Une expérience SEO pré-enregistrée est une modification de page dont l'hypothèse, la métrique principale, les groupes de pages traité et témoin, la base de référence et la règle de réfutation sont committés avant la mise en ligne. Dans cette boucle, ConvOps exécute d'abord l'étape d'enregistrement : Claude Code copie le modèle de fiche, rédige une hypothèse réfutable et la committe dans le dépôt registre. Seuls le statut et les dates changent ensuite : le verdict du jour 31 est donc jugé par rapport à ce qui avait été annoncé.
À qui s'adresse une boucle d'expériences SEO ?
Une boucle d'expériences SEO s'adresse aux fondateurs et aux petites équipes marketing qui gèrent un site de contenu ou de produit à faible trafic et font des modifications SEO à l'intuition. ConvOps fait tourner la boucle sous forme de tâches planifiées : chaque correction est conservée, prolongée ou retirée sur la base d'une comparaison contrôlée plutôt que d'un graphique avant/après. Le site doit compter au moins 15 familles de pages par groupe dans le pool testé : un très petit site ne peut donc tester que quelques types de correction.
Claude Code peut-il mener des expériences SEO en tant qu'agent ?
Oui. Claude Code est l'environnement d'exécution de l'agent, et ConvOps est la couche opérationnelle des agents IA qui planifie et contrôle chaque exécution. Claude Code enregistre l'expérience, ne modifie que les pages traitées sur une branche, relit le diff et vérifie que la modification est en ligne. Il ne fusionne jamais la modification : c'est une personne qui le fait. Il ne calcule jamais non plus les métriques ni les verdicts. Des scripts s'en chargent, et Claude Code lit le résultat.
De combien de trafic les expériences SEO ont-elles besoin ?
Assez pour au moins 15 familles de pages par groupe, avec la métrique présente sur chacune. ConvOps fait tourner un planificateur hebdomadaire qui compte les familles éligibles par pool et n'ouvre une vague que lorsqu'une base de référence A/A historique montre que le pool est assez calme. Sur un petit site, seuls les effets importants ressortent : sur la métrique des passages IA, un succès exige un ratio de 1,5 ou plus, et chaque métrique a ses propres seuils dans le script de verdict. Le taux de clics n'est souvent pas mesurable du tout à cette échelle.
Combien de temps faut-il pour qu'une expérience SEO rende un verdict ?
Le verdict final tombe 31 jours après la vérification de la mise en ligne de la modification. ConvOps met la tâche d'expérience en sommeil jusqu'à son échéance, et le pouls quotidien la réveille pour un point intermédiaire au jour 15. Ce point déclenche un retour arrière en cas d'effet néfaste, une annulation en cas de mise à jour de Google, ou la poursuite jusqu'au jour 31, et un succès net sur les passages IA à p de 0,0074 ou moins arrête l'expérience de façon anticipée. Un bilan final non concluant est prolongé une fois jusqu'au jour 59, puis fermé.
Que se passe-t-il quand une expérience SEO échoue ?
Un échec signifie que les pages traitées ont fait moins bien que le témoin. Sur la métrique des passages IA, cela correspond à p de 0,0477 ou moins dans le sens défavorable, un ratio de 0,67 ou moins, et au moins 60 % des familles traitées sous la médiane du témoin. Chaque métrique a ses propres seuils dans le script de verdict. ConvOps fait passer la tâche à son étape de retour arrière, où Claude Code prépare le retour arrière sur une branche et une personne le fusionne. L'exécution suivante, au réveil, confirme que le retour arrière est en ligne, et l'échec pèse contre ce type de correction lorsque le planificateur tire la vague suivante.