
Lo que serás capaz de hacer
- Organizar las seis capas de aprendizaje en tu propio conjunto de agentes.
- Tipar tus memorias por categoría y decidir qué alimenta cada categoría.
- Añadir a un flujo de trabajo la recuperación al principio, Learning Capture al final y pasos que detectan carencias.
- Montar un registro de fallos con límite y una consolidación mensual.
- Elegir el primer punto de aprobación que pasa a una comprobación registrada, y los que no cambian nunca.
Ideas clave
- Un sistema de IA que se mejora a sí mismo mejora sus archivos, memorias y pasos de flujo de trabajo, nunca su modelo: las lecciones de cada trabajo terminado se convierten en reglas que lee el siguiente.
- Aprende en seis capas, cada una un bucle: memoria, Learning Capture (captura de aprendizajes), cambios en el flujo de trabajo, pasos que detectan carencias, fricción registrada en cuanto aparece y un pipeline que revisa todo el sistema.
- Las memorias se tipan por categoría, y cada categoría alimenta un sitio distinto: las correcciones se convierten en reglas candidatas, las decisiones se recuperan y los procedimientos se convierten en pasos del flujo de trabajo.
- La prueba de «clase o caso aislado», un registro de fallos limitado a 15 entradas por sección y una consolidación mensual mantienen las reglas lo bastante pequeñas como para leerlas.
- La autonomía es el resultado: los puntos de aprobación pasan a ser comprobaciones registradas a medida que las capas los hacen predecibles, mientras que los merges, la publicación y las acciones irreversibles siguen en manos de una persona.
Para construir un sistema de IA que se mejora a sí mismo, deja el modelo en paz y mejora todo lo que lo rodea. Un sistema de IA que se mejora a sí mismo es un repositorio de estándares, un almacén de memoria y flujos de trabajo con puntos de aprobación que convierten las lecciones de cada trabajo terminado en reglas que lee el siguiente. Los pesos del modelo no cambian nunca. El sistema aprende en seis capas, y cada una es un bucle que escribe la lección justo donde la leerá el siguiente trabajo.
Ejecutamos las seis capas en ConvOps, donde viven nuestras tareas, flujos de trabajo, puntos de aprobación y almacén de memoria, y las seguimos haciendo evolucionar cada semana. Esta guía es la construcción en sí, escrita para responsables de ingeniería, ingenieros de plataforma y fundadores técnicos que usan agentes de código o de contenido en trabajo recurrente. Si quieres ver cómo es una semana normal contada en lenguaje llano, lee la guía central de esta serie, cómo dirigimos nuestra empresa con agentes de IA. Empieza por las capas 1 y 2 en un flujo de trabajo que ejecutes cada semana: el resto se apoya en lo que ellas escriben.
Aquí «que se mejora a sí mismo» es procedimental. No es automejora recursiva y no se reentrena nada. Cada lección acaba en una memoria, en un paso de un flujo de trabajo o en un estándar escrito que una persona puede leer, revisar y revertir. Esa es la fuerza del diseño: ves exactamente qué ha aprendido el sistema, dónde lo ha escrito y quién lo ha aprobado.
Todos los ejemplos usan Copperfern, una tienda online ficticia de artículos para el hogar que vende menaje de cocina y mantelería en inglés y en español en copperfern.example.com. Los nombres de los pasos, los puntos de aprobación, las categorías y los umbrales son los nuestros. La empresa, las personas y todos los valores son inventados. Maya es quien aprueba en el Merge gate (el punto de aprobación antes de fusionar el código).
Qué hace un sistema de IA que se mejora a sí mismo
Un sistema de IA que se mejora a sí mismo convierte un error en una regla una sola vez, para que ningún trabajo posterior lo repita. Se apoya en tres piezas: un repositorio de estándares y archivos de instrucciones que leen los agentes, un almacén de memoria que cada trabajo consulta primero y en el que escribe mientras avanza, y flujos de trabajo con puntos de aprobación que fijan qué se ejecuta, en qué orden y dónde aprueba una persona.
Sobre esas tres piezas se asientan seis capas de aprendizaje, de la más básica a la más avanzada. Cada capa es un bucle: algo ocurre en un trabajo, se escribe una lección en algún sitio y un trabajo posterior la lee ahí.

| Capa | El bucle | Qué escribe | Dónde lo lee el siguiente trabajo | Quién aprueba |
|---|---|---|---|---|
| 1 Memoria | Recuperar antes del trabajo, guardar durante y después | Una memoria tipada: una decisión, una corrección, una trampa | El primer paso de cada trabajo relacionado | Nadie: guardar es lo predeterminado |
| 2 Learning Capture (captura de aprendizajes) | El último paso de cada flujo de trabajo guarda lo que ha enseñado la ejecución | Memorias y rutas | La recuperación y todas las capas superiores | Nadie: el agente decide qué merece guardarse |
| 3 Cambios en el flujo de trabajo | Una lección repetida se convierte en una línea de un paso o en un paso nuevo | El propio flujo de trabajo | Cada ejecución de ese flujo, sin necesidad de recuperar nada | Una persona aprueba el cambio |
| 4 Pasos que detectan carencias | Pasos dentro del flujo contrastan el trabajo con los estándares y escriben la regla que falta | Estándares, archivos de reglas, archivos de instrucciones, candidatos al registro de fallos | El paso de descubrimiento de cada tarea posterior y cada revisión de plan | El agente juzga una carencia de clase y la registra; una persona aprueba el merge |
| 5 Registrado al detectarse | La fricción se convierte en tarea en cuanto aparece; las reglas que no pueden fallar se convierten en hooks | Tareas y hooks | El backlog y el harness (el entorno que ejecuta al agente) en cada llamada a herramienta | Registrarla no necesita a nadie; una persona fija el horizonte |
| 6 Pipeline de memoria | Lee todas las categorías en todos los espacios de trabajo, fusiona, promueve, retira y sugiere | Entradas del registro, propuestas de reglas, cambios en agentes e instrucciones | Todo lo anterior | Los cambios pequeños entran directamente; las reglas nuevas necesitan a una persona |
Las capas inferiores son baratas y ven un solo trabajo. Las superiores son más lentas y ven el sistema entero. Constrúyelas en orden, porque cada capa superior lee lo que escriben las de abajo. En términos de consultoría, esto es una etapa del recorrido hacia un modelo operativo de IA; esta guía se queda en la mecánica.
Capa 1: memoria recuperada antes de cada trabajo y guardada después
Un agente que empieza cada sesión desde cero repite todos los errores que ha cometido. La memoria es el primer bucle, y solo funciona si cada trabajo lee antes de escribir.
¿Qué es la memoria de un agente de IA en un sistema que se mejora a sí mismo? La memoria de un agente de IA es un almacén de notas breves y tipadas (decisiones, correcciones, trampas, procedimientos y más) que cada trabajo consulta en su primer paso y en el que escribe mientras avanza. Usamos un único almacén para todos los espacios de trabajo y todos los agentes conectados, tanto Claude Code como OpenCode, así que una lección guardada en el espacio de soporte la encuentra una tarea de la web.
Primero recupera, guarda sobre la marcha
El primer paso de nuestros flujos de trabajo empieza recuperando. Una sola llamada, context_query, devuelve dos cosas a la vez: rutas, que indican dónde vive cada cosa (módulos, archivos, documentación), y memorias, que recogen lo que sabemos. Una llamada más acotada, memory_recall, filtra por categoría, etiquetas e importancia mínima cuando un paso solo necesita un tipo de nota.
Guardar es memory_store con una categoría, una importancia del 1 al 10 y etiquetas. La recuperación ordena por significado, importancia y actualidad, así que el agente fija la importancia según cuánto pierde un trabajo posterior si no ve la nota. Una nota nueva que repite otra existente la sustituye en lugar de quedarse a su lado como duplicado.
La tarea del proceso de pago de Copperfern empieza recuperando la decisión «Todas las fechas se guardan en UTC y se muestran en la zona horaria del comprador (marzo)» y la trampa «El correo del pedido formatea las fechas con su propia plantilla». Antes de que el agente escriba una línea de código, ya conoce la regla y la trampa.
Las memorias son tipadas, y cada tipo alimenta un sitio distinto
La categoría es el campo más importante de una memoria, porque decide adónde va la lección después. Una corrección es una regla en potencia. Una decisión es algo que se recupera, no algo que se reabre. Una preferencia va en un archivo de instrucciones, donde la lee cada sesión sin necesidad de consulta.
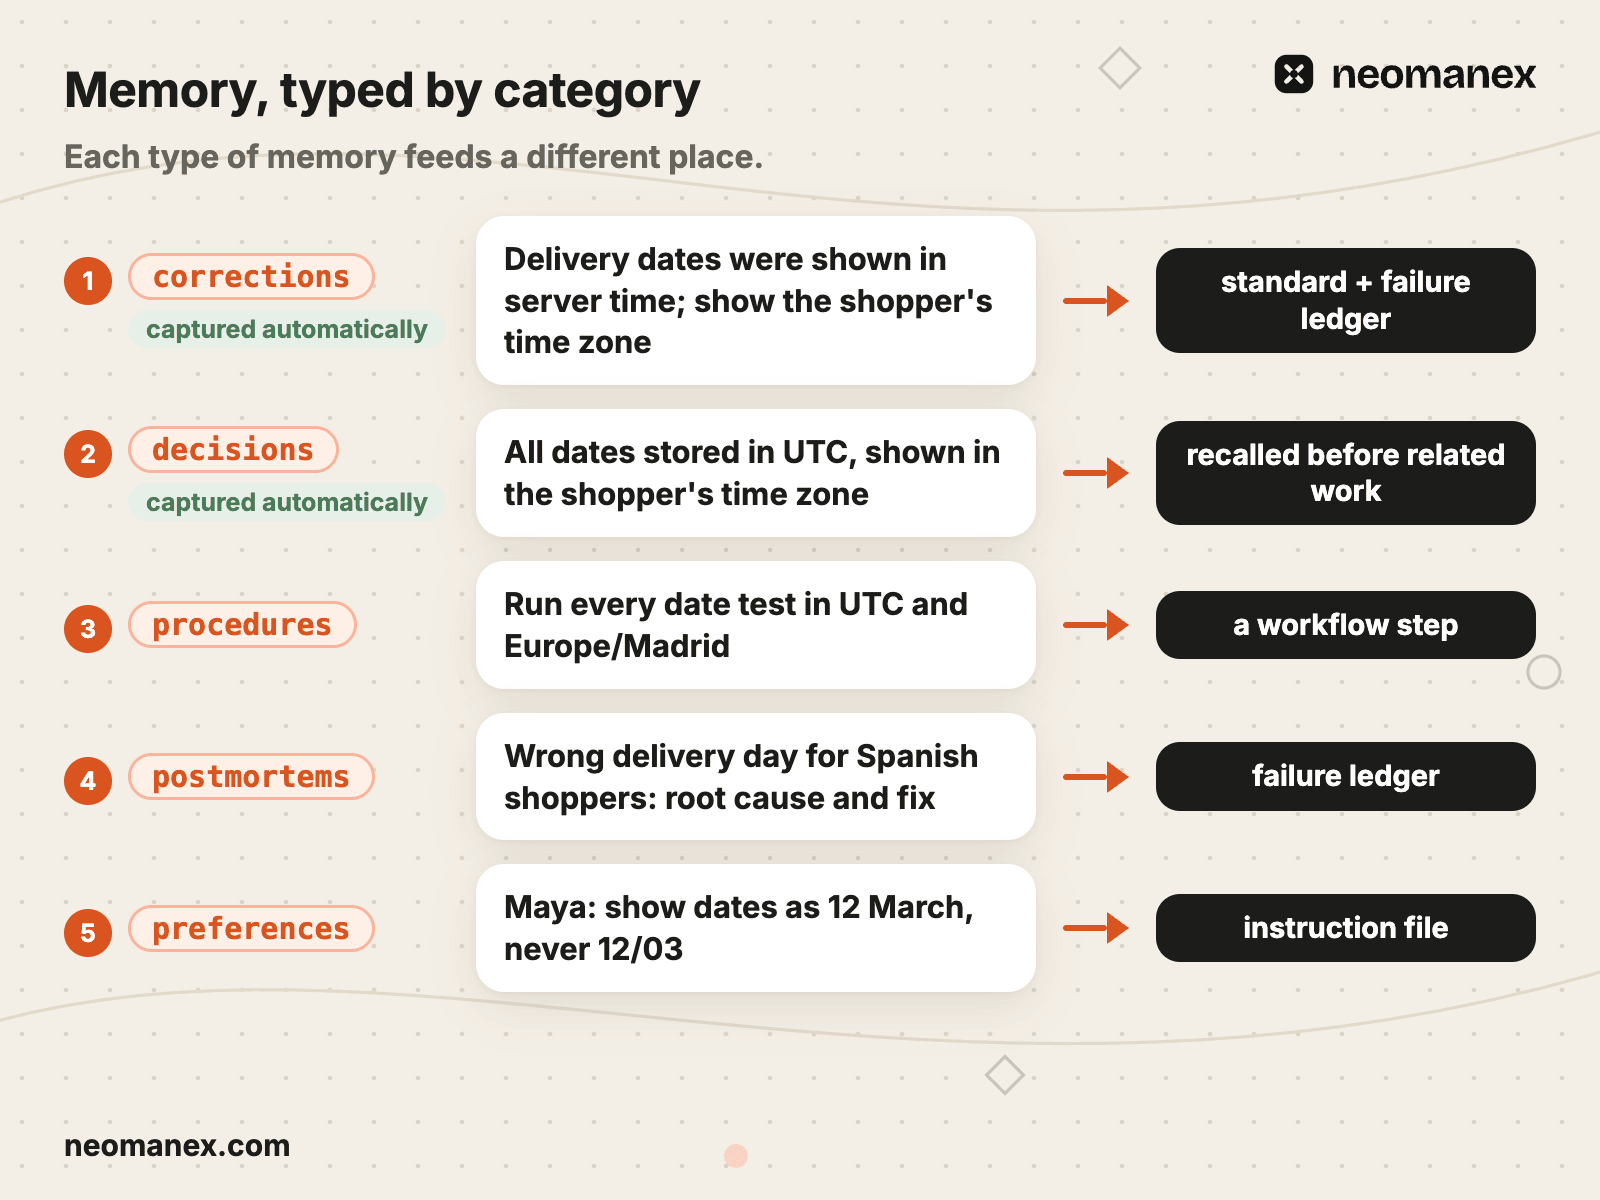
| Categoría | Memoria de Copperfern | Qué alimenta después |
|---|---|---|
corrections | «Las fechas de entrega se mostraban en la hora del servidor; hay que mostrar la zona horaria del comprador» | Una regla candidata para un estándar y el registro de fallos |
gotchas | «El correo del pedido formatea las fechas con su propia plantilla» | Una regla candidata; se recupera antes de cualquier cambio en fechas |
decisions | «Todas las fechas se guardan en UTC y se muestran en la zona horaria del comprador (marzo)» | Se recupera antes del trabajo relacionado |
context | La nota de merge de Maya: «Aprobado después de que pasara la prueba de Madrid» | Se queda en su tarea y se recupera cuando ese trabajo se reanuda |
procedures, patterns | «Ejecuta cada prueba de fechas en UTC y en Europe/Madrid» | Pasos de flujo de trabajo y estándares |
postmortems | «Día de entrega erróneo para compradores españoles: causa raíz y solución» | El registro de fallos |
preferences | «Maya: muestra las fechas como 12 de marzo, nunca 12/03» | Archivos de instrucciones |
progress | «Tarea de la fecha de entrega fusionada, rama limpiada» | Se queda en su tarea |
reference, customers, marketing, posts | Conocimiento de dominio guardado para su propio trabajo | Se recupera por dominio |
La capa 6 lee todas estas categorías a la vez. Ahí es donde una corrección en un espacio y una trampa en otro resultan ser la misma lección.
Algunas memorias se guardan solas
Tres canales automáticos guardan sin que nadie lo pida, a medida que ocurren los eventos del ciclo de vida. Cada uno se activa por espacio de trabajo, y nosotros trabajamos con los tres activados:
decisions: cuando se resuelve un paso de decisión, se cancela una tarea o alguien escribe una nota DECISION.progress: en cada avance de paso y en cada finalización.corrections: cuando alguien escribe una nota BLOCKER, como un rechazo en un punto de aprobación.
Además, las notas context= se escriben siempre que se pasan. El parámetro context= de las llamadas de tareas y flujos de trabajo guarda la nota como memoria context en la misma llamada que la acción. Lo controla un ajuste del espacio de trabajo, y viene activado de serie.
Todo lo demás se guarda a propósito. Una nota context= ocupa de 2 a 3 líneas, una decisión y su porqué, nunca un informe de estado. Una nota de menos de 40 caracteres no se guarda, porque las notas vacías envenenan la recuperación, y ese mínimo vive en el almacén, no en la disciplina de nadie.
La contabilidad de las tareas (context y progress) se queda en su tarea. Va marcada y, por defecto, queda fuera de la recuperación de otras tareas, así que una línea de estado del mes pasado nunca se impone a una decisión.
Quién aprueba una memoria
Nadie. Guardar es lo predeterminado, y el agente fija la importancia. Una memoria floja se sustituye o se fusiona más tarde en la capa 6; nunca se aprueba para entrar. Un paso de aprobación aquí hace que los agentes guarden menos, y una lección perdida cuesta mucho más que una ruidosa que el pipeline acabará fusionando.
Qué falló con la memoria y la regla que dejó
Nuestro primer diseño de memoria tenía una única categoría comodín, learnings. Todo acababa ahí, y la recuperación devolvía un montón de notas mezcladas para cualquier consulta. La regla: learnings está obsoleta en nuestro estándar de memoria para las memorias nuevas, y las memorias van a categorías concretas, cada una con su función. En Copperfern ese mismo montón mezclaba fechas, correos y precios; ahora cada nota tiene un tipo y un destino.
El segundo fallo llegó al activar los canales automáticos. La contabilidad de las tareas superaba en número al conocimiento deliberado y se le imponía en la recuperación. La regla: la contabilidad va marcada y queda excluida por defecto de la recuperación entre tareas, y cada canal de captura nuevo sale con un peso de recuperación, una clase de elegibilidad y una importancia configurable.
Si tus agentes empiezan cada sesión desde cero, construye esta capa primero. ConvOps es donde la ejecutamos: flujos de trabajo con un paso de recuperación al principio y Learning Capture al final, y un único almacén de memoria que leen todos los agentes conectados. Descubre cómo funciona ConvOps(se abre en una pestaña nueva).
Capa 2: Learning Capture, el último paso de cada flujo de trabajo
Si guardar una lección depende de que el agente se acuerde de hacerlo, no ocurre. Por eso en nuestro sistema es un paso, y es el último de cada flujo de trabajo.
Learning Capture es un paso global. Lo definimos una vez, y el motor de flujos de trabajo lo añade, seguido de Complete (completar), al final de cada flujo de trabajo dentro de su ámbito. Nadie lo añade a mano a un flujo nuevo y nadie puede olvidarlo. Los flujos de corrección, y los flujos que ejecutan fases sueltas de un plan mayor, quedan fuera de su ámbito.
El paso le dice al agente:
Captura los aprendizajes de esta ejecución del flujo de trabajo. Guarda decisiones, trampas y patrones con memory_store(). Indexa como rutas las nuevas rutas de archivos si se han creado áreas de código importantes: route_create para un área nueva o route_update para ampliar una existente. Consulta primero la ruta existente y fusiona tú las rutas de archivos, porque route_update sustituye cada campo que envías. Si no ha pasado nada digno de mención, sáltalo con «no learnings to store» (no hay aprendizajes que guardar).
Ese texto encierra tres decisiones de diseño:
- Nombra las categorías. Decisiones, trampas, patrones: el agente guarda memorias tipadas, no un diario de la ejecución.
- Indexa el código nuevo como rutas. La recuperación del siguiente trabajo dice dónde vive el código además de lo que sabemos de él.
- Permite saltarlo. Una ejecución sin nada nuevo no guarda nada, a propósito. Una nota obligatoria en cada ejecución es la avalancha de contabilidad de la capa 1 que vuelve.
Los flujos de trabajo con su propio paso de aprendizaje ejecutan los dos. Nuestro ciclo de mejora (capa 3) tiene un paso Learn (aprender) que guarda lo que ha enseñado cada ciclo, y el Learning Capture global sigue ejecutándose antes de Complete.
Learning Capture alimenta tres sitios: el almacén que recupera la capa 1, los cambios en el flujo de trabajo de la capa 3 y el pipeline de la capa 6. Nadie lo aprueba; el agente decide qué merece guardarse.
La tarea de la fecha de entrega de Copperfern termina con Learning Capture guardando la trampa «La zona horaria del servidor se cuela en las fechas de entrega; prueba en Europe/Madrid» y una ruta al nuevo módulo de formato de fechas. La siguiente tarea de fechas encuentra las dos cosas en su primer paso: qué probar y dónde está el código.
Qué falló. Había sesiones que editaban archivos y terminaban sin guardar nada. Un paso al final de un flujo de trabajo no puede atrapar el trabajo hecho fuera de un flujo, ni una sesión que se detiene antes de su último paso. La regla: un Stop hook en el harness del agente (en Claude Code, un script que se ejecuta cada vez que el agente se detiene) comprueba cada 2 turnos del asistente si la sesión ha guardado algo. Una sesión que ha editado archivos sin guardar nada se señala al momento, sin esperar al recuento de turnos. El protocolo nunca depende de la memoria de nadie, tampoco de la del agente.
Capa 3: flujos de trabajo que se editan a sí mismos
Una lección que solo vive en la memoria depende de que la recuperación la encuentre. Una lección escrita en el paso se lee cada vez que el trabajo llega a ese paso. Por eso la tercera capa convierte lo que ha encontrado Learning Capture en un cambio del propio flujo de trabajo: una instrucción más precisa, un paso nuevo, un nuevo punto de aprobación, un bucle acotado.
Por eso guardamos los procedimientos en flujos de trabajo y no en un único archivo de instrucciones largo. Un flujo de trabajo es un grafo de pasos, así que una lección va al único paso que la necesita, no a un archivo que cada paso tiene que leer (la idea en la que se basa graph engineering).
Cómo cambia un paso
Los cambios son quirúrgicos: un paso cada vez, nunca la reconstrucción de un flujo de trabajo en uso. Cada cambio entra solo con cero avisos de validación, y después se vuelve a leer desde el motor para confirmar que el paso dice lo que se pretendía. Antes de un cambio estructural, como mover o eliminar un paso, se revisan las ejecuciones en curso, para que ninguna tarea viva descubra que su siguiente paso ha desaparecido.
El texto de un paso contiene solo el procedimiento: lo que hace el ejecutor en ese paso. El motivo de un cambio va a una memoria, nunca al paso. Un paso lleno de historia es un paso que los agentes leen en diagonal.
El flujo de trabajo de desarrollo de Copperfern aprende la lección de la fecha de entrega en una sola línea:
Implement
  (existing instructions unchanged)
+ Run every date test in UTC and Europe/Madrid.
A partir de ahí, cada tarea que llega a Implement (implementar) lee la línea («ejecuta cada prueba de fechas en UTC y en Europe/Madrid»). Ninguna recuperación tiene que ordenarla y ningún agente tiene que recordarla.
Los cambios en los flujos de trabajo los aprueba una persona. El agente propone el cambio y, una vez aprobado, hace la edición quirúrgica. Un arreglo de una línea en un estándar o en un archivo de instrucciones al que apunta un paso entra directamente según nuestro estándar de archivos de instrucciones (la capa 5 explica dónde está esa línea).
El ciclo de mejora: una mejora por ciclo
Hay trabajo que mejora un entregable en lugar de cerrar una tarea: una página, un texto, una auditoría recurrente. Para eso ejecutamos el flujo de trabajo Autonomous Cycle (ciclo autónomo), un bucle que edita su propio resultado cambio a cambio.
| Paso | Qué hace |
|---|---|
| Analyze (analizar) | Recupera lecciones anteriores sobre este entregable (importancia mínima 5, como mucho 10) y redacta un análisis |
| Validate (validar) | Recupera decisiones pasadas (hasta 10) y trampas (hasta 5). Si el análisis tiene fallos o repite una decisión pasada, escribe por qué y devuelve el ciclo a Analyze |
| Plan (planificar) | Elige la mejora de mayor impacto. Una por ciclo, bien hecha |
| Execute (ejecutar) | Hace ese único cambio |
| Learn (aprender) | Guarda lo que ha enseñado el ciclo |
| Continue? (¿continuar?) | improve-more programa el siguiente ciclo para dentro de un minuto; done cierra la ejecución. Un límite de ciclos, si la ejecución lo fija, la detiene |
Después vienen Learning Capture y Complete, como en cualquier flujo de trabajo. Una mejora por ciclo mantiene cada paso pequeño y comprobable: un ciclo que cambia cinco cosas no puede saber cuál de ellas ayudó. La vuelta de Validate a Analyze impide que el bucle proponga lo que ya se descartó.
Qué falló con los flujos de trabajo y las reglas que dejó
Nuestras guías salieron solo en inglés después de que un trabajo de traducción independiente dejara de ejecutarse, y nada en el flujo de las guías lo notó. La regla: la traducción pasó a ser un paso dentro del flujo de trabajo de las guías, seguido de un juez de traducción que debe devolver cero hallazgos en cada idioma. En Copperfern las páginas en español iban por detrás de las inglesas por el mismo motivo; ahora el flujo de las páginas traduce y juzga antes de poder publicar.
Los pasos de revisión también entraban en bucle sin converger, y cada ronda encontraba algo nuevo. La regla: cada revisión rechaza hacia un paso de corrección y, tras 2 rondas, registra un bug y se detiene en lugar de ejecutar una tercera. Una revisión en bucle quema ejecuciones; un bug trae a una persona con las pruebas delante.
Capa 4: pasos que detectan carencias y corrigen los estándares
El mejor sitio para encontrar una regla que falta es el flujo de trabajo que acaba de necesitarla. Por eso nuestro flujo de desarrollo lleva sus propios pasos de detección de carencias. Contrastan el trabajo con los estándares, encuentran dónde falta un estándar o dónde se queda corto, y escriben el arreglo antes de que empiece la siguiente tarea.
El flujo de trabajo es Development Task (MR flow) (tarea de desarrollo con merge request). Estos son los pasos que importan para esta capa, en orden, con los cinco pasos de detección de carencias numerados como en la imagen de abajo. Entre medias se ejecutan otros pasos, como la documentación de casos de uso, el push y las comprobaciones de CI:
Functional Analysis (análisis funcional; una persona aprueba y la lista de requisitos se congela) → 1 Discover Standards & Flag Gaps (descubrir estándares y señalar carencias) → Technical Analysis (análisis técnico) → 2 Traceability Check (one pass) (comprobación de trazabilidad en una pasada) → Implement → 3 Check Standards Compliance (comprobar el cumplimiento de los estándares) y Compliance Decision (decisión de cumplimiento) → 4 Terminal Gap Check (comprobación final de carencias) → Update Documentation (actualizar la documentación) → Merge (Verification Review + CI Green + Operator) (merge con revisión de verificación, CI en verde y aprobación del operador) → Standards Check? (¿comprobar estándares?) → 5 Standards Capture (captura de estándares) → Learning Capture → Complete.

1. Discover Standards & Flag Gaps
Antes de cualquier diseño, en Discover Standards & Flag Gaps un agente de descubrimiento de estándares lee nuestros archivos de enrutamiento (uno por equipo, la única fuente de verdad sobre qué estándares se aplican a qué trabajo) y elabora la lista de estándares que rigen esta tarea. La misma pasada abre cada estándar y señala una carencia cuando:
- ningún estándar cubre el área
- existe un estándar, pero le falta el patrón que necesita este trabajo
- un estándar está desfasado o contradice la práctica
- el trabajo introduce un patrón nuevo que ningún estándar cubre
- existe un archivo de estándares al que no llega ningún archivo de enrutamiento
Con cero carencias, el paso lo dice y avanza sin esperar. Con cualquier carencia, se detiene, y una persona decide carencia por carencia: crear una tarea, ampliar un estándar existente o aceptar el riesgo. Al avanzar, la lista queda bloqueada para este trabajo. Cada comprobación posterior se hace frente a la lista bloqueada, así que nadie cambia las reglas a mitad de partido.
2. Traceability Check (one pass)
Después de Technical Analysis, en Traceability Check (one pass) un analizador de carencias hace una única pasada sobre una lista cerrada de cuatro puntos. Una pasada, nunca un bucle. Los bloqueos de los tres primeros puntos se corrigen ahí mismo, el cuarto punto se detiene para que decida una persona, y todo lo demás va a la lista de vigilancia de riesgos conocidos de la tarea en lugar de a otra ronda de revisión.
3. Check Standards Compliance y Compliance Decision
Después de Implement, en Check Standards Compliance un revisor de estándares compara el cambio con la lista bloqueada. Compliance Decision lee el informe:
| Hallazgo | Qué pasa |
|---|---|
| HIGH o MEDIUM | El flujo de corrección se ejecuta una vez. El revisor no se vuelve a ejecutar: la prueba son los resultados del propio corrector (lint, comprobación de tipos y los tests unitarios afectados en verde), citados en las notas de la tarea |
| LOW, de una línea | Se corrige en el momento |
| LOW, de más de una línea | Se busca una tarea existente o, si no la hay, se registra una tarea con la etiqueta discovered-during-execution que cita archivo, línea y estándar |
| Preexistente | Nunca se corrige aquí |
El paso se supera con cero hallazgos HIGH y cero MEDIUM abiertos.
4. Terminal Gap Check
Antes de la documentación y del merge, Terminal Gap Check hace tres cosas. Cierra cada punto de la lista de vigilancia del paso 2: un riesgo que se ha materializado se corrige ahora, y uno que no, recibe una resolución de una línea. Vincula cada requisito con su prueba entregada, y un requisito sin prueba recibe un test ahora o se detiene para que decida una persona. Y guarda cada fallo de ejecución que nada había previsto como memoria failure-pattern con importancia 7: esos son los candidatos al registro de fallos.
Después viene Update Documentation, que escribe un agente de documentación a partir del diff. Tras el push y las comprobaciones de CI llega el Merge gate: necesita un pipeline en verde y la aprobación de una persona, las dos cosas. Es el único punto de control del operador entre el análisis aprobado y el merge, y un pipeline en rojo significa corregir la causa, nunca fusionar pasando por encima.
5. Standards Check? y Standards Capture
Después del merge, Standards Check? decide si el arreglo enseña algo a los estándares. Sí, cuando se ha corregido un bug que puede representar una clase de errores, cuando un estándar ausente o insuficiente podría haber evitado el problema, o cuando el cambio ha revelado una carencia en los estándares. No, para una funcionalidad sin más, una refactorización sin cambio de comportamiento o un cambio solo de documentación.
Si la respuesta es sí, se ejecuta Standards Capture, en tres pasos:
- Assess Standards Gap (evaluar la carencia en los estándares) lee los estándares, los archivos de reglas de los agentes y los archivos de instrucciones. Devuelve «No gap» (sin carencia) con un motivo de una línea, o «Gap found» (carencia encontrada) con el archivo exacto, la regla, el porqué y una redacción propuesta. Solo recomienda una regla cuando el bug representa una clase de errores que una regla atraparía, nunca para un caso aislado.
- Standards Judgment (dictamen sobre estándares) es una decisión del propio agente, sin aprobación del operador. Antes de avanzar, debe registrar el resultado como una actividad. Ese registro sustituyó la firma de una persona, y es el rastro de auditoría.
- Apply Standard (aplicar el estándar) solo se ejecuta cuando la carencia se ha considerado justificada. Un agente de documentación escribe la regla y vuelve a leer el archivo para comprobar que el cambio ha quedado.
La prueba de clase es lo que mantiene legibles los estándares. Una regla por cada bug aislado infla un estándar hasta que ningún agente lo lee con atención.
El arreglo de la fecha de entrega de Copperfern pasa por ahí así:
Standards Check?   yes
Assess             Gap found. Class: any date shown to a shopper can leak server time
Judgment (logged)  Standards judgment: applied dates-and-times.md, shopper time zone
Apply              dates-and-times.md v1.2
                   Store UTC; render in the shopper's time zone;
                   every date test runs in two time zones
Standards Capture edita estándares, archivos de reglas y archivos de instrucciones. Los arreglos de los flujos de trabajo llegan por la capa 3. Los cambios en las definiciones de los agentes salen de lo que encuentran estos pasos y de las sugerencias de la capa 6.
El registro de fallos: la rúbrica de las revisiones de planes
¿Qué es un registro de fallos? Un registro de fallos (failure ledger) es una lista curada de patrones de fallo refutables, cada uno sacado de un incidente real, con la que las revisiones de planes auditan cada plan. Cada entrada tiene cuatro campos: ID, Pattern, Check e Incident (identificador, patrón, comprobación e incidente). Un revisor devuelve PASS, FAIL o N/A por entrada, y solo lee la sección Global y la sección de su propio proyecto.
| ID | Patrón | Comprobación | Incidente |
|---|---|---|---|
FL-P1 | Fecha mostrada sin la zona horaria del comprador | Cada fecha del plan indica su zona horaria | Fecha de entrega en las páginas de producto |
| Regla del registro | Valor | Por qué |
|---|---|---|
| Admisión | Solo incidentes reales; los candidatos se promueven en la consolidación, nunca a mitad de una revisión | Un registro de riesgos imaginados es una lista de deseos |
| Límite por sección | 15 entradas; al llegar al límite, las entradas que se solapan se fusionan antes de que entre una nueva | «El límite es lo que obliga a depurar» |
| Retirada | Solo PASS o N/A durante 5 planes consecutivos: se mueve a Retired (retiradas) en la consolidación | Una comprobación que nunca salta le cuesta algo a cada revisión |
| Dónde se comprueba | En la revisión del siguiente plan | El flujo de desarrollo aporta candidatos; las revisiones de planes leen el registro |
Qué falló. Una revisión de plan iba ronda tras ronda, cada una encontraba algo nuevo y nunca convergía. La regla: las revisiones auditan cada plan con un registro curado de patrones refutables sacados de incidentes reales, cada hallazgo respaldado por su incidente, con un límite por sección y un número acotado de rondas.
Capa 5: mejoras registradas mientras se trabaja
El momento más barato para dejar constancia de una fricción es cuando aparece. Una lección recordada a final de semana ya está medio perdida. Por eso cualquier propuesta para mejorar un bucle, un paso, un estándar o una herramienta se registra como tarea en cuanto se detecta, y el trabajo sigue.
La regla vive en nuestro archivo de instrucciones raíz. Una acción que no ha salido a la primera (un test que falla la primera vez, un requisito previo oculto, una configuración que falta, un paso sin documentar) se notifica a una persona, se busca una tarea existente y, solo si no hay ninguna que encaje, se registra con la etiqueta discovered-during-execution. Todas esas tareas cuelgan de un único objetivo de salud de la ingeniería, venga del proyecto que venga, así que la fricción tiene un solo hogar y un solo backlog.
Compliance Decision aplica la misma regla dentro de un flujo de trabajo: un hallazgo LOW de más de una línea se convierte en tarea, nunca en un motivo para frenar el merge.
Mientras arregla la fecha de entrega, el agente de Copperfern descubre que el correo del pedido formatea las fechas con su propia plantilla. Registra «El correo del pedido ignora la zona horaria del comprador», con la etiqueta discovered-during-execution, y termina la tarea en la que estaba. El correo tiene su propia tarea, su propia revisión y su propio merge.
Registrar no necesita aprobación. Una persona fija el horizonte: now, next o later (ahora, después o más adelante). Cuando el arreglo es un cambio pequeño en un archivo de instrucciones, un estándar o un protocolo (una línea, un valor desfasado, una errata, sin regla nueva ni decisión de diseño), el agente lo hace directamente según nuestro estándar de archivos de instrucciones, y luego hace commit y push. Una regla nueva, una reestructuración o cualquier cosa que cambie cómo se comportan los agentes se propone primero y la aprueba una persona. Esa división mantiene cortos los archivos de instrucciones: remiten a los estándares, nunca los contienen (por qué un CLAUDE.md largo es un síntoma).
Hooks: las reglas que nunca dependen de la memoria
Hay reglas demasiado importantes para vivir en un prompt. Los hooks del harness de tu agente se ejecutan antes o después de las llamadas a herramientas y cuando el agente se detiene, así que imponen una regla tanto si el agente la recuerda como si no. Tres de los hooks que usamos en Claude Code:
| Hook | Cuándo se ejecuta | Qué impone |
|---|---|---|
| Bloqueo de comandos destructivos | Antes de cada comando de shell | El borrado se bloquea antes de ejecutarse, y los archivos se archivan en su lugar (cómo impedimos los borrados) |
| Comprobación de cambios sin sincronizar | Cuando la sesión se detiene | El trabajo sin commit o sin push impide que la sesión termine |
| Comprobación de memoria | Cuando la sesión se detiene, cada 2 turnos del asistente | Los archivos editados sin nada guardado se señalan al momento |
Las tareas registradas alimentan el backlog, donde cada una se resuelve como tarea propia. Alimentan la capa 6, que lee las incidencias registradas junto con las memorias. Y cuando el arreglo es un paso o un estándar, alimentan las capas 3 y 4.
Qué falló. Un bucle de estándares de comprobar, corregir y volver a comprobar seguía encontrando hallazgos LOW nuevos, ronda tras ronda, hasta que una persona lo paró mientras la tarea de verdad esperaba. La regla: los hallazgos HIGH y MEDIUM se corrigen una vez, sin nueva revisión. Un hallazgo LOW se corrige en el momento si es de una línea y, si no, se registra como tarea. En Copperfern ese mismo bucle habría retenido el arreglo de la fecha de entrega por la redacción de un comentario; con la regla, la redacción va a una tarea y el arreglo se fusiona.
Capa 6: el pipeline de memoria que revisa todo el sistema
Cada capa anterior ve un trabajo. Esta los ve todos, y ahí es donde aparecen los patrones que ningún trabajo por separado puede ver.
El pipeline de memoria lee todas las categorías de memoria, todas las decisiones y todas las incidencias registradas en todos los espacios de trabajo. Fusiona lo que se repite, mantiene honesto el registro y sugiere mejoras para todo el sistema: estándares, flujos de trabajo, definiciones de agentes y archivos de instrucciones.
La mecánica:
- La consolidación ejecuta
memory_consolidatecada mes sobre cada categoría activa: primero un simulacro, para que una persona pueda leer qué se fusiona, y después la fusión de las memorias con una similitud de 0,85 o más. Ese umbral fusiona los casi duplicados y mantiene separadas las lecciones distintas. - Las cadenas de sustitución reemplazan una memoria antigua por su versión nueva en lugar de conservar las dos.
expires_atelimina el contexto con fecha de caducidad cuando deja de ser cierto.- El mantenimiento del registro promueve los candidatos
failure-patternal registro, nunca a mitad de una revisión, y mueve a Retired las entradas con 5 planes consecutivos sin incidencias.
Cada sugerencia acaba donde le corresponde, con su propio aprobador:
| Sugerencia | Acaba como | Quién aprueba |
|---|---|---|
| Un candidato a patrón de fallo | Una entrada del registro | Se promueve en la consolidación |
| Una entrada del registro que nunca salta | Una entrada en Retired | Se mueve en la consolidación según la regla del registro |
| Un arreglo pequeño en un archivo de instrucciones, un estándar o un protocolo | Un cambio directo | El agente, según el estándar de archivos de instrucciones |
| Una regla nueva o una reestructuración | Una propuesta | Una persona |
| Un cambio en un flujo de trabajo | Un cambio de la capa 3 | Una persona |
| Una línea para la definición de un agente | Una propuesta | Una persona |
La consolidación de Copperfern lee corrections y gotchas en los espacios de la web y de soporte. Encuentra tres correcciones sobre fechas y zonas horarias, las fusiona y promueve la entrada del registro FL-P1. También propone una línea para la definición del agente de implementación, «No muestres nunca una fecha sin la zona horaria del comprador», y Maya la aprueba.
Qué falló. Los dos fallos de la capa 1, la categoría comodín y la avalancha de contabilidad, salieron a la luz aquí por primera vez, como una recuperación que devolvía ruido. Desde un solo trabajo, ese ruido parece mala suerte; en todo el almacén es un patrón con una causa, y solo esta capa ve el almacén entero.
Agentes de IA que aprenden de sus errores: una lección a través de seis capas
Los agentes de IA que aprenden de sus errores lo consiguen escribiendo la lección en más de un sitio. Esta es una lección de Copperfern, desde un merge rechazado hasta que la siguiente tarea sale adelante. La tarea es «Mostrar la fecha de entrega en las páginas de producto», en el flujo de trabajo Development Task (MR flow).

- Desencadenante. En el Merge gate, Maya rechaza con una nota BLOCKER: «Los compradores españoles ven la fecha de mañana como si fuera hoy».
- Capa 1, memoria. La nota BLOCKER se guarda automáticamente como memoria
corrections: «Las fechas de entrega se mostraban en la hora del servidor; hay que mostrar la zona horaria del comprador». - Capa 2, Learning Capture. La tarea corregida termina guardando la trampa «La zona horaria del servidor se cuela en las fechas de entrega; prueba en Europe/Madrid», más una ruta al módulo de formato de fechas.
- Capa 3, cambio en el flujo de trabajo. El paso Implement incorpora «Run every date test in UTC and Europe/Madrid».
- Capa 4, pasos de carencias. Standards Check? dice que sí. Assess encuentra una clase: cualquier fecha que se muestra a un comprador puede filtrar la hora del servidor. El dictamen queda registrado, y
dates-and-times.mdv1.2 recibe la regla «Store UTC; render in the shopper's time zone; every date test runs in two time zones», que se vuelve a leer tras escribirla. Terminal Gap Check ya había guardado el candidatofailure-pattern. - Capa 5, registrado. Se registra «El correo del pedido ignora la zona horaria del comprador», con la etiqueta
discovered-during-execution. - Capa 6, pipeline. La consolidación fusiona tres correcciones de zona horaria entre la web y soporte, promueve
FL-P1y propone «No muestres nunca una fecha sin la zona horaria del comprador» para el agente de implementación. Maya aprueba la línea. - Siguiente tarea. Empieza «Mostrar las franjas de recogida». Su primer paso recupera la decisión sobre UTC. Discover Standards & Flag Gaps incluye
dates-and-times.mden la lista. Check Standards Compliance pasa. La revisión del plan al que pertenece compruebaFL-P1: PASS. Maya aprueba en el Merge gate.
La siguiente tarea sale adelante porque seis capas escribieron la lección en seis sitios, no porque cambiara el modelo. Si la recuperación no encuentra la memoria, ahí está la línea del paso. Si un agente nuevo se salta el paso, el estándar está en su lista bloqueada. Si el plan se desvía, el registro lo detecta.
Cómo es la autonomía después de las capas
La autonomía no es un ajuste que subimos. Es lo que queda cuando las capas inferiores han hecho predecible la decisión de un punto de aprobación. Un punto de aprobación pasa de la firma de una persona a una comprobación registrada solo cuando eso es cierto, y la decisión sigue registrada para que una persona pueda leerla (cómo leemos las decisiones de los agentes).

| Pasó de la firma de una persona a una comprobación registrada | Nunca cambia |
|---|---|
| Standards Judgment ante una carencia de clase: el agente decide y registra una actividad que lee una persona | El Merge gate del código: pipeline en verde y aprobación de una persona |
| Cumplimiento de estándares: HIGH y MEDIUM corregidos una vez con los resultados del corrector, sin segunda revisión | Publicar una guía |
| Rondas de revisión: una revisión fallida va a un paso de corrección y, tras 2 rondas, a un bug | Force-push, reescritura del historial y etiquetas de versión públicas |
| Puntos de aprobación preaprobados para una ejecución cuando una persona dice «go autonomous» (pasa a modo autónomo) | Borrar archivos: bloqueado por un hook, se archivan en su lugar |
| Arreglos pequeños en páginas publicadas, comprobados de nuevo en vivo, con todo lo demás retenido para una persona (el bucle de autorreparación) | Reglas nuevas y reestructuraciones de archivos de instrucciones y protocolos |
Standards Judgment es el caso más claro. Antes esperaba a una persona. La prueba de clase de Assess, los estándares que lee y la relectura de Apply hicieron su resultado lo bastante predecible como para que una decisión registrada sustituya ahora a la firma. La actividad de Copperfern dice «Standards judgment: applied dates-and-times.md, shopper time zone», y Maya la lee cuando quiere. El merge sigue esperándola a ella.
La columna de la derecha es una decisión de diseño, no una falta de madurez. Esas acciones son irreversibles o públicas, y una decisión registrada a posteriori no puede deshacerlas. Donde una persona sigue en el bucle, es porque ahí está el riesgo (cómo construir sistemas de IA con una persona en el bucle).
Qué falla al construir agentes de IA que se mejoran a sí mismos
Cada regla de este sistema salió de un fallo que sufrimos. Aquí están todas juntas, con la capa que cambió cada una.
| Fallo | Regla que dejó | Capa |
|---|---|---|
| Una única categoría de memoria comodín; la recuperación devolvía ruido | Categorías concretas; learnings obsoleta para las memorias nuevas | 1, 6 |
| La contabilidad de las tareas superaba al conocimiento deliberado en la recuperación | La contabilidad se queda en su tarea, fuera de la recuperación entre tareas | 1, 6 |
| Sesiones que editaban archivos y no guardaban nada | Un Stop hook señala al momento los cambios sin memoria | 2, 5 |
| Guías publicadas solo en inglés | La traducción como paso del flujo de trabajo, con un juez | 3 |
| Revisiones en bucle sin converger | Registro de fallos, pasos de corrección y un bug tras 2 rondas | 3, 4 |
| Un bucle de estándares seguía encontrando hallazgos LOW nuevos | HIGH y MEDIUM corregidos una vez; LOW en el momento o registrado | 5 |
| Un brief planificaba una imagen por párrafo | Un presupuesto de imágenes en el estándar de guías | 4 |
La última fila muestra el mismo bucle funcionando con contenido, no con código. Un brief de guía planificaba muchas más imágenes de las que necesita cualquier lector, y ninguna regla fijaba un techo. Una persona lo rechazó en el Brief gate (el punto de aprobación del brief) y, como todos los briefs planifican imágenes, el arreglo fue al estándar y no a ese brief concreto: el estándar de guías ganó un presupuesto de imágenes de 8 como máximo para una guía de bucle y 6 para cualquier otra guía, imagen principal incluida. En Copperfern, la misma regla habría recortado un brief de guía de compra que planificaba una imagen por párrafo hasta dejar solo las pocas que explican algo que el texto no puede.
El patrón detrás de cada fila es el mismo. El fallo ocurrió una vez, alguien escribió la regla en la capa que lo habría atrapado y el siguiente trabajo leyó la regla en lugar de redescubrir el fallo. Nuestro bucle de experimentos SEO fue sumando sus reglas de la misma manera.
Construye tu propio sistema operativo de IA, capa a capa
No necesitas las seis capas desde el primer día. Las capas 1 y 2 van primero, porque todas las capas superiores leen lo que ellas escriben. Añade los pasos de detección de carencias cuando tengas estándares con los que merezca la pena contrastar el trabajo, y el pipeline cuando tu almacén tenga memorias suficientes como para empezar a repetirse.
Los seis pasos de abajo siguen las capas en orden. Cada uno funciona con cualquier harness de agente; ConvOps es el ejemplo porque es donde ejecutamos el nuestro. Crea una cuenta gratuita de ConvOps(se abre en una pestaña nueva) y conecta tu agente(se abre en una pestaña nueva) para seguir los pasos.
Pasos
Dale memoria a cada trabajo
Pon un paso de recuperación al principio de cada flujo de trabajo y guarda memorias tipadas mientras avanza el trabajo: decisiones, correcciones, trampas, procedimientos. Decide qué alimenta cada categoría. Activa la captura automática de decisiones, progreso y correcciones, que permanece desactivada hasta que la actives en tu espacio de trabajo.
Haz de Learning Capture el último paso
Añade a cada flujo de trabajo un último paso global, Learning Capture, que guarde decisiones, trampas y patrones y registre dónde vive el código nuevo. Deja que se salte con «no learnings to store» (no hay aprendizajes que guardar) cuando una ejecución no haya enseñado nada nuevo.
Edita el flujo de trabajo, no el prompt
Convierte cada lección repetida en una línea del paso que la necesitaba, o en un paso nuevo. Haz un cambio quirúrgico cada vez, valídalo, vuelve a leerlo y guarda el motivo en una memoria, no en el paso.
Añade pasos que detecten carencias
Descubre los estándares que rigen el trabajo antes de empezarlo y señala carencias, comprueba el cumplimiento después y ejecuta una comprobación final de carencias que guarde candidatos a patrones de fallo. Evalúa cada arreglo como clase o como caso aislado, y mantén para las revisiones de planes un registro de fallos de incidentes reales, limitado a 15 entradas por sección.
Registra la fricción en cuanto aparezca
Cuando algo no salga a la primera, avisa a una persona, busca una tarea existente y registra una con la etiqueta discovered-during-execution; después termina la tarea en la que estás. Lleva a los hooks del harness de tu agente las reglas que no pueden fallar nunca, como bloquear el borrado de archivos.
Ejecuta el pipeline de memoria y mueve un punto de aprobación
Consolida las memorias cada mes por categoría, con un simulacro primero, promueve los candidatos al registro, retira las entradas que nunca saltan y propón cambios en estándares, flujos de trabajo, agentes y archivos de instrucciones. Después pasa un punto de aprobación predecible a una decisión registrada del agente, y deja los merges y la publicación en manos de una persona. Crea una cuenta gratuita de ConvOps en https://my.convops.app/register y conecta tu agente en https://convops.app/connect. ¿Quieres construirlo con tu equipo? Reserva una sesión de descubrimiento gratuita en https://neomanex.com/es/services.
Preguntas frecuentes
¿Qué es un sistema de IA que se mejora a sí mismo?
Un sistema de IA que se mejora a sí mismo es un repositorio de estándares, un almacén de memoria y flujos de trabajo con puntos de aprobación que convierten las lecciones de cada trabajo terminado en reglas que lee el siguiente. ConvOps aloja los flujos de trabajo, los puntos de aprobación y el almacén de memoria sobre los que funciona el nuestro. Aprende en seis capas, desde la memoria que se recupera antes de cada trabajo hasta un pipeline que revisa todo el sistema. El modelo no cambia nunca; cambian los archivos, los pasos y las memorias que lo rodean.
¿Para quién es un sistema de IA que se mejora a sí mismo?
Un sistema de IA que se mejora a sí mismo es para responsables de ingeniería, ingenieros de plataforma y de operaciones y fundadores técnicos que usan agentes de IA en trabajo recurrente de desarrollo, contenido u operaciones. ConvOps ejecuta ese trabajo como tareas en flujos de trabajo con puntos de aprobación, así que un error repetido se convierte en una regla escrita con constancia de quién la aprobó, y el siguiente trabajo lee esa regla antes de empezar.
¿Es posible una IA que se mejora a sí misma sin reentrenar el modelo?
Sí. En ConvOps las lecciones acaban como memorias tipadas, pasos de flujos de trabajo y estándares escritos, y los pesos del modelo no se tocan nunca, así que cada lección sigue siendo legible y reversible. El sistema no edita el modelo ni sus propias salvaguardas: una persona aprueba los merges, la publicación, las reglas nuevas y las reestructuraciones de los archivos de instrucciones, y un hook bloquea el borrado de archivos.
¿Cómo construyo un sistema de IA que se mejora a sí mismo?
Crea una cuenta gratuita de ConvOps en my.convops.app/register y conecta el agente que ya usas. Después pon un paso de recuperación al principio y un paso Learning Capture al final de un flujo de trabajo, y activa la captura automática de decisiones y correcciones. Añade pasos que detecten carencias comparando el trabajo con tus estándares, registra la fricción como tareas en cuanto aparezca y ejecuta una consolidación mensual de tus memorias.
¿Cómo se evita que las reglas y las memorias crezcan sin límite?
ConvOps guarda las memorias en categorías concretas, sustituye las repeticiones al guardarlas y fusiona los casi duplicados en una consolidación mensual con una similitud de 0,85. La contabilidad de las tareas queda fuera de la recuperación entre tareas. Un estándar solo gana una regla para una clase de errores, nunca para un caso aislado. El registro de fallos admite como máximo 15 entradas por sección, y una entrada que solo devuelve PASS o N/A durante 5 planes consecutivos se retira.
¿Quién aprueba un cambio en las reglas?
En ConvOps depende de la capa. Los agentes guardan memorias sin aprobación. Una carencia de clase en los estándares la juzga el agente y queda registrada como una actividad que una persona puede leer. Los cambios pequeños en archivos de instrucciones y estándares, como una línea o un valor desfasado, entran directamente según un estándar. Las reglas nuevas, las reestructuraciones y los cambios en los flujos de trabajo necesitan a una persona, y los merges y la publicación siempre la esperan.
¿En qué se diferencia un sistema de IA que se mejora a sí mismo de un archivo de aprendizajes?
Un archivo de aprendizajes es un cajón de sastre que crece sin límite, y por eso dejamos obsoleta nuestra propia categoría de memoria learnings para las memorias nuevas. En ConvOps cada lección es tipada y acaba en la capa que la usa: una decisión que se recupera, un paso de flujo de trabajo, un estándar o una entrada del registro de fallos. Tiene un límite y se consolida, y la recuperación devuelve solo las memorias que encajan con el trabajo.