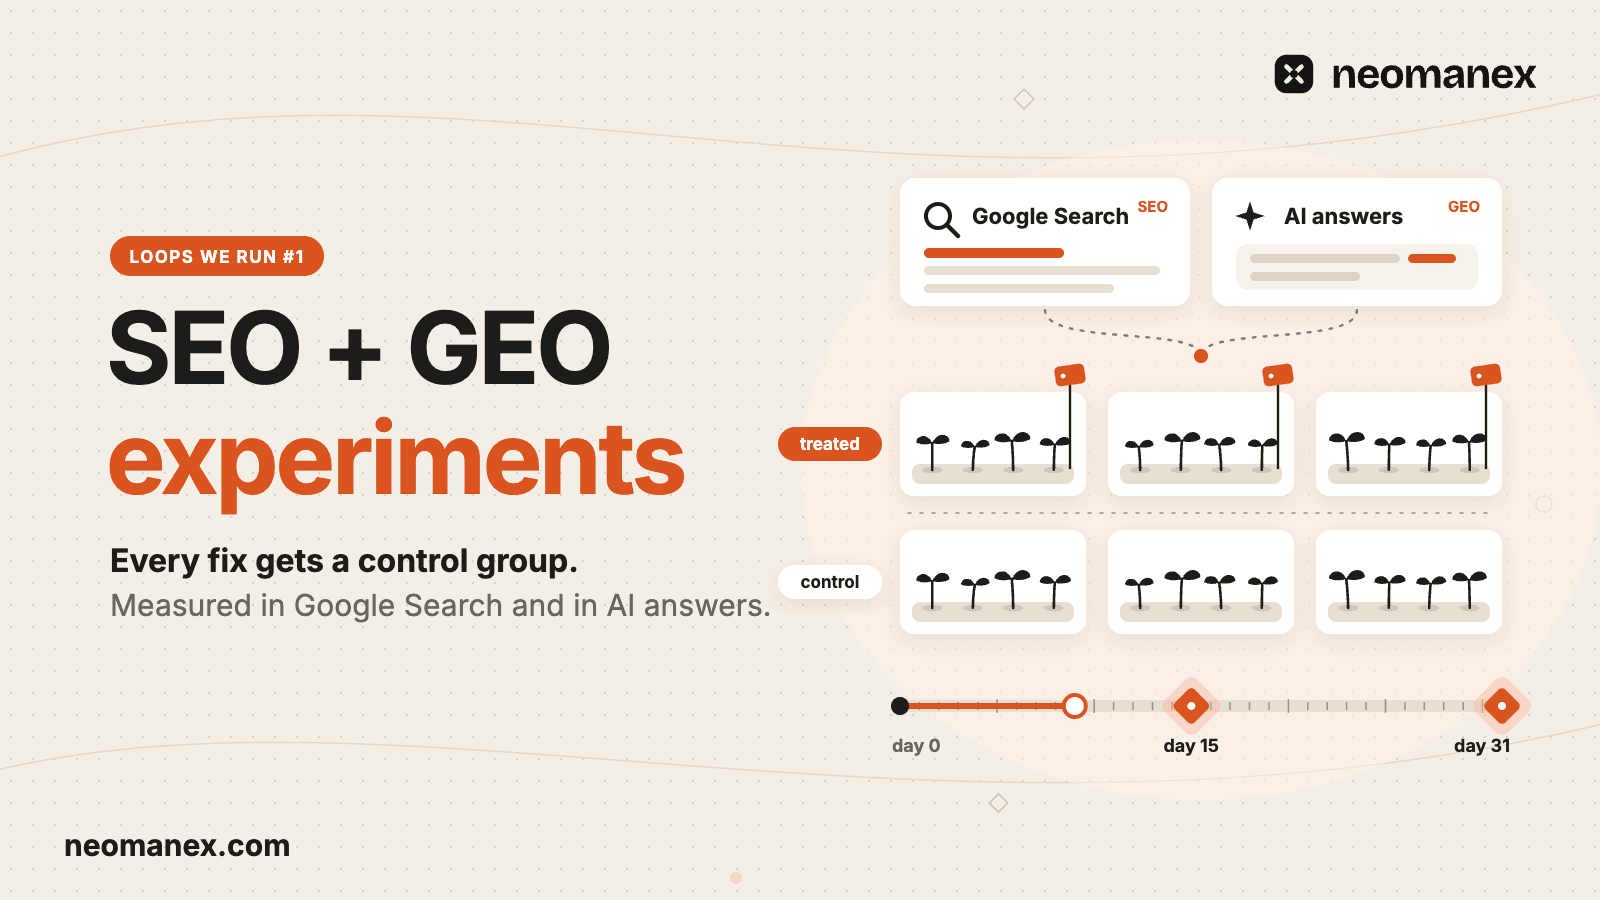
Lo que serás capaz de hacer
- Montar un repositorio de registro con una ficha por experimento SEO
- Dividir las familias de páginas en grupos tratado y de control con una asignación aleatoria con semilla
- Leer un veredicto de diferencia en diferencias y decidir si mantener, prorrogar o revertir
- Programar un pulso diario que tome instantáneas de los datos de Search Console y despierte los experimentos que vencen
- Saber qué tipos de corrección puede medir tu sitio y cuáles no
Ideas clave
- Una corrección SEO solo cuenta cuando un grupo de control aleatorio de páginas sin tocar se ha movido menos que las páginas tratadas.
- Escribe en el registro la hipótesis, la métrica, los grupos de páginas y la regla de descarte antes del cambio, y no los edites nunca después.
- Un script calcula todas las métricas y los veredictos; Claude Code ejecuta los pasos y lee el resultado.
- No concluyente es un veredicto normal en un sitio pequeño: el bucle se prorroga una vez hasta el día 59 y después se cierra.
- Un pulso diario marca el ritmo: los experimentos quedan aparcados hasta su fecha de vencimiento y se despiertan en el día 15 y en el día 31.
Qué hace el bucle de experimentos SEO
Los experimentos SEO solo te dicen algo cuando las páginas que cambiaste se movieron más que un grupo de páginas sin tocar. Pasamos todas las correcciones SEO de nuestro sitio por esa regla. Claude Code escribe la ficha del experimento antes de tocar una página, cambia un grupo tratado elegido al azar, deja intacto un grupo de control equivalente, y un script compara los dos en el día 15 y en el día 31. ConvOps lo ejecuta todo como tareas programadas con flujos de trabajo, y una persona hace el merge de cada cambio. Es uno de los bucles con los que dirigimos nuestra empresa.
Un experimento SEO prerregistrado es un cambio de página cuya hipótesis, métrica, grupos de páginas y regla de descarte se registran en un commit antes de publicar el cambio, y nunca se editan después. Una familia de páginas es una página más sus variantes de idioma (en, es, de). Las familias son la unidad que el bucle asigna al grupo tratado o al de control.
Todas las pantallas y cifras que verás a continuación usan datos de ejemplo de Tidewell, una app ficticia de facturación en tidewell.example.com.
| Parte | Qué es |
|---|---|
| Disparador | Cuatro programaciones. Nadie lanza una ejecución a mano |
| Entradas | Datos de páginas de Search Console, visitas de rastreadores de IA y visitas humanas de la analítica del sitio |
| Entorno del agente | Claude Code, una sesión aislada por ejecución |
| Orquestador | Tareas, flujos de trabajo y programaciones de ConvOps |
| Salidas | Instantáneas, fichas de experimento, informes de investigación y de estrategia, todo en un único repositorio git de registro |
| Puertas humanas | Cada merge en el sitio y cada informe de estrategia |
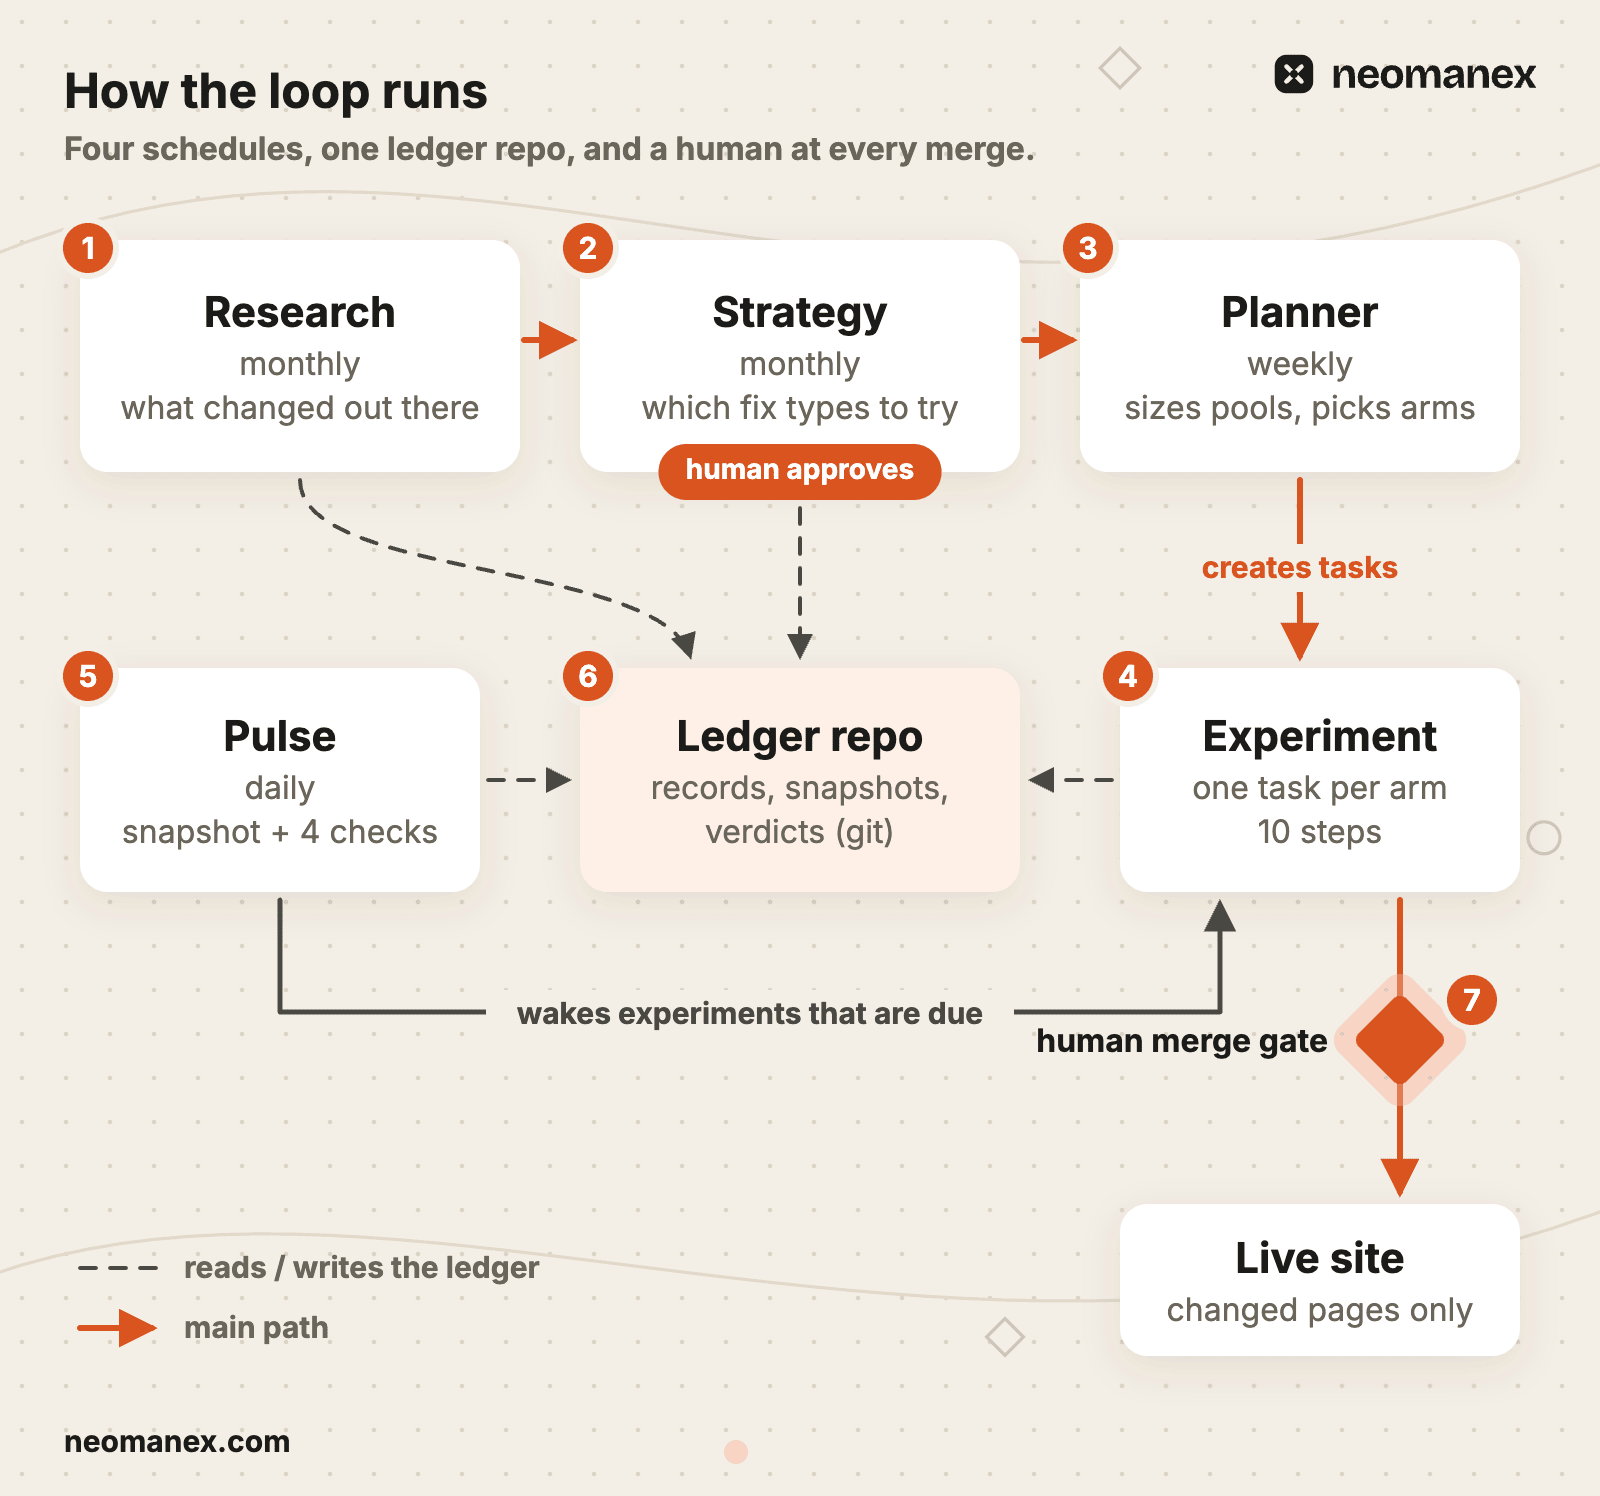
Lo mueven cuatro programaciones: un pulso diario, un planificador semanal y una investigación y una estrategia mensuales.
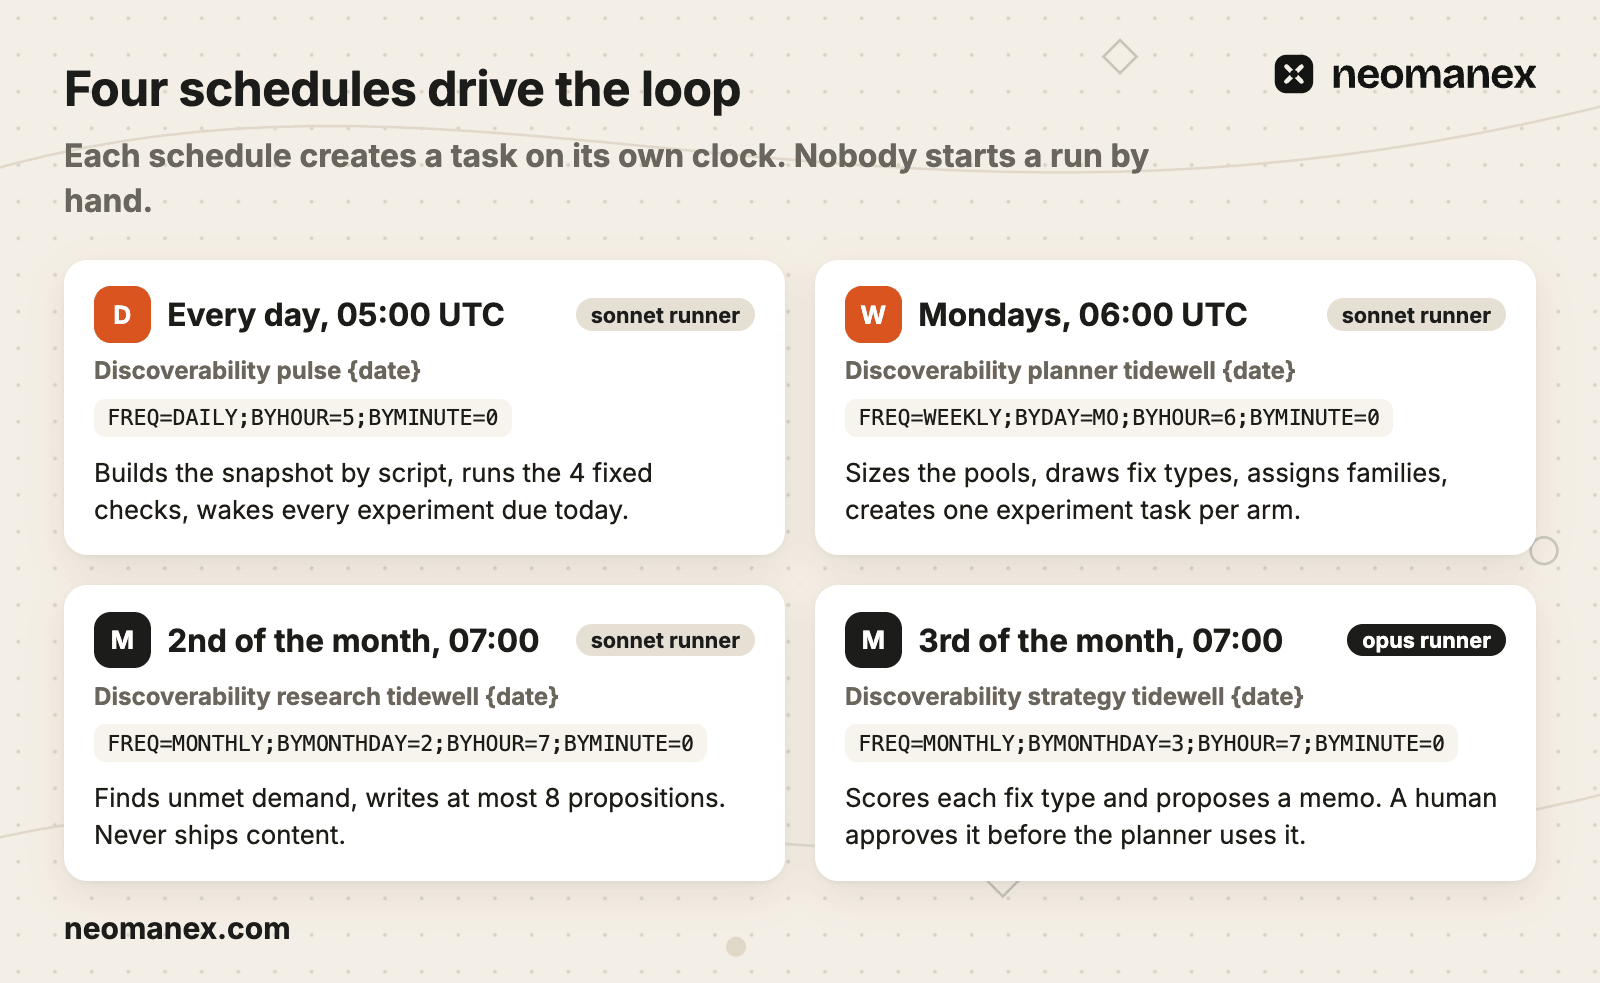
Por qué lo construimos: una página es ruido, y los agentes se inventan cifras
La mayoría de los tests SEO en sitios pequeños te engañan: una página oscila un tercio sin que haya cambiado nada. Las actualizaciones de Google, la estacionalidad, el ritmo de rastreo y las caídas generales del sitio mueven una página por sí solos. Un gráfico de antes y después de una sola página no distingue una corrección de una semana tranquila.
La respuesta es un grupo de control del mismo sitio, asignado al azar en el mismo momento. Los dos grupos afrontan las mismas condiciones, así que la diferencia entre ellos es el efecto. La guía de Google sobre pruebas dice que el tiempo que necesita una prueba fiable depende del tráfico que recibe el sitio (Google Search Central, 2025(se abre en una pestaña nueva)). Este bucle nunca cambia una URL ni añade una redirección, y un sitio pequeño tiene 28 días medidos más una prórroga.
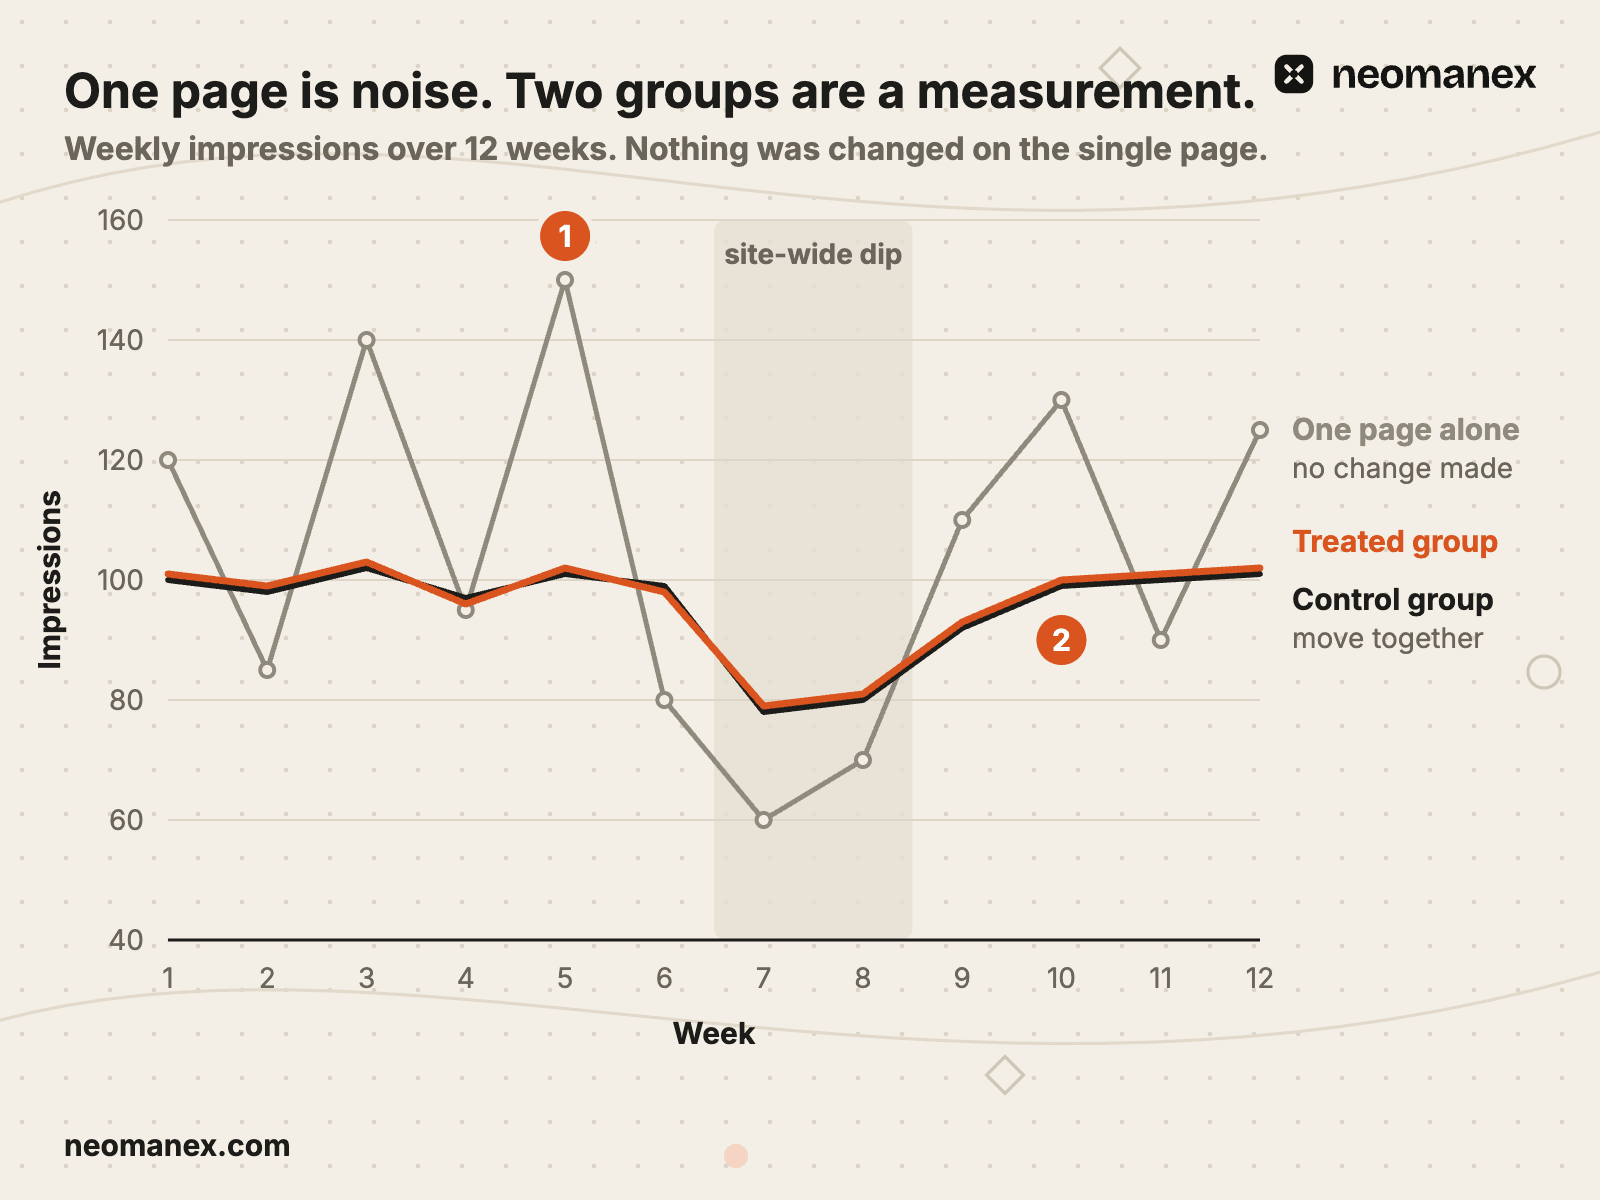
El segundo problema es el agente. Pide a un agente que «revise los datos» y calculará ratios, los comparará con referencias que se ha inventado y recomendará cambios. El nuestro hizo exactamente eso. Por eso un script calcula todas las métricas y los veredictos, y Claude Code ejecuta los pasos y lee los resultados.
Si quieres un bucle programado como este, con pasos, puertas y aprobaciones humanas, descubre cómo lo ejecuta ConvOps(se abre en una pestaña nueva).
Cómo funciona: cuatro programaciones, cinco flujos de trabajo
Un bucle de experimentos solo es tan honesto como su reloj, así que aquí nada depende de que alguien se acuerde.
| Programación | Cuándo (UTC) | Qué hace |
|---|---|---|
| Pulso | Cada día a las 05:00 | Pide a un script que construya una instantánea con los datos de Search Console de hace tres días (suelen estar disponibles al cabo de 2 o 3 días, Google Search Central, 2025(se abre en una pestaña nueva)), ejecuta cuatro comprobaciones fijas, despierta cada experimento que vence hoy y señala los atascados |
| Planificador | Cada lunes a las 06:00 | Dimensiona los pools, elige tipos de corrección, asigna familias y crea una tarea de experimento por brazo |
| Investigación | El día 2 de cada mes a las 07:00 | Encuentra demanda no cubierta, escribe como mucho 8 propuestas y nunca publica contenido |
| Estrategia | El día 3 de cada mes a las 07:00 | Puntúa cada tipo de corrección y propone un informe para que lo apruebe una persona |
El planificador solo usa un informe de estrategia cuya tarea de aprobación esté completada. Si no lo hay, mantiene sus valores por defecto. Un informe dirige semanas de experimentos, así que lo firma una persona.
Un pool es el conjunto de familias en las que una métrica se puede medir: visitas de rastreadores de IA, impresiones de Google, posición o porcentaje de clics. Un brazo es un tipo de corrección aplicado a un grupo de familias de páginas. Una oleada es el conjunto de brazos que arrancan juntos un mismo lunes y comparten un grupo de control.
Cada brazo es su propia tarea con un flujo de trabajo de 10 pasos, un grafo de pasos y puertas, la forma que describimos en ¿Qué es graph engineering?.
| Paso | Quién lo ejecuta | Puerta |
|---|---|---|
| Register (registro) | Claude Code | Un tipo de corrección real y una ficha con commit, o se detiene |
| Implement (implementación) | Claude Code | Una sola variable, solo familias tratadas, las comprobaciones del producto pasan |
| Static review (revisión estática) | Claude Code | Diff solo en las tratadas, longitudes de título y meta, un único H1. Dos rechazos abren un bug |
| Ship (envío) | Persona | Una persona abre el cambio y hace el merge |
| Go live, día 0 (puesta en producción) | Claude Code | Tratamiento verificado en el HTML de producción. Si no está en producción en 14 días: anulado |
| Interim, día 15 (revisión intermedia) | Script de veredicto, leído por Claude Code | Revierte si hay daño, anula si hay una actualización de Google, para antes de tiempo si hay una victoria clara en visitas de IA y, si no, continúa hasta el día 31 |
| Final, día 31 (revisión final) | Script de veredicto, leído por Claude Code | Victoria, derrota o no concluyente |
| Rollback (reversión) | Claude Code y después una persona | Reversión en una rama, una persona hace el merge y la siguiente ejecución confirma que está en producción |
| Act (actuar) | Claude Code | Una victoria abre una idea de replicación, nunca un experimento nuevo |
| Learn (aprender) | Claude Code | Una línea de lección en la ficha |
Cada merge espera a una persona, la puerta humana que describimos en Cómo construir sistemas de IA con human in the loop.
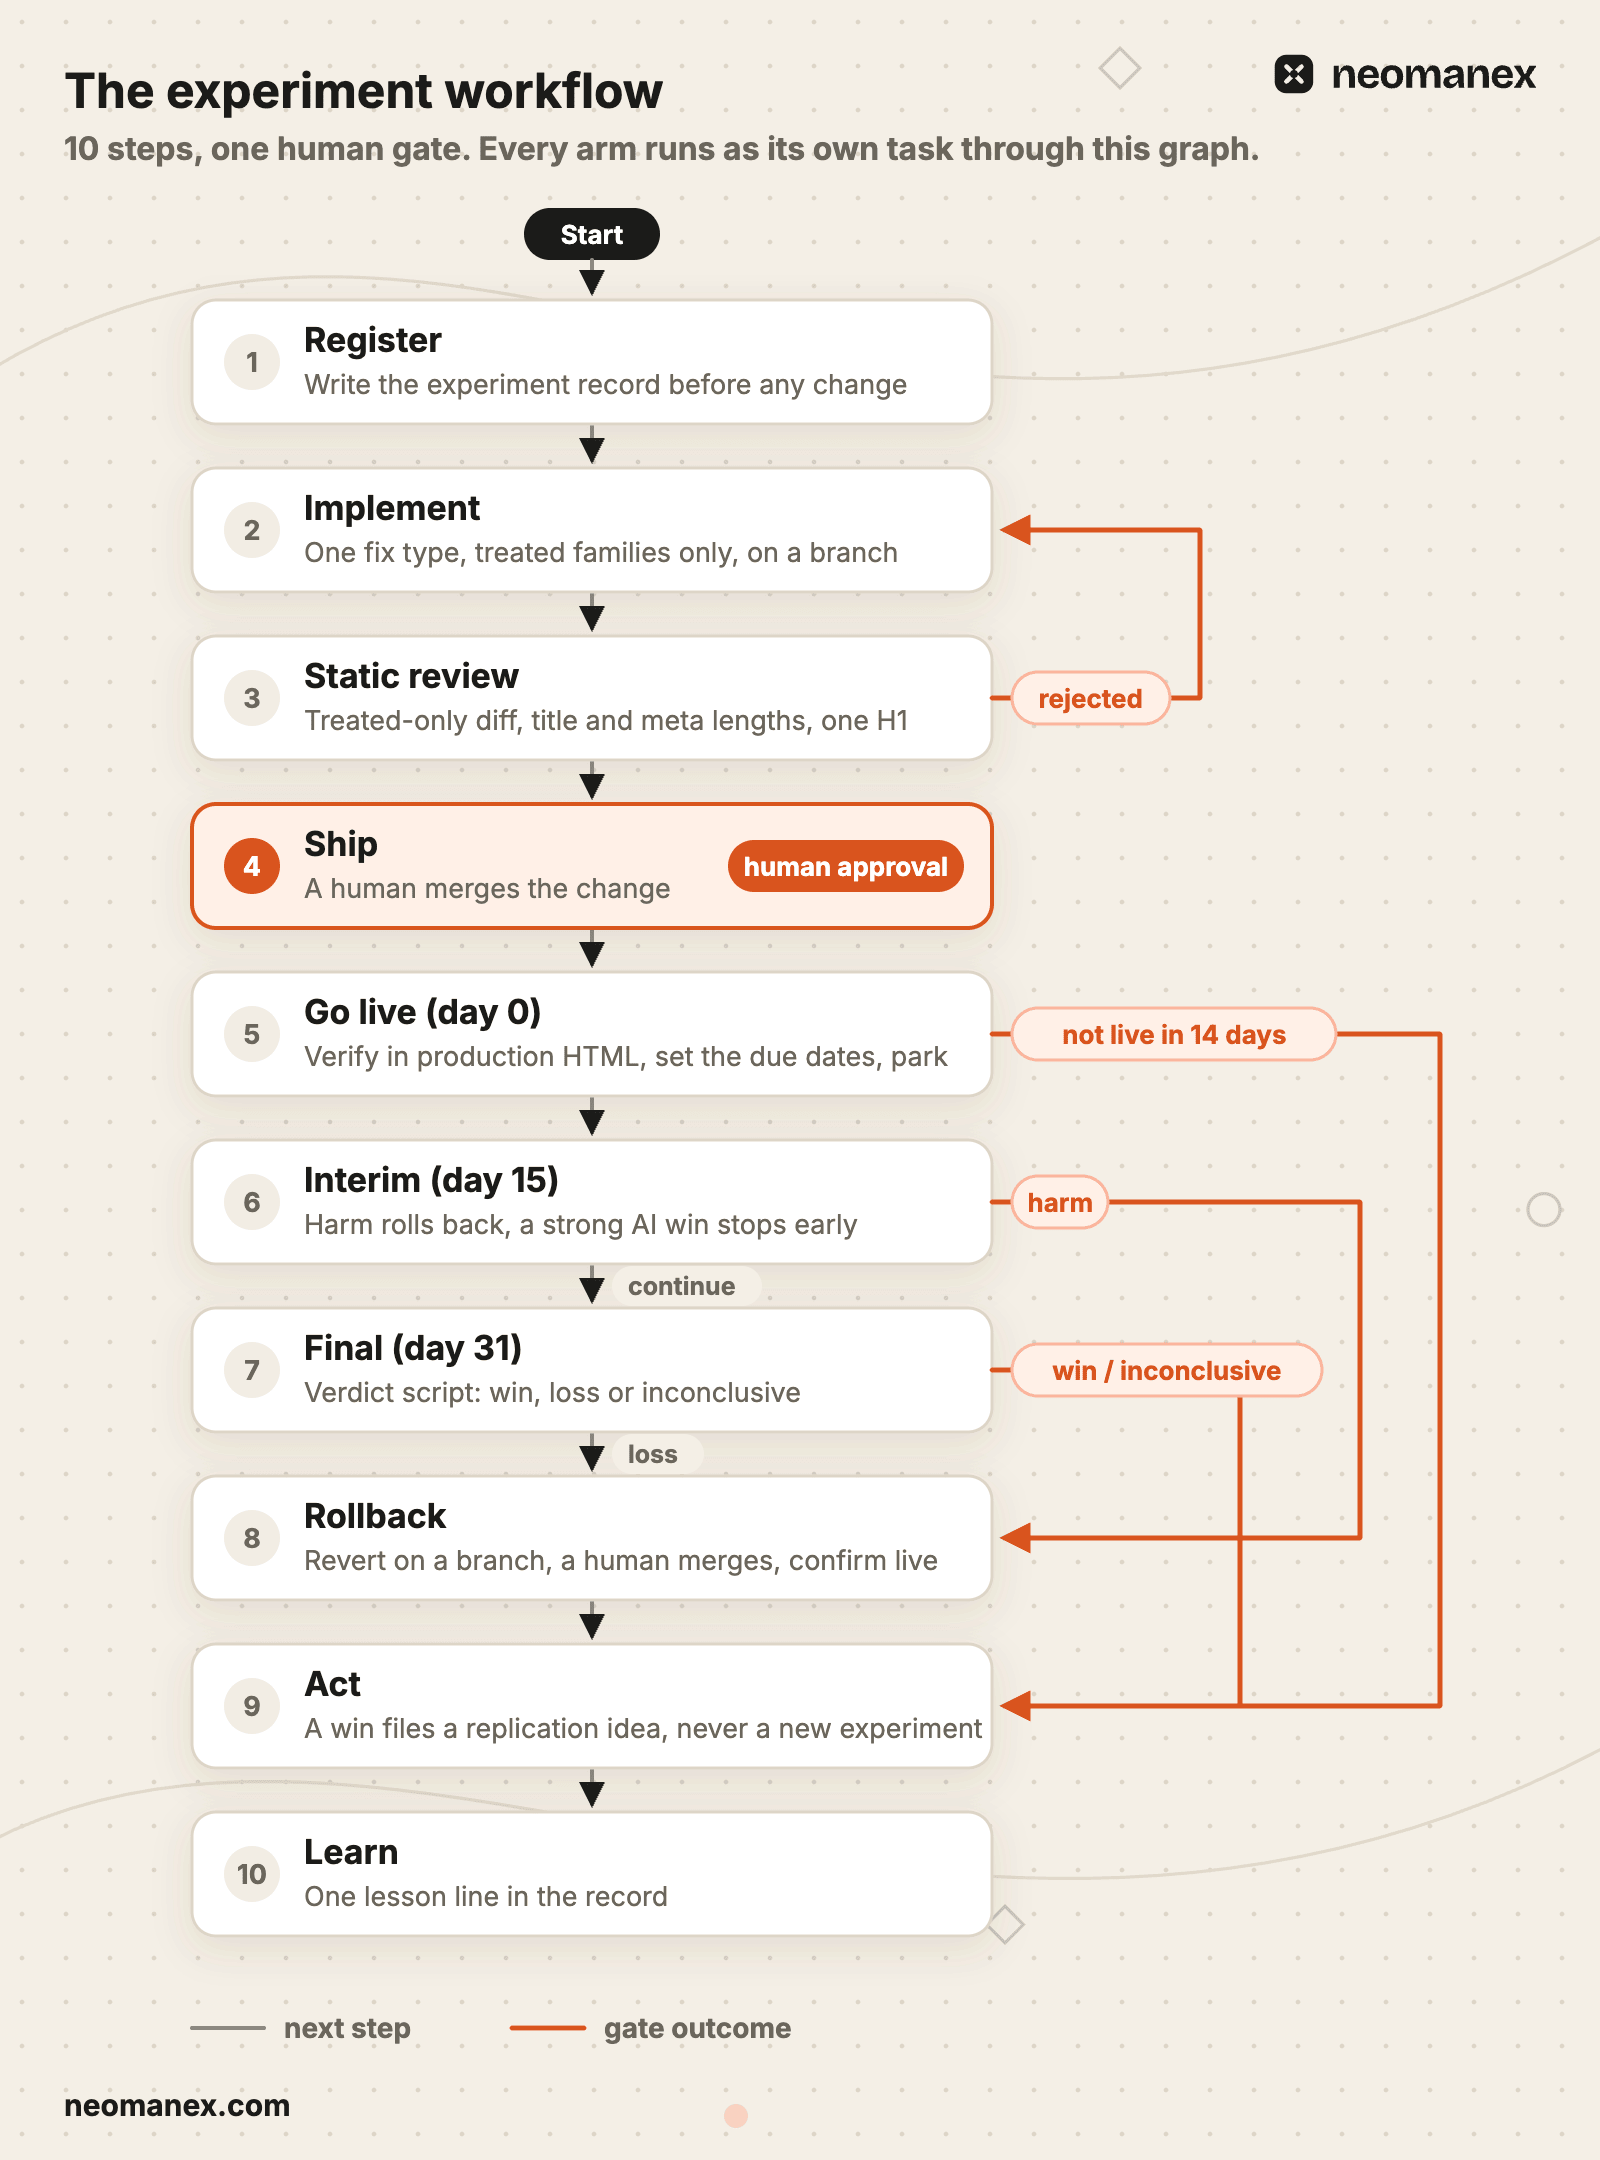
Entre revisiones, la tarea queda aparcada hasta su fecha de vencimiento y el pulso diario la despierta.
Nuestro bucle de web que se autorrepara usa el mismo patrón para el QA del sitio: un barrido semanal registra bugs, y cada bug tiene su propia ejecución de reparación que solo se cierra después de volver a comprobarlo.
Una ejecución paso a paso (datos de ejemplo)
Esta es una ejecución completa de Tidewell, desde el planificador del lunes hasta el veredicto del día 31.
Lunes: el planificador abre una oleada
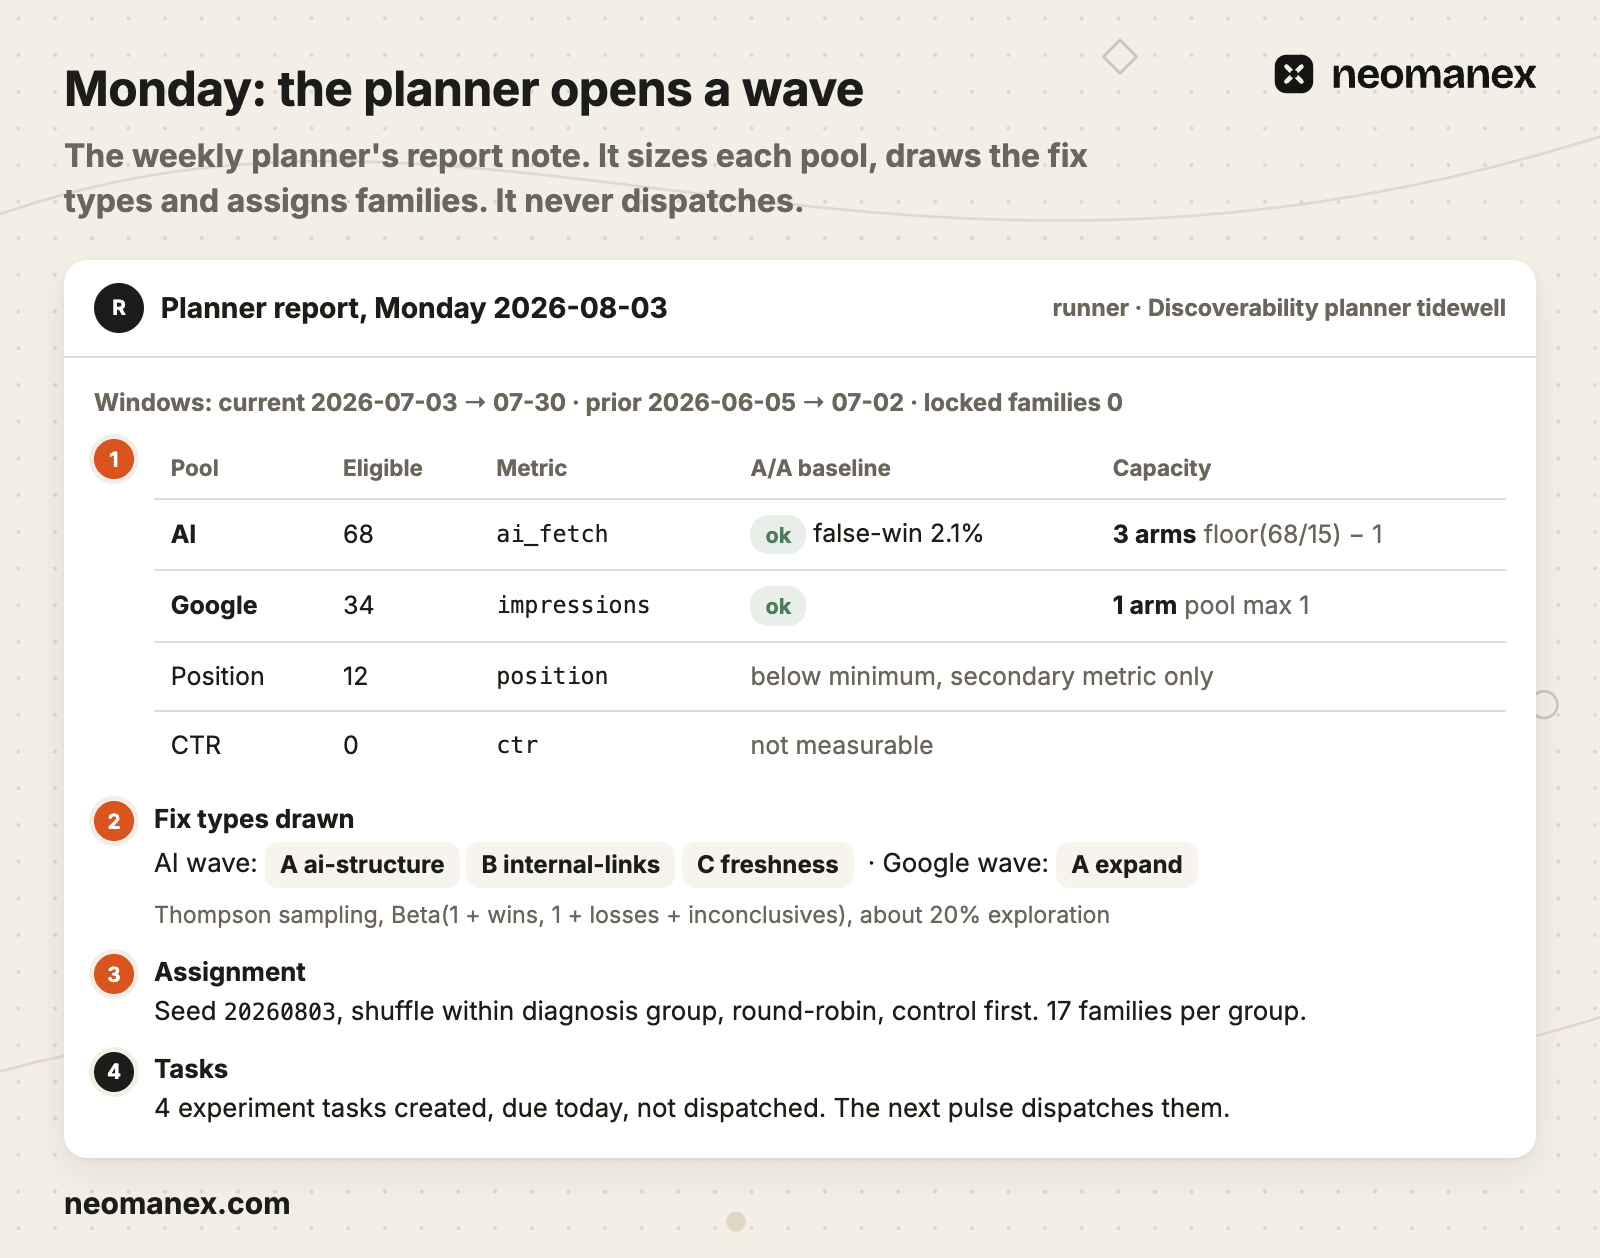
El planificador cuenta las familias elegibles y la capacidad de brazos por pool (indicador 1). La capacidad es el número de elegibles dividido entre 15, redondeado hacia abajo, menos uno: las 68 familias del pool de IA de Tidewell permiten 3 brazos. El pool de Google tiene un máximo de 1 brazo, y cada pool lleva una sola oleada activa a la vez.
Un pool solo recibe una oleada cuando su línea base A/A histórica está bien. Esa línea base reproduce datos pasados con divisiones falsas y cuenta con qué frecuencia el ruido por sí solo parece una victoria (un 2,1 % en el ejemplo). Un pool que no la supera no recibe oleada, porque cualquier veredicto ahí sería ruido.
Los tipos de corrección que más han ganado se eligen más a menudo (indicador 2), y alrededor del 20 % de los brazos se reserva para tipos de corrección sin veredicto (muestreo de Thompson, Beta(1 + victorias, 1 + derrotas + no concluyentes)).
La asignación usa la fecha como semilla aleatoria, baraja dentro de cada grupo de diagnóstico y reparte las familias por turnos empezando por el control (indicador 3). Cada grupo recibe 17 familias. Es el siguiente pulso, y no el planificador, el que despacha las cuatro tareas.
Register: primero la ficha
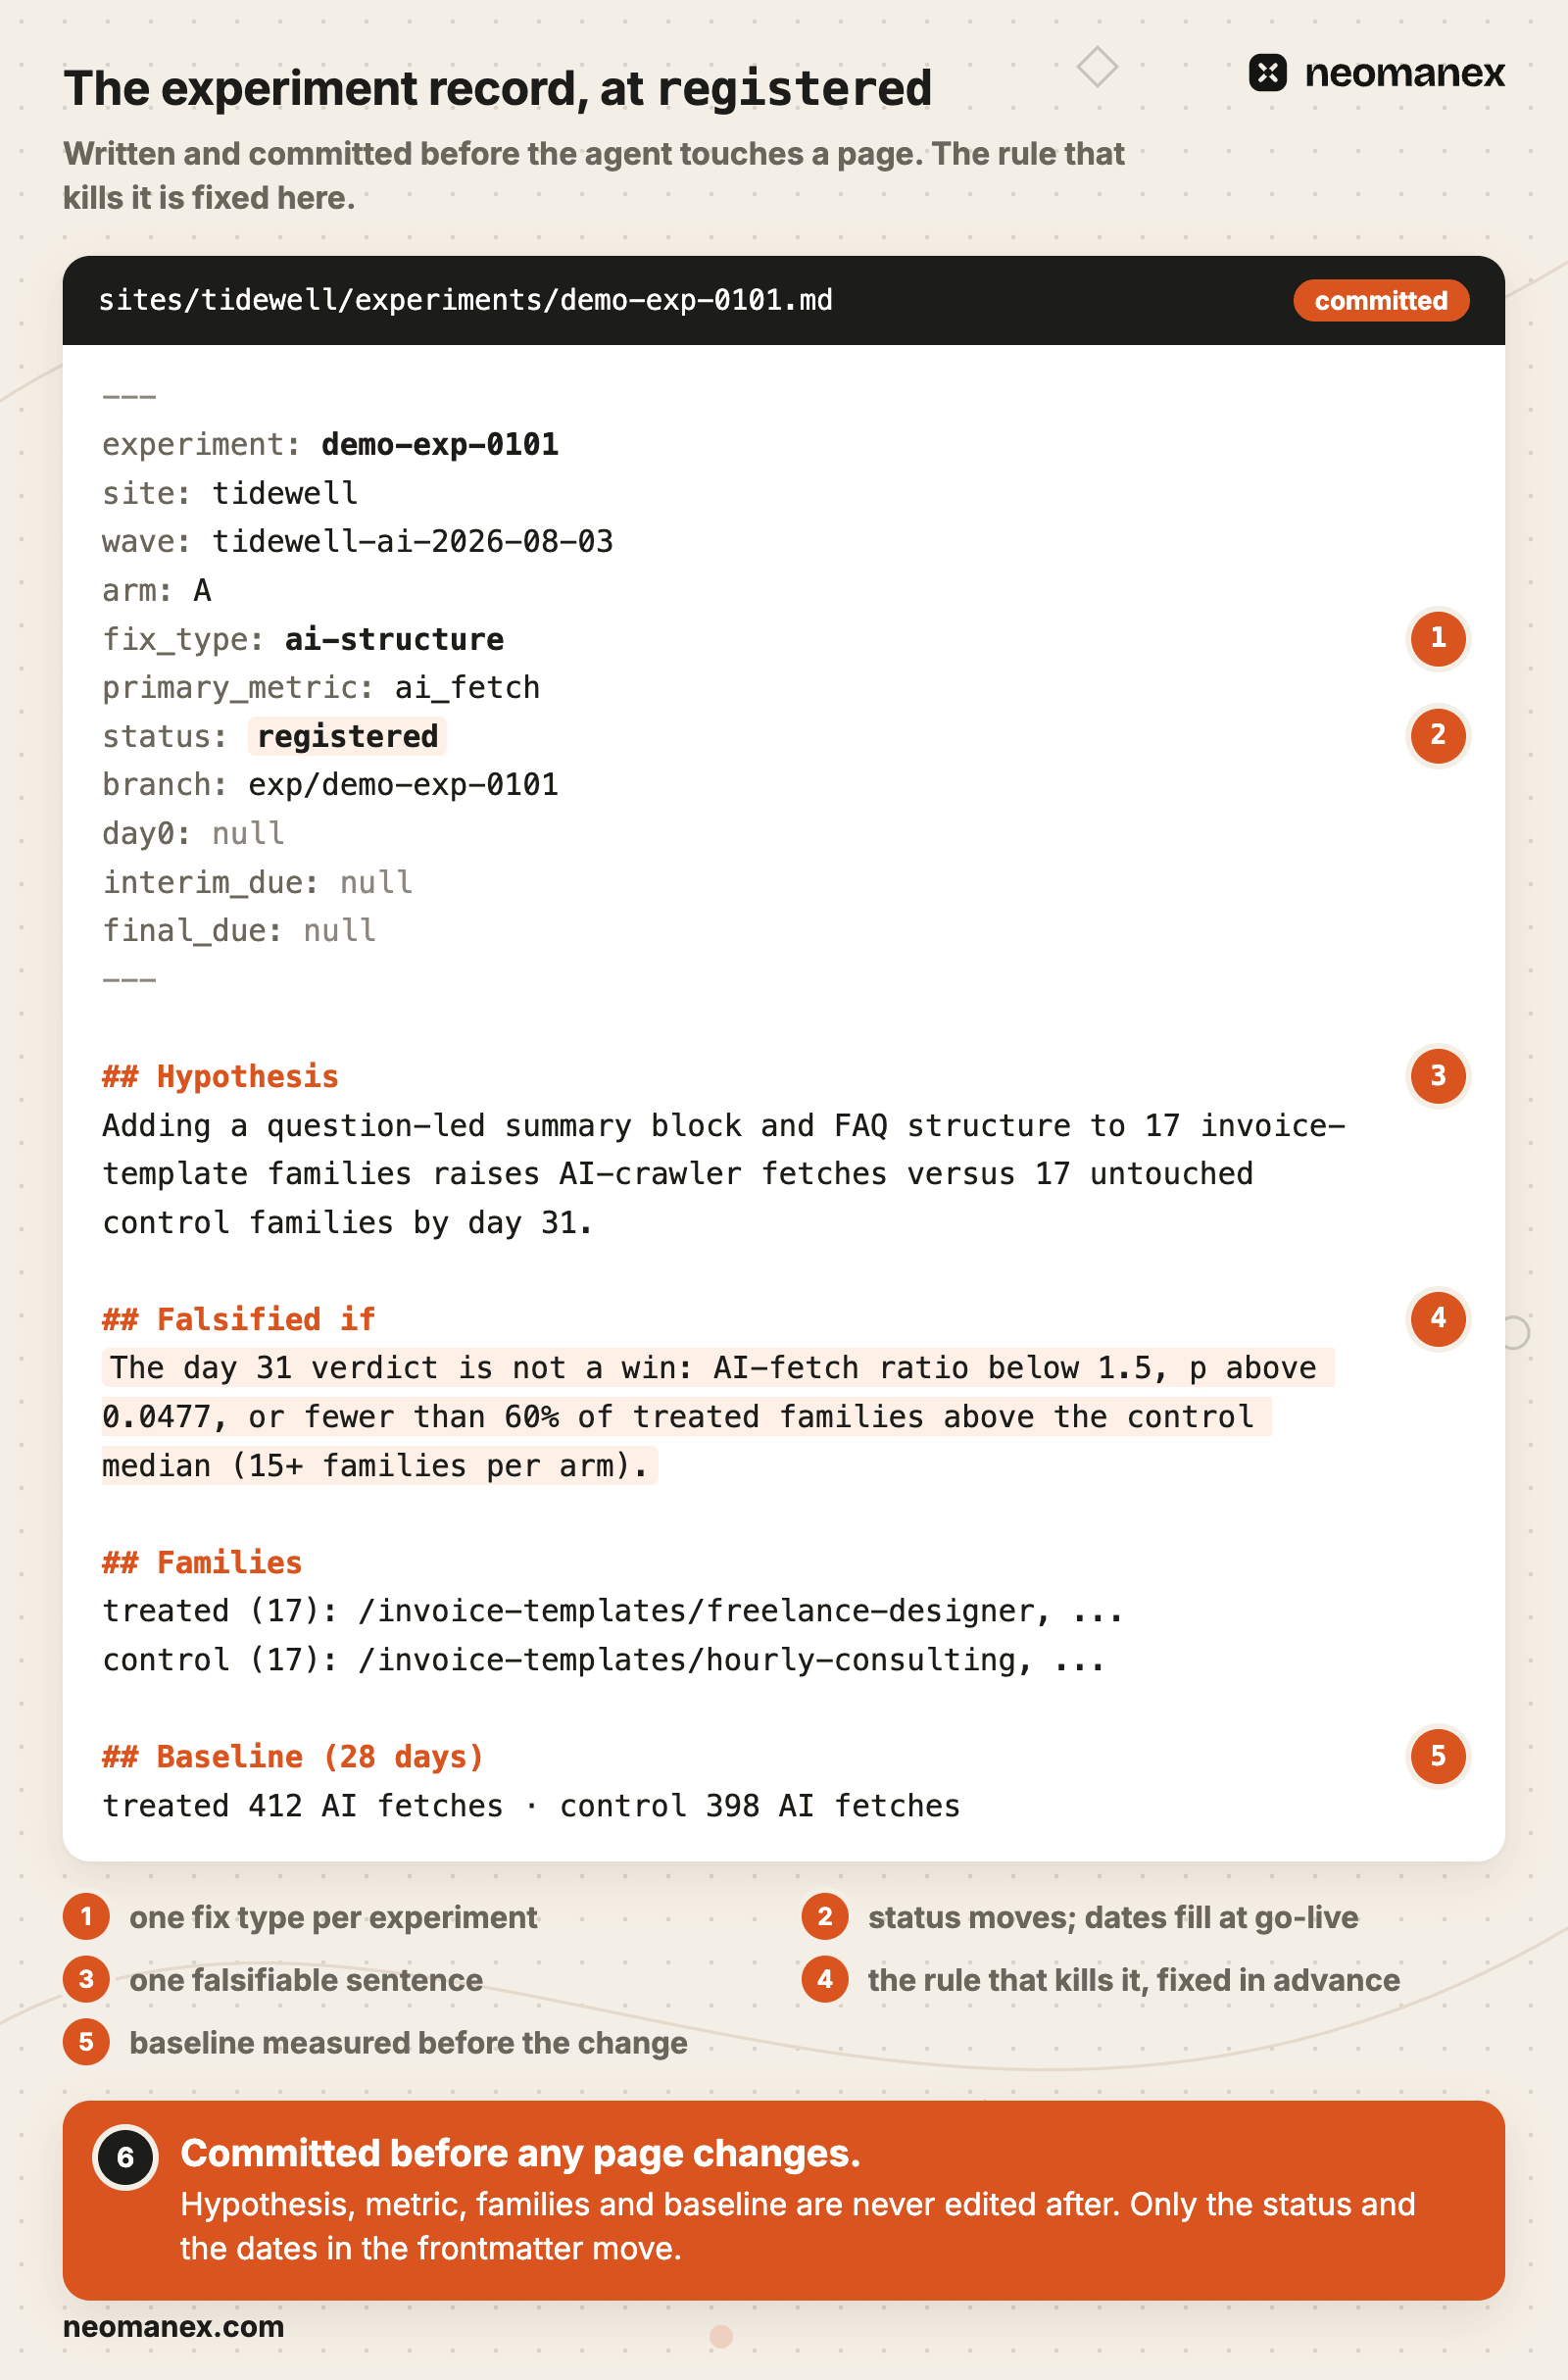
La ficha contiene un tipo de corrección (indicador 1), una frase falsable (3), la regla que la descarta (4) y una línea base de 28 días (5). Después del commit, solo se mueven el estado y las fechas. Prerregistramos porque un agente, igual que una persona, puede encontrar una historia en cualquier cifra a posteriori; una regla de descarte con commit no deja nada que reinterpretar.
Implementación, revisión, envío y puesta en producción
En el brazo A, Claude Code añade un resumen planteado como pregunta y un bloque de preguntas frecuentes a las 17 familias tratadas de plantillas de factura. Esa es la única variable. Nunca toca URL, slugs, redirecciones, el diseño compartido ni los datos, y actualiza la fecha de cada página modificada. La revisión estática pasa y una persona hace el merge. Este es el brazo B de la misma oleada, aparcado después de la puesta en producción.
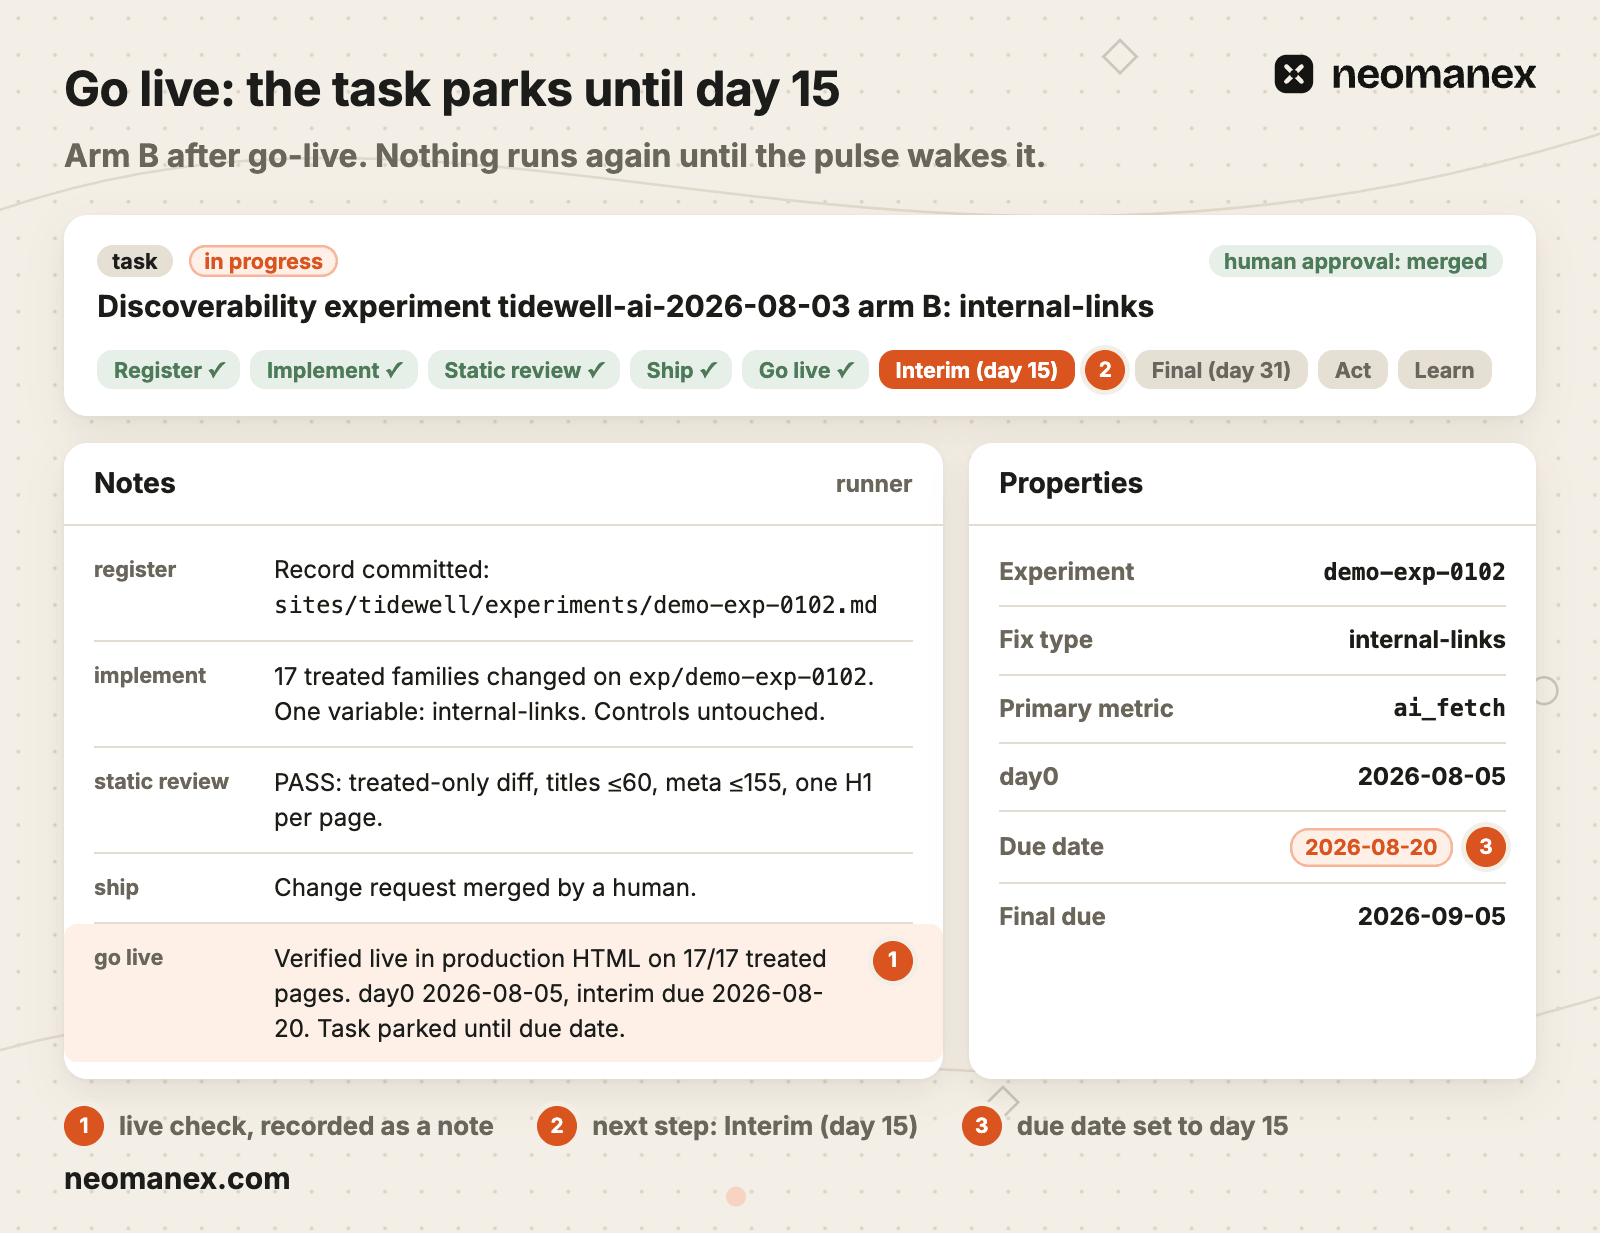
Go live comprueba el tratamiento en el HTML de producción de las 17 páginas (indicador 1). Google dice que el rastreo puede tardar desde unos días hasta unas semanas (Google Search Central, 2025(se abre en una pestaña nueva)), así que el día 0 es el día en que se verifica el cambio en producción, no el día del merge. Go live fija el día 0 y las dos fechas de vencimiento, y después aparca la tarea hasta el día 15 (indicadores 2 y 3).
Días 15 y 31: decide un script
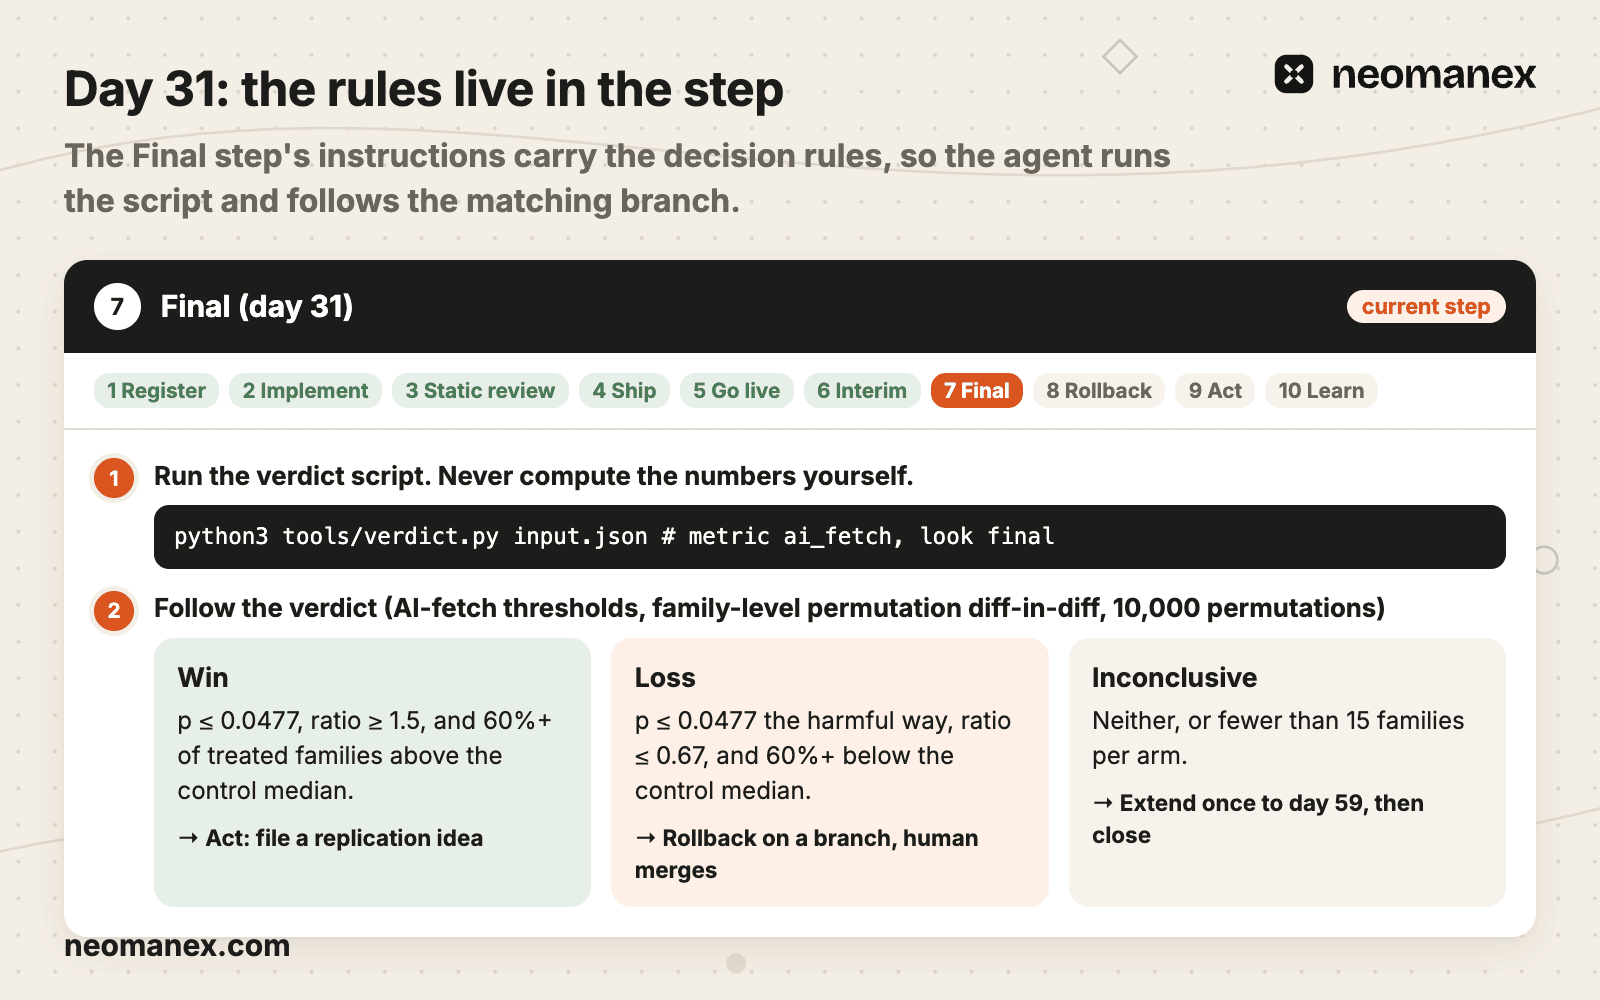
Las reglas de decisión viven en las instrucciones del paso (indicador 2), así que el agente no puede discutirlas. Ejecuta el script de veredicto y sigue la rama que corresponda.
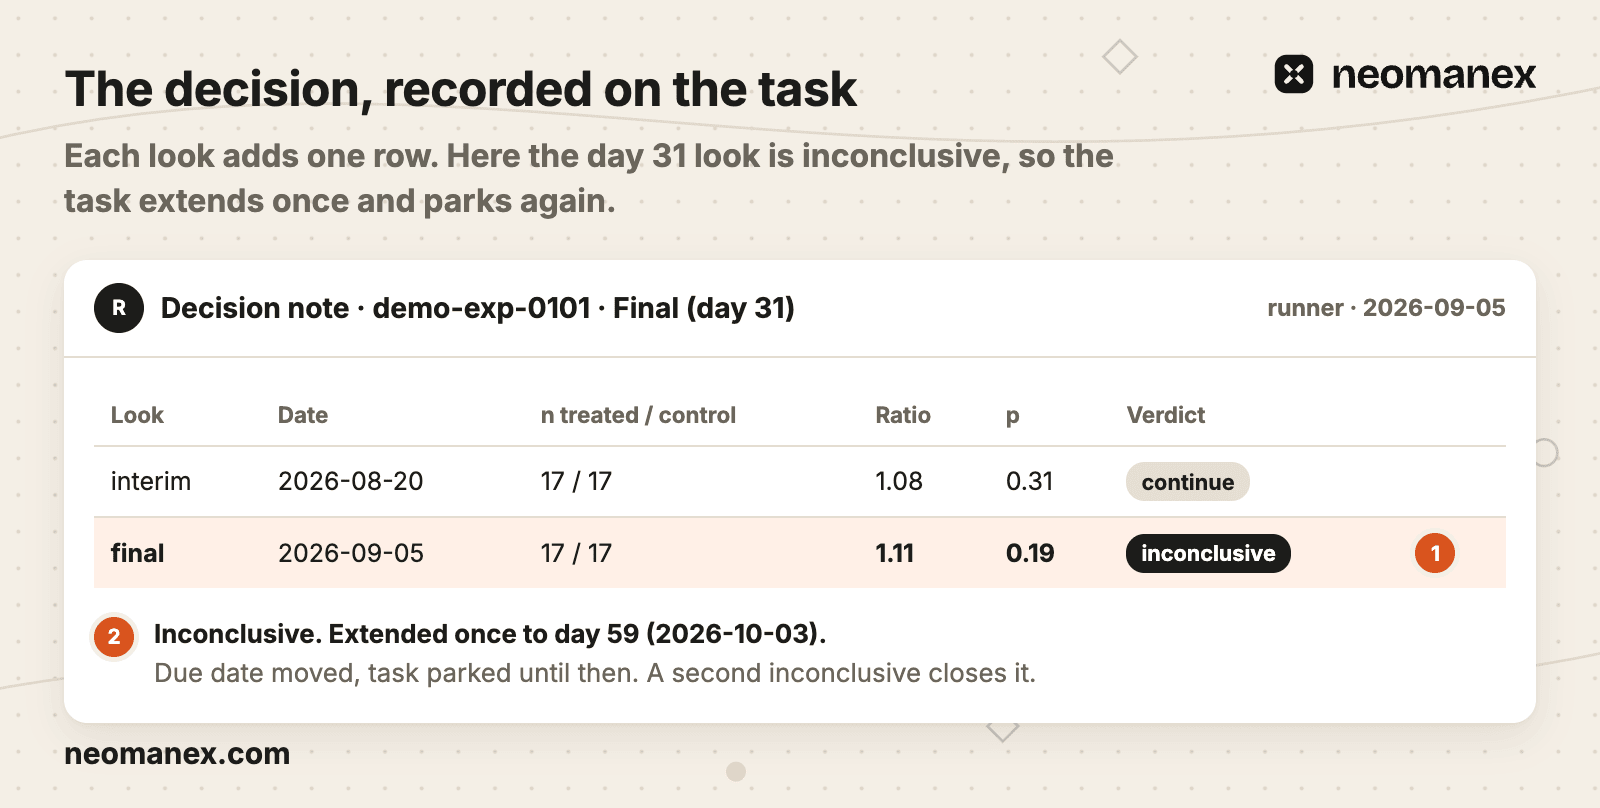
En el día 15, el script da un ratio de 1,08 con p 0,31: no hay daño ni victoria anticipada, así que continúa. En el día 31 da un ratio de 1,11 con p 0,19 (indicador 1): no concluyente, así que la tarea se prorroga una vez hasta el día 59 y vuelve a aparcarse.
Cómo es la salida: el registro
Lo que produce este bucle es el registro, no un gráfico de tráfico.
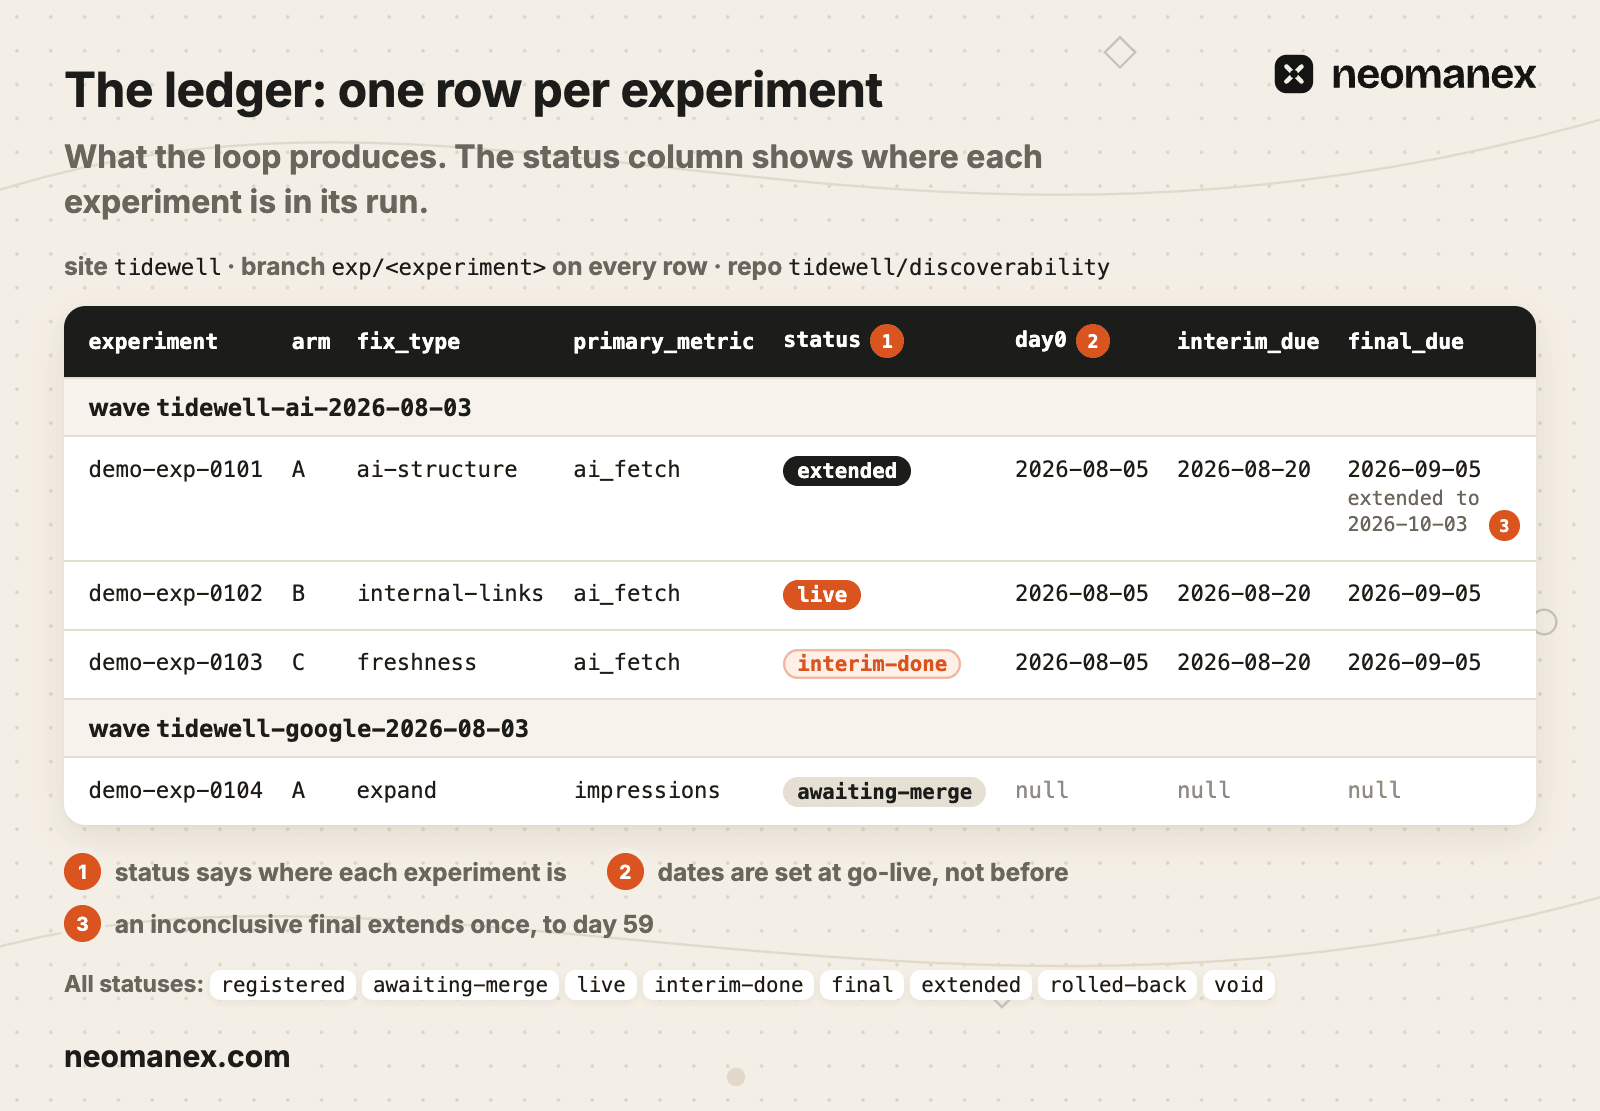
Un experimento pasa por registered, awaiting-merge, live, interim-done y final, y puede terminar como extended, rolled-back o void. Cada brazo es su propia tarea con su propio veredicto.
El script de veredicto ejecuta una diferencia en diferencias por permutación a nivel de familia con 10 000 barajados. El ratio es el cambio del grupo tratado dividido entre el cambio del grupo de control en la misma ventana, así que 1,5 significa que el tratado se movió un 50 % más que el control. Para las visitas de IA (cada métrica tiene sus propios umbrales), una victoria necesita p ≤ 0,0477 en el día 31, un ratio de 1,5 o más y que al menos el 60 % de las familias tratadas esté por encima de la mediana del control. Un resultado de visitas de IA en el día 15 con p ≤ 0,0074 que además cumpla las reglas de ratio y de proporción detiene el brazo antes de tiempo: es definitivo y pasa directamente a Act. Una derrota es la imagen especular (ratio de 0,67 o menos, 60 % por debajo de la mediana), y le sigue la reversión. Cualquier otra cosa, o menos de 15 familias por brazo, es no concluyente.
Los dos umbrales de p reparten un único presupuesto del 5 % de falsas victorias entre las dos revisiones, así que parar antes de tiempo en el día 15 no añade falsas victorias. El ratio y la proporción del 60 % frenan un resultado que es estadísticamente real pero minúsculo, o que depende de una sola página grande.
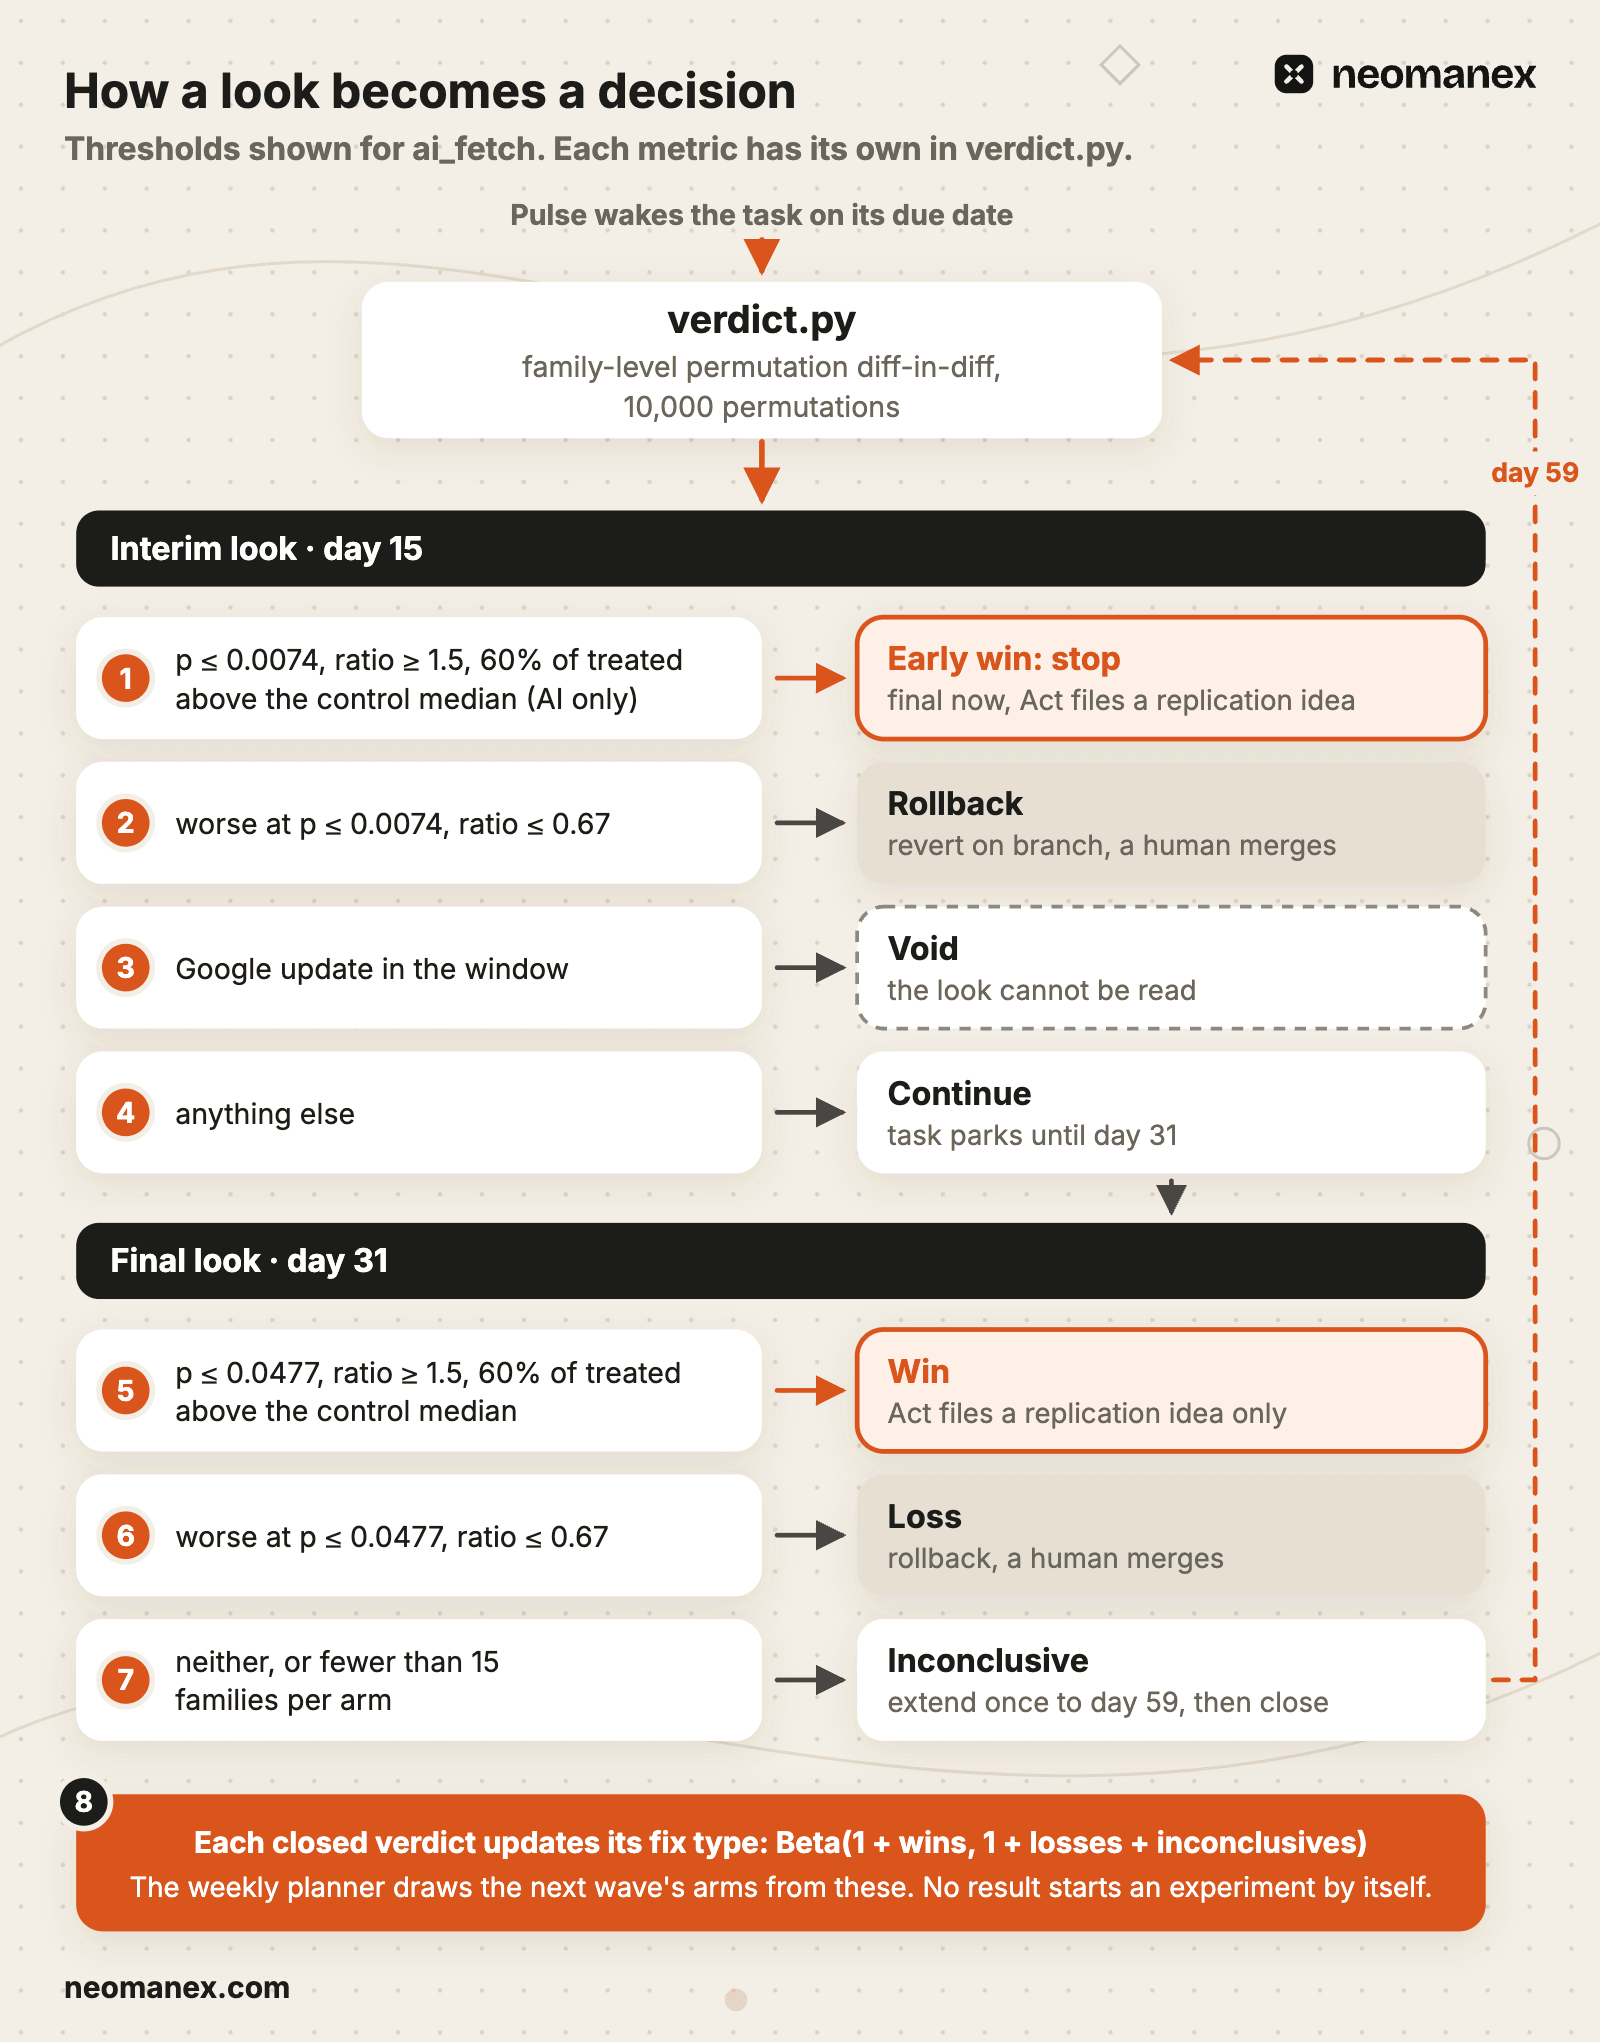
No concluyente no es una derrota. Dice que el efecto, si existe, es menor de lo que este sitio puede detectar. La tarea se prorroga una vez hasta el día 59 y después se cierra, porque una prueba que sigue hasta que gana acaba ganando por ruido. Una victoria tampoco genera más experimentos. Abre una idea de replicación para una persona, porque un presupuesto del 5 % de falsas victorias implica que algunas victorias son ruido, y solo una segunda ejecución con familias nuevas permite distinguirlas.
Qué sale mal: el agente que se inventó una crisis
Nuestra peor mañana llegó de un agente que intentaba ayudar. Nuestra revisión diaria se saltó su lista de comprobaciones y escribió su propio informe. Calculó un porcentaje de clics, lo comparó con un «estándar del sector» que nadie le había dado, lo etiquetó como CRÍTICO, recomendó cambios y citó bugs de seguimiento que nunca se habían abierto. Todas las cifras parecían verosímiles. Ninguna salía de una comprobación definida. Archivamos el informe y reescribimos el paso ese mismo día. Aquí lo contamos con datos de Tidewell.
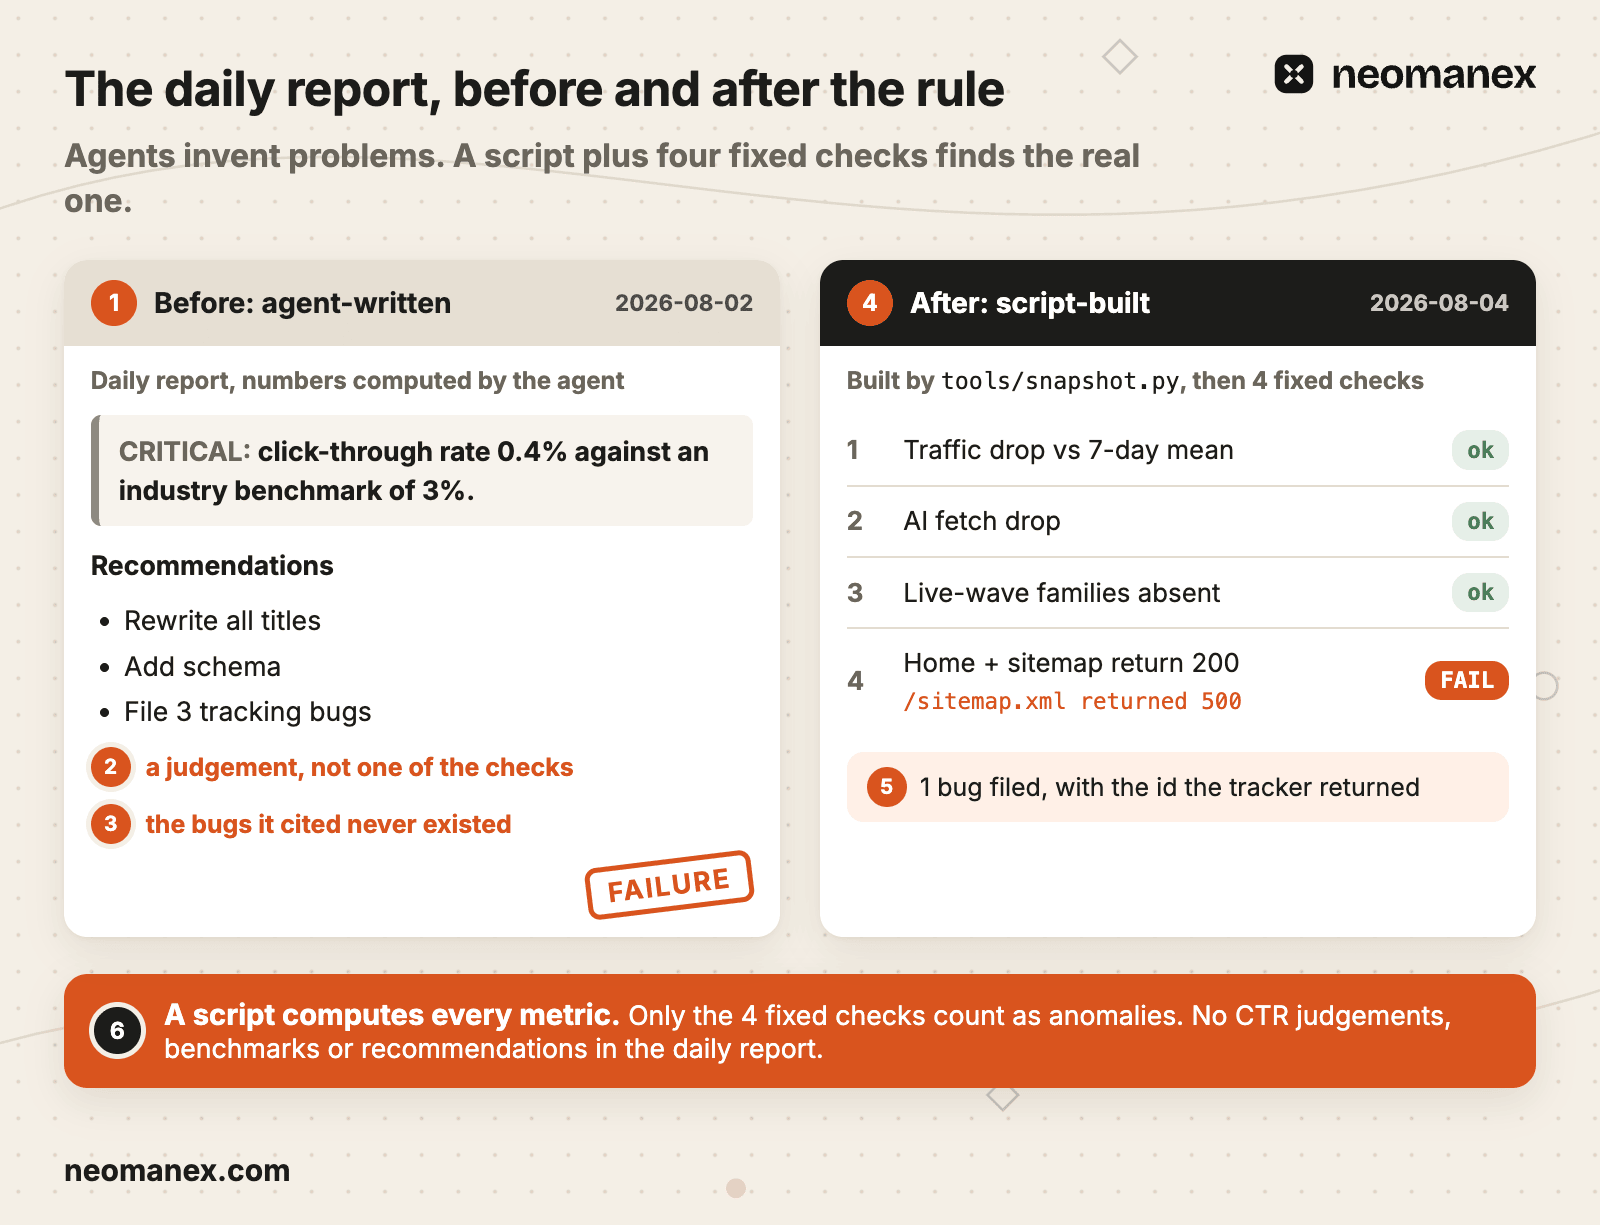
La regla que salió de ahí tiene dos partes. Primero, un script construye la instantánea, y el agente nunca calcula una cifra de la instantánea ni escribe el archivo a mano. Segundo, solo cuatro comprobaciones fijas cuentan como anomalías:
- Las impresiones caen por debajo de la mitad de su media de 7 días.
- Las visitas de rastreadores de IA caen por debajo del 50 % o suben por encima del 300 % de su media de 7 días.
- Una familia de una oleada activa falta en los datos durante 7 días.
- La página de inicio o el sitemap no devuelven HTTP 200 a un rastreador de IA.
Nada de juicios sobre el CTR, posiciones, referencias ni recomendaciones. Un bug solo se cita con el id que devolvió el gestor de incidencias.
El segundo fallo fue más silencioso, y peor. Una versión de un paquete para uno de nuestros sitios llevaba un cambio de producto sin publicar, y reescribió el texto de una de nuestras páginas de control antes del día 0. Un control que cambia ya no es un control: cualquier diferencia que muestre es nuestra propia edición, no la corrección. Lo detectamos antes de la puesta en producción. La regla: una familia tocada después de la asignación pasa a «Excluded after assignment» (excluida tras la asignación) y sale de la comparación.
Monta el tuyo: la versión mínima
No necesitas cinco flujos de trabajo para empezar. Necesitas un repositorio, dos scripts, una plantilla de ficha y una programación diaria.
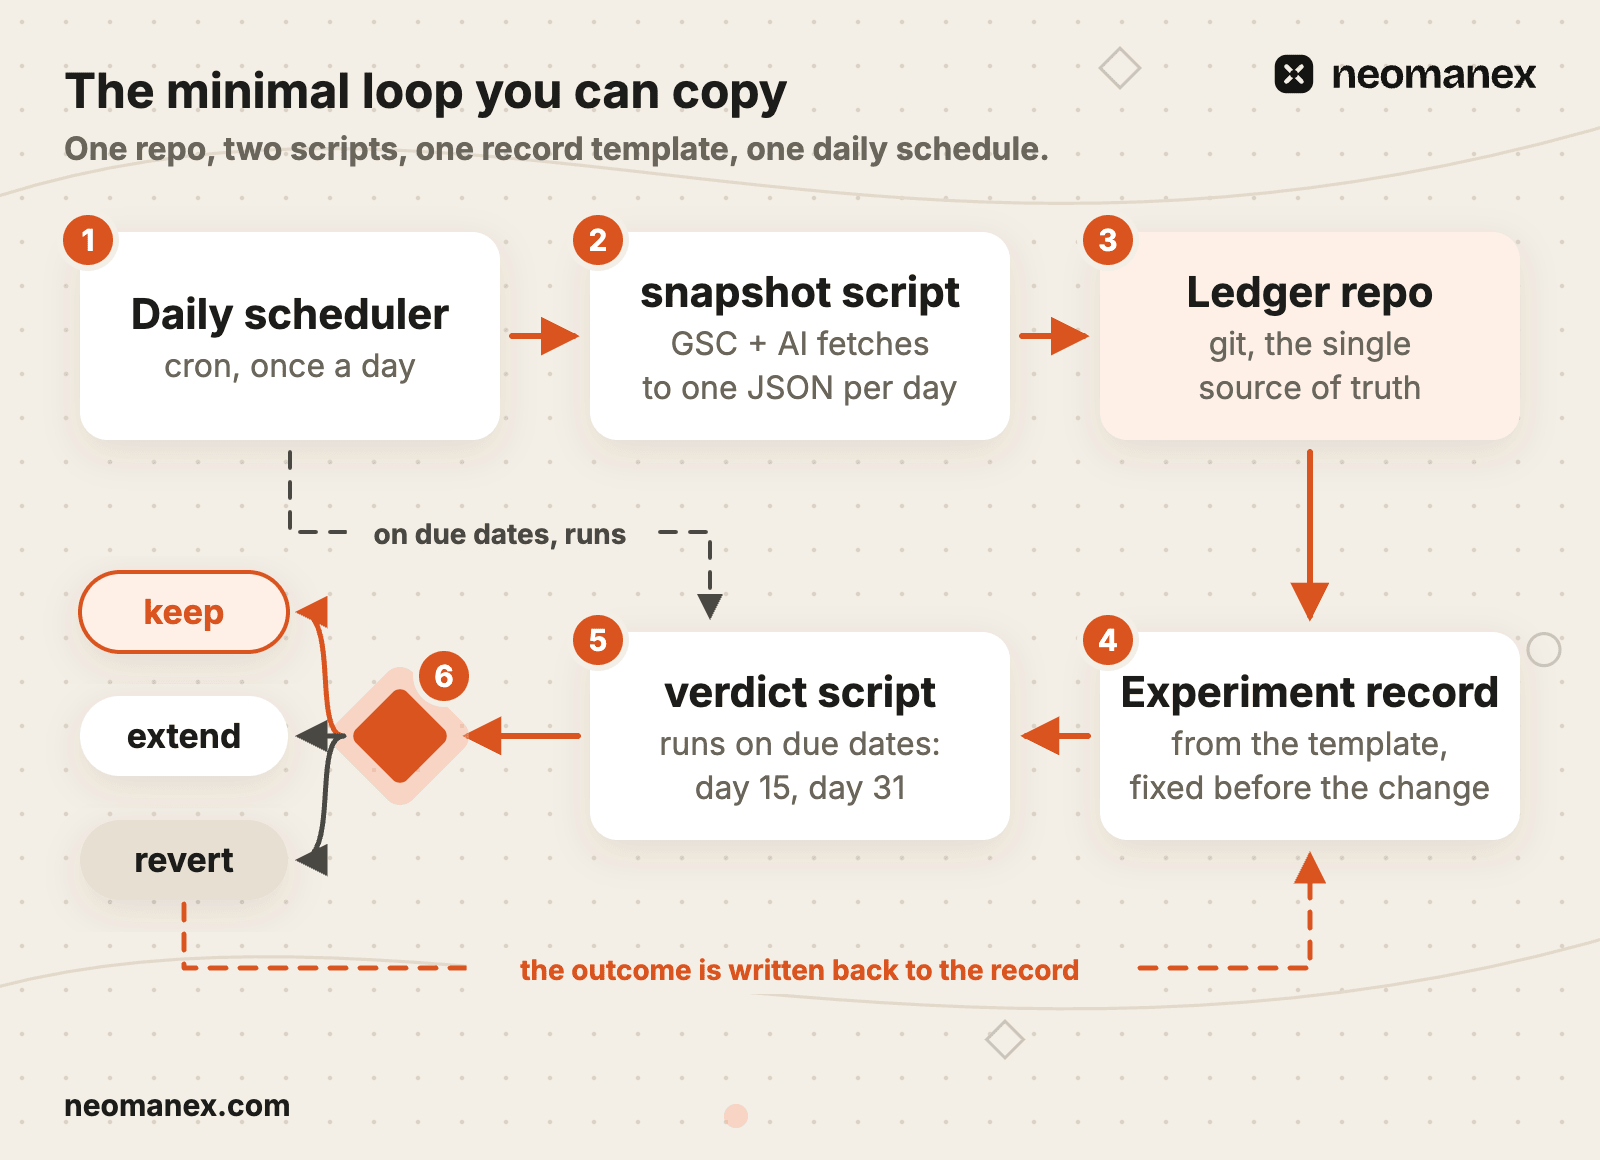
La plantilla de ficha, un archivo por experimento:
---
experiment: exp-0001
site: example
wave: example-2026-01-05
arm: A
fix_type: internal-links
primary_metric: impressions
status: registered
branch: exp/exp-0001
day0: null
interim_due: null
final_due: null
---
Hypothesis:
One falsifiable sentence: what changes, on which treated families, against which control, by day 31.

Falsified if:
The day 31 verdict is not a win under the thresholds fixed in the verdict script.

Families:
treated (15+): ...
control (15+): ...

Baseline (28 days):
treated ... | control ...

Verdicts:
| Look | Date | n treated / control | Ratio | p | Verdict |
|---|---|---|---|---|---|

Lesson:
Copia la plantilla de ficha y después programa el pulso diario en ConvOps(se abre en una pestaña nueva) para que cada experimento se despierte en su fecha de vencimiento.
Pasos
Crea el repositorio de registro
Crea un repositorio git con la metodología, las herramientas y una carpeta por sitio para instantáneas, oleadas, experimentos e informes. Cada ejecución del agente hace commit de su resultado ahí.
Escribe el script de instantáneas
Descarga los datos de páginas de Search Console de hace tres días, porque los días recientes aún no son definitivos, y escribe un archivo JSON por día. Claude Code llama al script y nunca calcula las cifras por sí mismo.
Comprueba qué puedes medir
Cuenta las familias de páginas que tienen tu métrica. Por debajo de 15 familias por grupo, esa métrica no puede sostener un experimento en tu sitio, así que elige otra o espera.
Asigna con un barajado con semilla
Usa la fecha como semilla aleatoria, baraja dentro de grupos de páginas parecidas y reparte las familias por turnos, empezando por el control, hasta que cada grupo tenga 15 o más.
Registra antes del cambio
Copia la plantilla de ficha, escribe una hipótesis falsable y la regla que la descarta, y haz commit antes de que cambie ninguna página.
Cambia las páginas tratadas y haz el merge a mano
Pide a Claude Code que cambie una sola variable solo en las familias tratadas, en una rama. Una persona hace el merge, y el día 0 es el día en que el cambio aparece en el HTML de producción.
Escribe el script de veredicto
Ejecuta una diferencia en diferencias por permutación a nivel de familia con umbrales fijos en el código: victoria, derrota o no concluyente. El agente lee el veredicto y sigue el paso que corresponda.
Programa el pulso diario
Ejecuta un trabajo cada mañana que construya la instantánea, haga unas pocas comprobaciones fijas y despierte cada experimento que venza ese día, en el día 15 y en el día 31.
Preguntas frecuentes
¿Qué es un experimento SEO prerregistrado?
Un experimento SEO prerregistrado es un cambio de página cuya hipótesis, métrica principal, grupos de páginas tratado y de control, línea base y regla de descarte se registran en un commit antes de publicar el cambio. En este bucle, ConvOps ejecuta primero el paso Register: Claude Code copia la plantilla de ficha, escribe una hipótesis falsable y hace commit en el repositorio de registro. Después solo cambian el estado y las fechas, así que el veredicto del día 31 se juzga frente a lo que se prometió.
¿Para quién es un bucle de experimentos SEO?
Un bucle de experimentos SEO es para fundadores y equipos de marketing pequeños que gestionan un sitio de contenido o de producto con poco tráfico y hacen cambios SEO por intuición. ConvOps ejecuta el bucle como tareas programadas, así que cada corrección se mantiene, se prorroga o se revierte según una comparación controlada y no según un gráfico de antes y después. El sitio necesita al menos 15 familias de páginas por grupo en el pool que se prueba, así que un sitio muy pequeño solo puede probar unos pocos tipos de corrección.
¿Puede Claude Code ejecutar experimentos SEO como agente?
Sí. Claude Code es el entorno de ejecución del agente, y ConvOps es la capa de operaciones para agentes de IA que programa cada ejecución y le pone puertas. Claude Code registra el experimento, edita solo las páginas tratadas en una rama, revisa el diff y comprueba que el cambio está en producción. Nunca hace el merge del cambio: lo hace una persona. Tampoco calcula nunca métricas ni veredictos. Eso lo hacen scripts, y Claude Code lee el resultado.
¿Cuánto tráfico necesitan los experimentos SEO?
El suficiente para tener al menos 15 familias de páginas en cada grupo, con la métrica presente en todas. ConvOps ejecuta un planificador semanal que cuenta las familias elegibles por pool y solo abre una oleada cuando una línea base A/A histórica muestra que el pool es lo bastante estable. En un sitio pequeño solo se ven los efectos grandes: en la métrica de visitas de IA, una victoria necesita un ratio de 1,5 o más, y cada métrica tiene sus propios umbrales en el script de veredicto. A esa escala, el porcentaje de clics a menudo no se puede medir.
¿Cuánto tarda un experimento SEO en dar un veredicto?
El veredicto final llega 31 días después de verificar que el cambio está en producción. ConvOps aparca la tarea del experimento hasta su fecha de vencimiento, y el pulso diario la despierta para una revisión intermedia en el día 15. Esa revisión revierte si hay daño, anula si hay una actualización de Google o continúa hasta el día 31, y una victoria clara en visitas de IA con p de 0,0074 o menos detiene el experimento antes de tiempo. Un resultado final no concluyente se prorroga una vez hasta el día 59 y después se cierra.
¿Qué pasa cuando un experimento SEO pierde?
Una derrota significa que las páginas tratadas rindieron peor que las de control. En la métrica de visitas de IA, eso es p de 0,0477 o menos en la dirección perjudicial, un ratio de 0,67 o menos y al menos el 60 % de las familias tratadas por debajo de la mediana del control. Cada métrica tiene sus propios umbrales en el script de veredicto. ConvOps pasa la tarea a su paso Rollback, donde Claude Code prepara la reversión en una rama y una persona hace el merge. La siguiente ejecución que se despierta confirma que la reversión está en producción, y la derrota cuenta en contra de ese tipo de corrección cuando el planificador elige la siguiente oleada.